搜索集群如何应对复杂变更:Operator 的调度、状态机与收敛设计
一次 Elasticsearch 集群变更,背后到底发生了什么?
对使用者来说,扩容可能只是把节点数从 3 改成 5,升级可能只是选择一个新版本。但在系统内部,新增节点要准备资源并加入集群,重启要控制影响范围,缩容还要先迁走数据。如果变更进行到一半,用户又提交了新的目标,系统还要判断原计划是继续、调整,还是先清理再切换。
本文介绍 ES 管控体系中的一个核心组件——Operator。它负责把上层提交的集群目标,转化为一组可执行、可等待、可恢复的集群操作,让复杂变更能够自动、安全地向前推进。
可以把 Operator 理解为搜索集群的“现场指挥”:上层告诉它最终要变成什么样,它根据 Kubernetes 和 Elasticsearch 的实时状态,决定下一步该做什么。
Operator 在 ES 管控体系中做什么
一套完整的 ES 管控系统通常分为多个层次:用户或上层服务发起变更,编排系统生成集群声明,Operator 负责执行节点和集群变更,底层资源系统负责提供计算、网络和存储能力。
在这条链路中,Operator 主要关注两类对象:
·Kubernetes 资源:StatefulSet、Pod、PVC、Service、ConfigMap、Secret 等;
·Elasticsearch 状态:节点是否加入、分片是否迁移、集群是否健康,以及分片分配、节点排除等集群设置。
它不能只看 Pod 是否 Ready。Pod Ready 只说明容器通过了 Kubernetes 的就绪检查,并不代表节点已经重新加入 Elasticsearch;节点重新加入,也不代表分片已经恢复、集群已经重新健康。
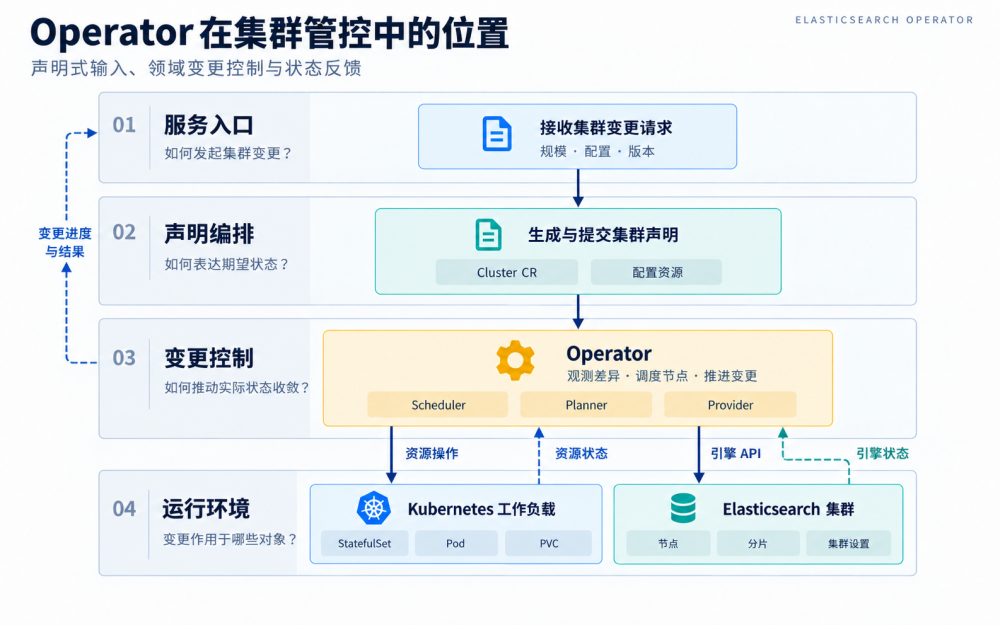
图 1:上层表达集群目标,Operator 协调 Kubernetes 资源和 Elasticsearch 集群,并反馈变更进度。
一个 Operator Manager 中可以运行多个 Controller,分别处理集群、可视化组件和数据接入组件等不同资源。本文聚焦其中最核心的 ES 集群 Controller,以及它如何完成节点变更。
它提供了哪些核心能力
Operator 并不是只负责“拉起 Pod”,它覆盖了 ES 集群运行中的几类关键能力。
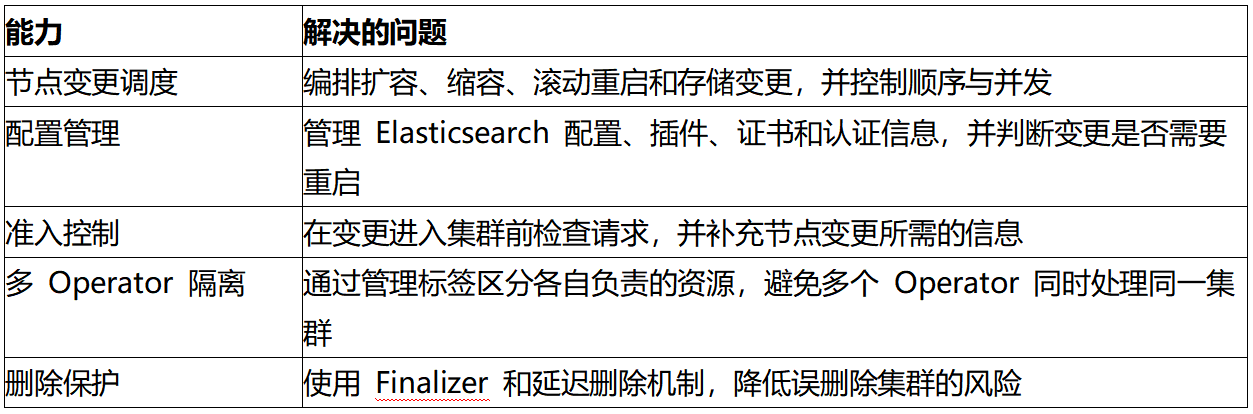
配置管理也不仅是写一份 elasticsearch.yml。集群级配置、节点组配置、插件、安全认证、TLS 证书、JVM 参数和存储声明,最终会落到 ConfigMap、Secret、环境变量和 StatefulSet 等不同载体中。Operator 负责把这些配置组合成节点真正需要的运行环境。
声明式控制:不编排每一步,而是持续逼近期望状态
Operator 采用 Kubernetes 标准的 Reconcile 模式。用户声明期望状态,Controller 每一轮都重新读取集群现状,比较差异,推进当前允许执行的一步,然后等待下一轮继续判断。
这个过程可以概括为:
观察当前状态 → 计算差异 → 执行动作 → 再次观察。
它的价值在于,搜索集群中的许多操作耗时并不确定。数据迁移可能持续几分钟,节点也可能因为资源不足而暂时无法启动。Operator 不会把“已经发起操作”当成“已经完成变更”,而是根据新的观测结果决定继续、等待还是重试。
这种设计同时带来三种能力:声明式控制让用户只描述目标;幂等的调谐循环让失败动作可以重试;Kubernetes 的事件监听机制则让资源变化能够快速触发下一轮处理。
三层架构:处理谁、怎么做、如何执行
节点变更最难的地方,是把“选哪些节点”“按什么步骤变更”和“怎样操作底层资源”同时处理好。Operator 将这三类问题拆成 Scheduler、Planner 和 Provider 三层。
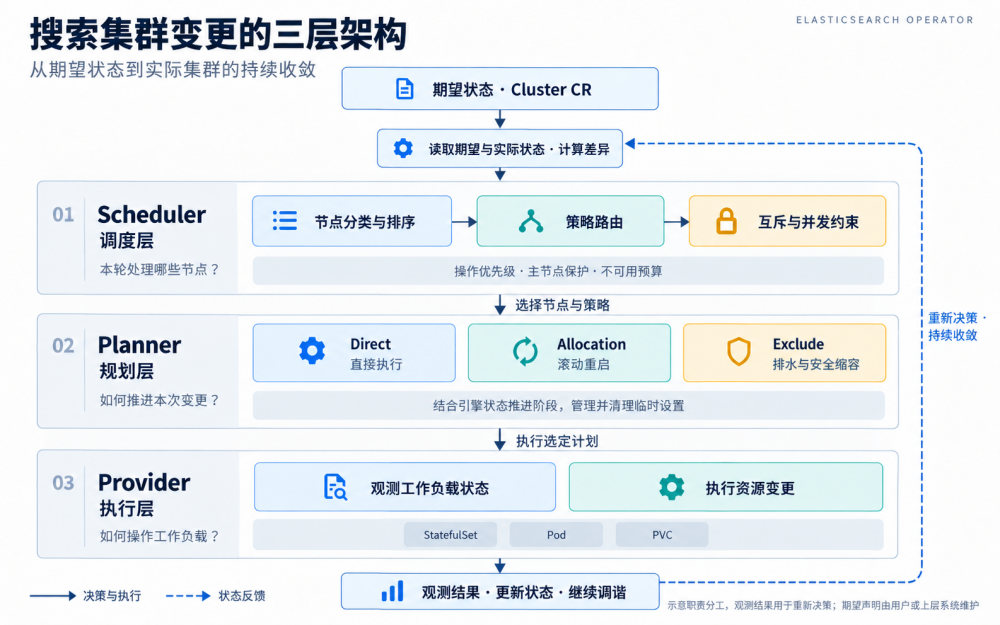
图 2:Scheduler 选节点,Planner 安排变更步骤,Provider 操作工作负载。执行结果会进入下一轮判断。
Scheduler:本轮处理哪些节点
Scheduler 会先把节点分成新增、更新和移除三类,再决定本轮处理的对象。
在常规策略下,新增节点优先于更新,更新优先于安全缩容。这样可以先补充容量,再进行滚动重启,最后释放不再需要的节点。同类操作中,主节点通常放在后面处理,降低变更对集群选主和稳定性的影响。
不同操作的并发方式也不同:扩容可以批量创建;滚动更新受不可用预算约束,按批次推进;安全缩容则需要等待数据迁移条件。Scheduler 还会避免多个 Planner 在同一轮同时修改相互冲突的集群设置。
Planner:这批节点应该怎么变
Planner 把一次节点变更拆成若干阶段。目前主要有三类:
·Direct Planner:处理扩容和允许直接执行的节点操作;
·Allocation Planner:处理滚动重启,协调分片分配设置、节点重启和集群恢复;
·Exclude Planner:处理安全缩容,先排水,再移除节点并清理设置。
Planner 并不是按照固定时间表往前走。每一轮都会根据节点、分片和集群健康重新判断当前阶段,所以同一个阶段可能等待多轮,也可能在条件已经满足时直接跳过。
Provider:把计划落实到工作负载
Provider 负责读取节点对应的工作负载状态,并执行实际资源操作。扩容时创建或扩大 StatefulSet;更新时触发目标 Pod 重建;缩容时调整副本数,并处理相关存储资源。
三层拆分以后,调度规则、变更流程和资源实现可以分别演进。新增一种发布方式时,通常可以复用既有 Scheduler 和 Provider,在 Planner 层补充新的变更策略。
滚动重启和安全缩容如何推进
滚动重启通常用于版本升级、镜像变化或需要重启才能生效的配置变更。Operator 先检查集群健康和不可用预算,再选择一批节点执行操作。
在适用场景下,它会临时调整分片分配设置,减少节点短暂离线期间不必要的分片搬迁。Pod 重建后,Operator 继续等待节点重新加入 Elasticsearch,清理临时设置,并确认集群恢复,再处理下一批节点。
安全缩容多了一个数据排水过程。Operator 先设置节点排除,引导分片离开目标节点;满足配置的迁移条件后,再调整 StatefulSet 规模。节点移除以后,还要清理排除设置,并等待集群恢复。涉及主节点时,还需要处理相应的投票排除设置。
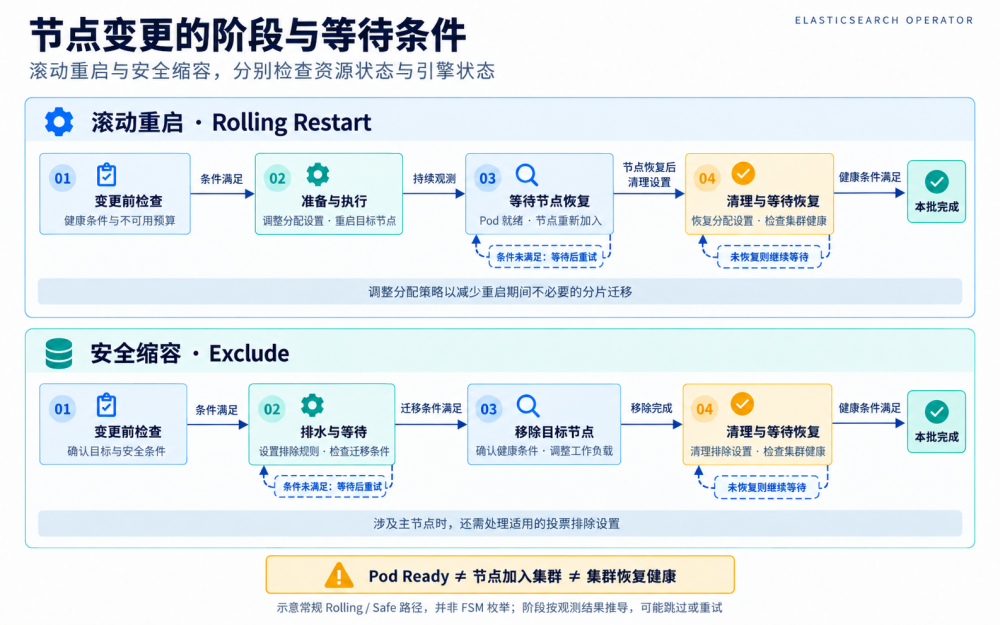
图 3:滚动重启和安全缩容都要经过检查、执行、等待和恢复。Pod Ready、节点加入和集群健康需要分别判断。
一个混合变更的例子
假设用户一次提交了三项调整:NodeSet A 新增两个节点,NodeSet B 修改配置并滚动重启,NodeSet C 减少一个节点。
Operator 首先建立新增容量,等待 A 的新节点达到策略要求的就绪状态。随后分批更新 B,每批节点完成重启、清理和恢复后,再继续下一批。最后处理 C 的安全缩容,完成数据排水、节点移除和集群恢复。
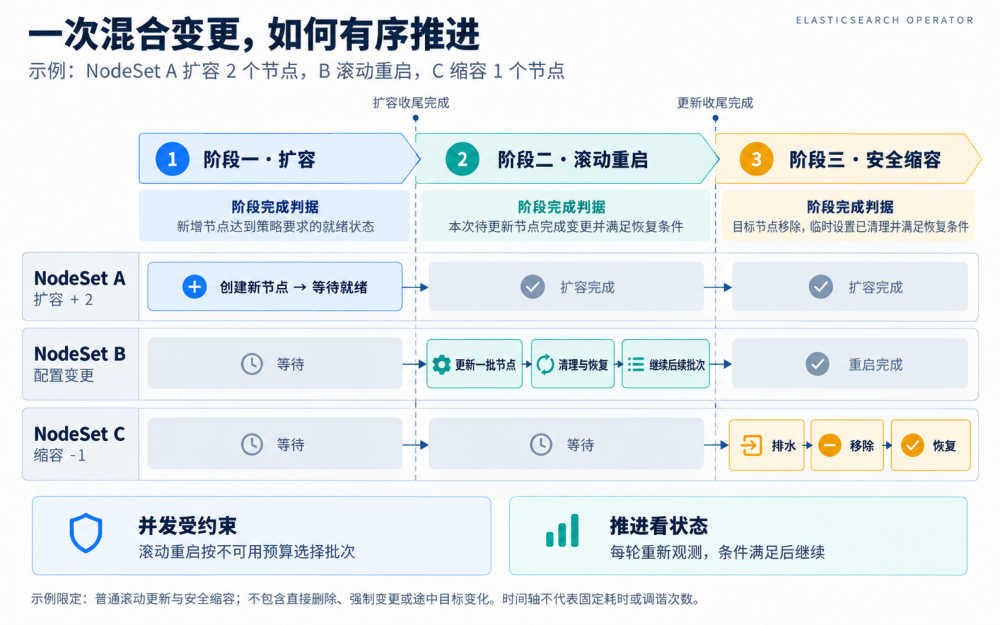
图 4:混合变更的典型推进顺序。时间线表达的是先后关系,不代表固定耗时或固定调谐次数。
这里的重点不是把所有操作机械地排队,而是控制同一时刻的影响范围。先补充容量,可以给后续更新和数据迁移留出空间;更新完成后再缩容,也能避免在集群能力下降时继续叠加风险。
变更途中,用户又修改了目标
长时间变更期间,用户可能再次修改节点数量、配置或版本。Operator 不会简单地“硬停”当前流程,而是在下一轮调谐中重新计算每个节点应该进入哪个 Planner。
如果节点仍然适合由原 Planner 处理,就继续推进。如果它需要切换到其他 Planner,或已经不再需要变更,旧 Planner 会先清理自己留下的 Elasticsearch 设置,例如恢复分片分配或清除节点排除,然后清除节点的旧计划归属。
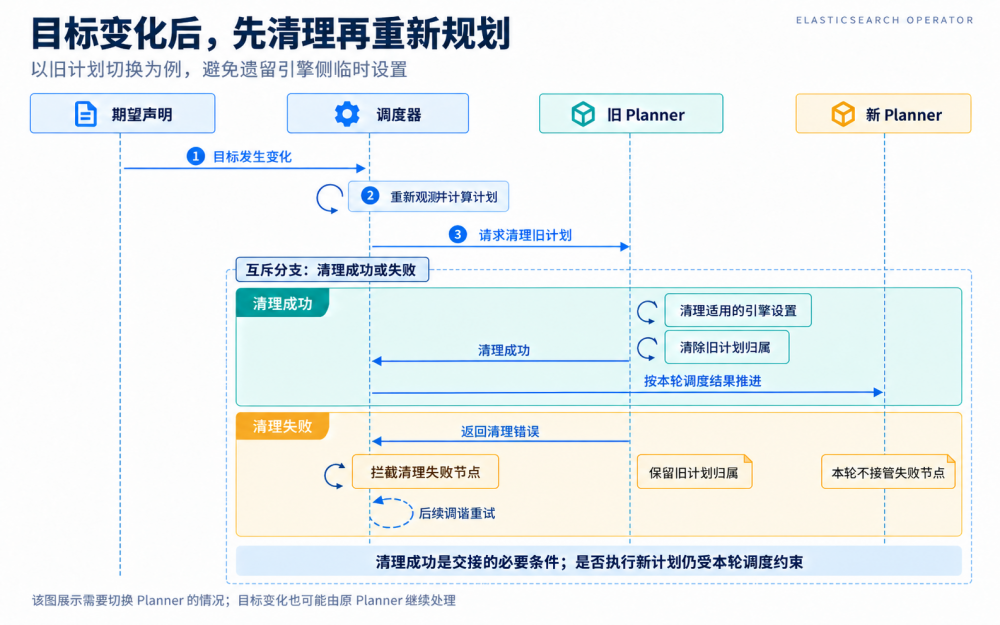
图 5:需要切换 Planner 时先清理旧计划。清理成功和失败是两条互斥路径。
只有清理成功,节点才允许交给新计划;如果清理失败,它会保留原计划归属,本轮不进行交接,等待后续调谐重试。这样可以避免旧设置还在生效时,新计划又叠加一组新的控制动作。
重新规划也不等于把已经发生的一切倒回去。已经迁走的数据不会自动迁回,Operator 会以当前真实状态为起点,继续向新的目标收敛。
结语
Operator 是 ES 管控体系中真正推动集群发生变化的组件。它既要理解 Kubernetes 资源,也要理解 Elasticsearch 的节点、分片和健康状态;既要完成正常的扩缩容和升级,也要应对资源等待、操作重试以及变更途中目标再次变化。
它的核心思路并不复杂:
·用 Scheduler 控制本轮处理范围;
·用 Planner 管理变更步骤和安全条件;
·用 Provider 执行底层资源操作;
·用持续调谐不断校正下一步决策。
复杂之处被留在组件内部,用户只需要描述目标。这正是声明式管控的价值,也是搜索集群能够持续演进的重要基础。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)