
随着端侧大模型、多模态交互和本地AI推理需求不断增长,瑞芯微推出了面向更大规模算力需求的RK182X系列AI协处理器,包括RK1828和RK1820,主要面向VLM、LLM及多模态推理加速。一块RK182X算力棒可提供约20TOPS@INT8 AI算力,配备5GB 3D堆叠内存,可通过PCIe等连接方式与RK3588、RK3576等主控平台协同工作。
定昌电子的RK3588开发板已适配RK182X算力棒,并提供固件支持。以RK3588评估底板DC_CM588为例,同时接入两片RK1828后,理论AI算力可达到46TOPS。本文介绍双RK1828算力棒的硬件连接、独立供电、散热、部分系统适配调试及设备识别方法,并重点解析双模组并行推理的两种实现方式。
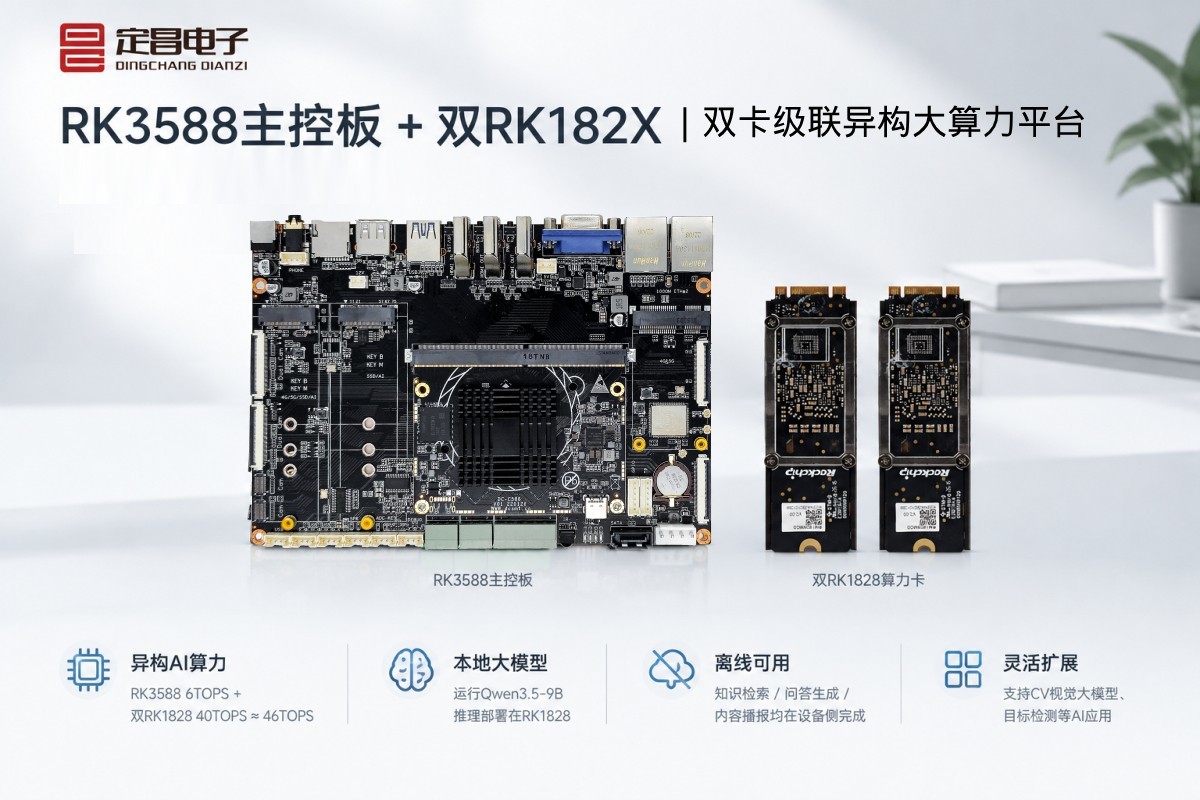
定昌的双RK1828方案核心信息:
主控平台:RK3588评估底板DC_CM588
AI协处理器:双RK1828算力棒
单模组算力:约20TOPS@INT8
双模组理论算力:46TOPS
开发环境:Debian 12、Ubuntu 24.04等系统参考方案
一、硬件介绍
定昌电子DC_CM588主控板+双RK1828算力卡方案,两颗 RK1828 各提供约 20TOPS@INT8 AI 算力,通过 M.2 PCIe 接口连接主控板,算力最高可达 46TOPS,另外还支持双卡级联,目前实现Qwen3.5-9B,Lamma4-12B的模型本地部署,可用于本地问答、企业知识库、语音交互及多模态分析,另外也实现多类 AI 应用案例。在多路视频 AI 分析,将 YOLO 目标检测等任务分配至 RK182X 算力模块,多路 1080P 视频流并发AI分析;在视觉大模型部署方面,已提供 YOLO 目标检测结合 Qwen3-VL-2B 的方案参考,实现目标快速识别与图像语义理解相结合;还有OpenClaw 本地部署案例等。
二、硬件连接
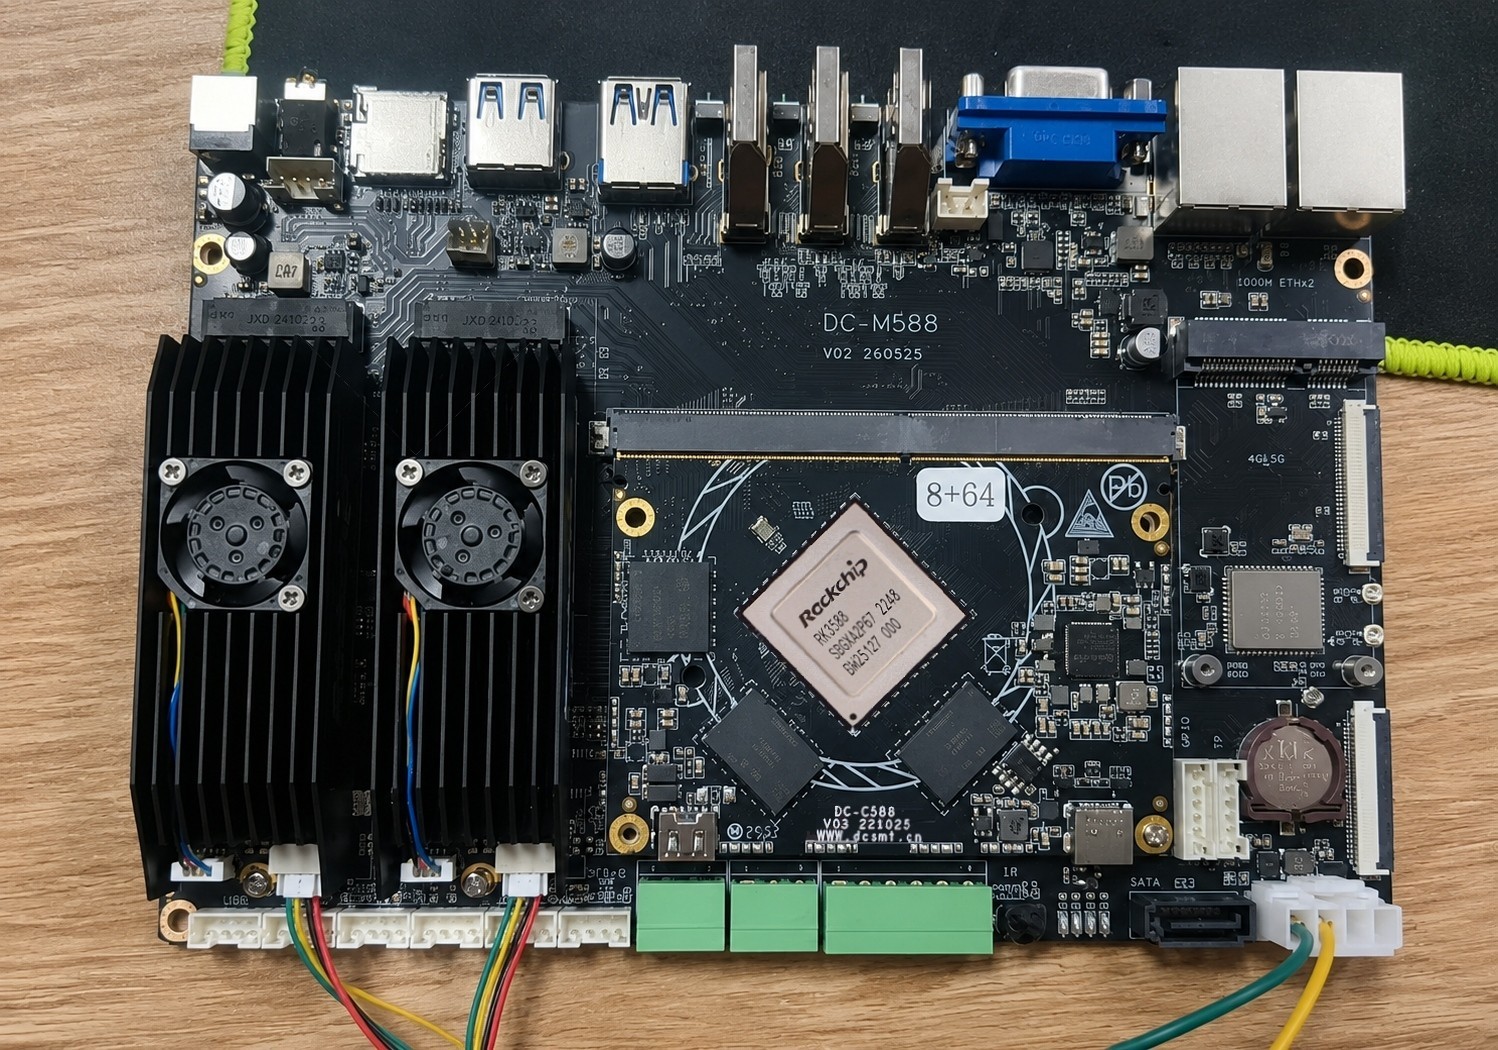
在这套异构计算架构中,RK3588负责操作系统运行、网络通信、视频管理和应用调度,RK1828负责AI计算,两者通过PCIe连接,形成主控与AI协处理器协同工作的硬件架构。硬件连接时,需要重点检查以下事项。
1、独立供电
RK182X算力棒需要连接配套的12V供电线单独供电,定昌会提供相应线材。主板与两片算力棒同时运行时,建议使用12V 5A及以上的电源适配器,并结合实际整机功耗确认供电余量。
2、散热管理
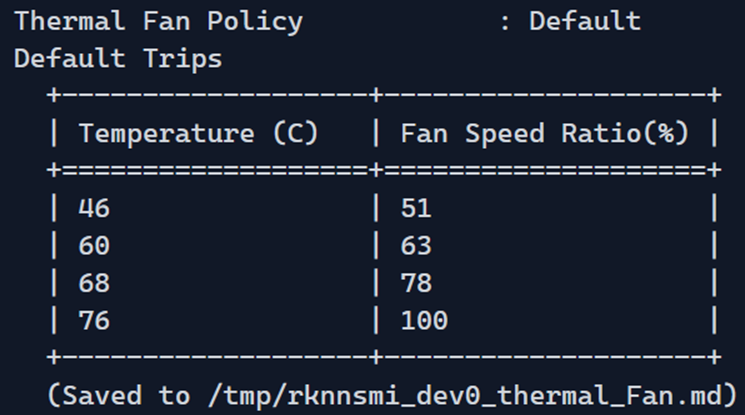
模组风扇采用温控策略,启动时可能短暂转动,然后会根据温度决定是否运行。部署高负载模型时,应确保设备风道通畅,避免算力棒长时间高负载运行时因散热不足而影响性能
3、PCIe接口
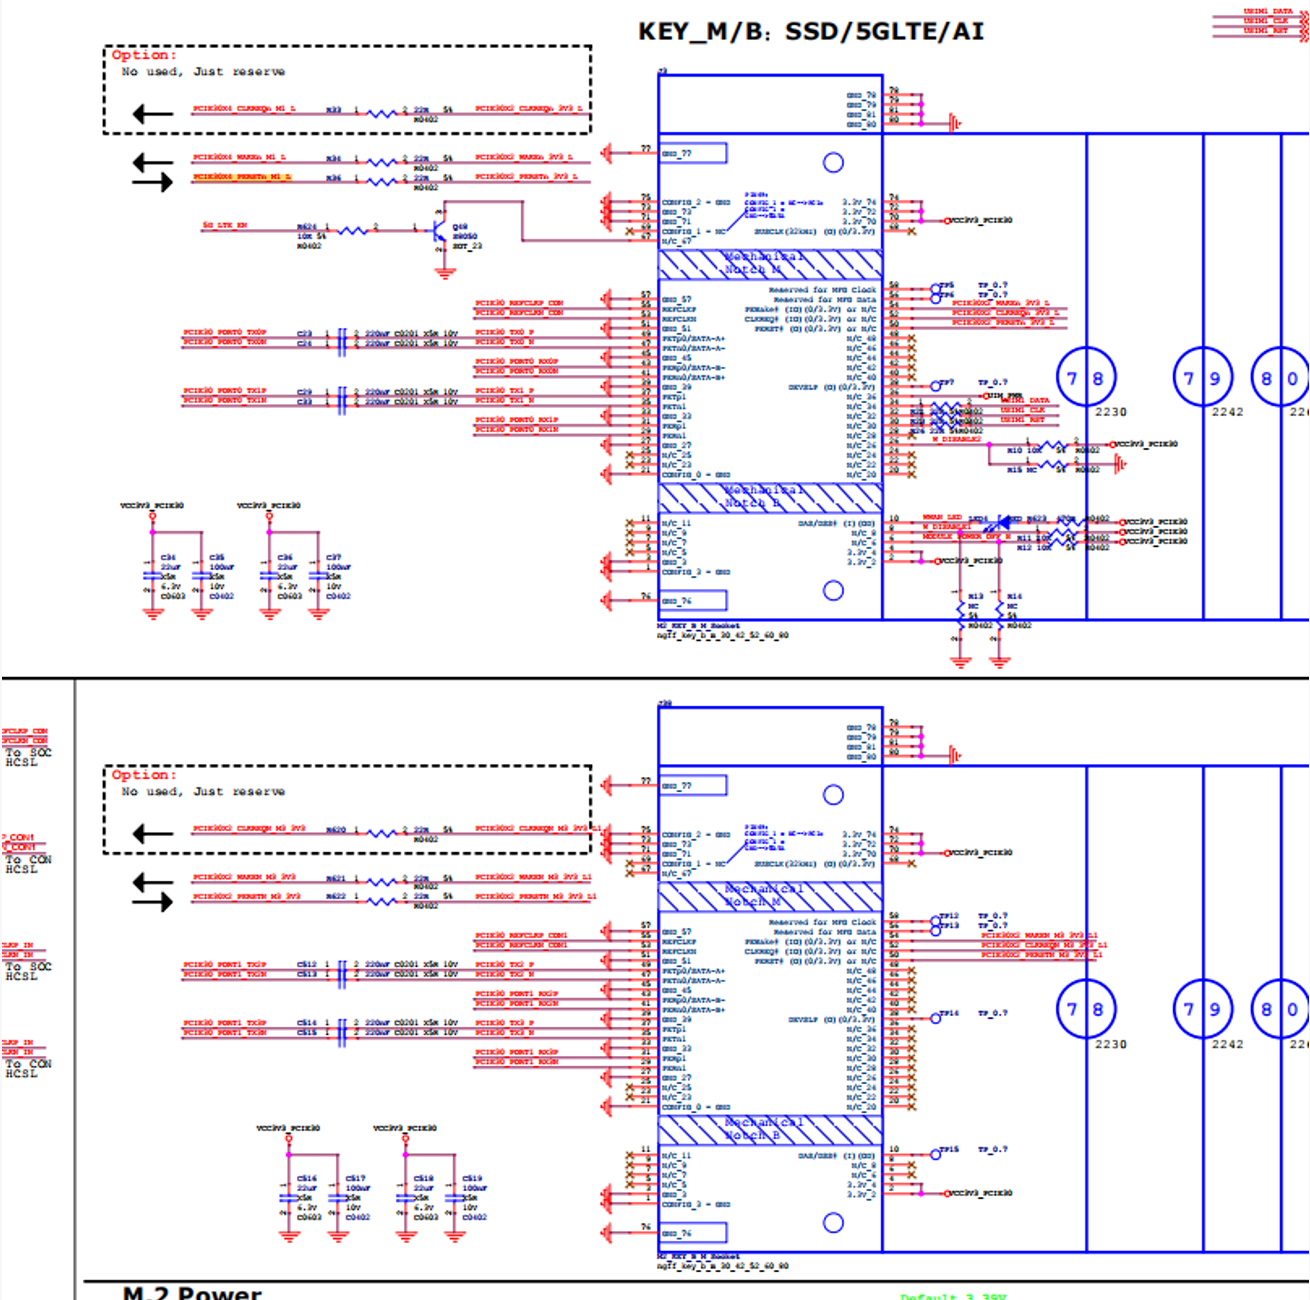
RK182X主流通过PCIe连接主控板,双模组方案还需核对实际原理图及PCIe控制器的分配方式,确保两个模组都能正常连接与识别。
4、固件支持
需要烧录已集成RK182X驱动的系统固件。可以在发货时指定固件,也可以向定昌电子技术支持人员获取对应版本。
三、系统适配调试
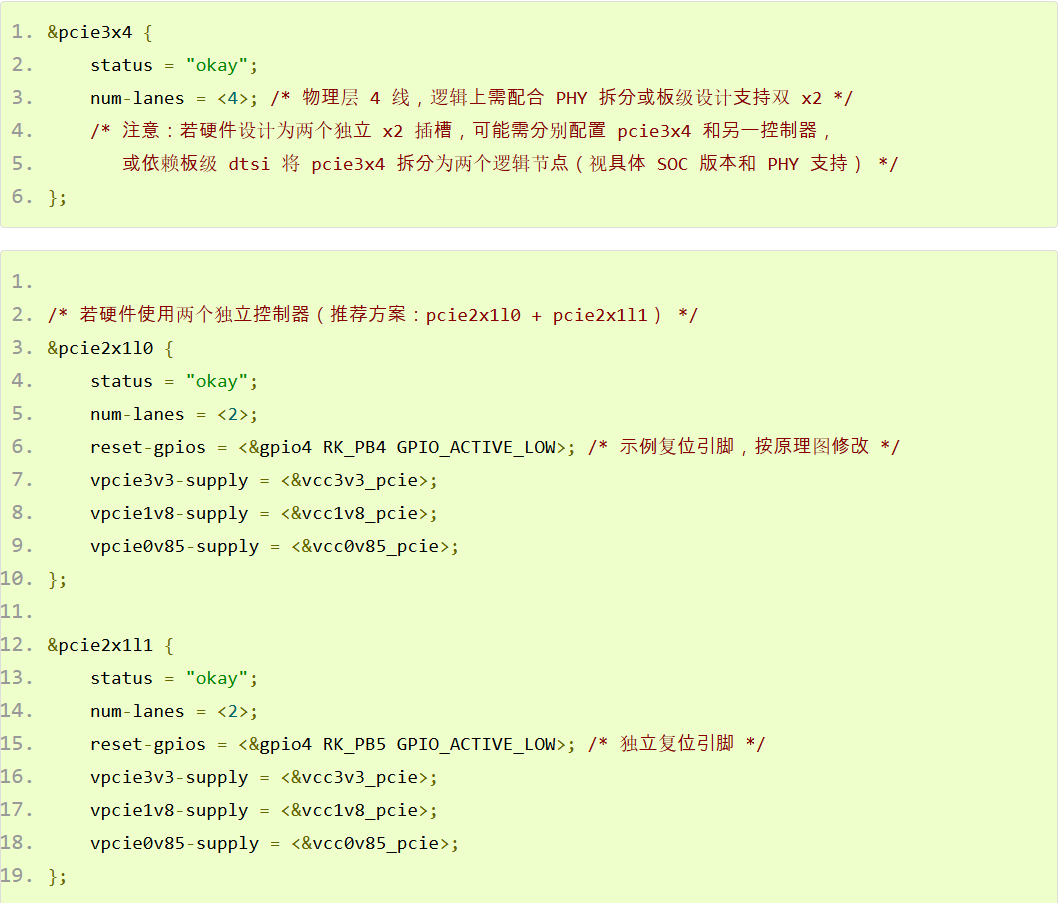
针对AI算法开发,定昌电子提供了基于RK3588与RK182X的Debian 12、Ubuntu 22.04等系统固件参考。开发前应确认固件版本、内核驱动和RKNN3运行环境相互匹配。设备树(DTS)配置需要根据原理图调整,模组接线原理图如下:
系统适配重点
固件:使用匹配DC_CM588及RK182X的系统版本。
驱动:确认内核中的PCIe及RK182X相关驱动已集成。
运行环境:核对RKNN3运行库、模型转换工具与模型版本。
核心参考DTS配置demo如下:
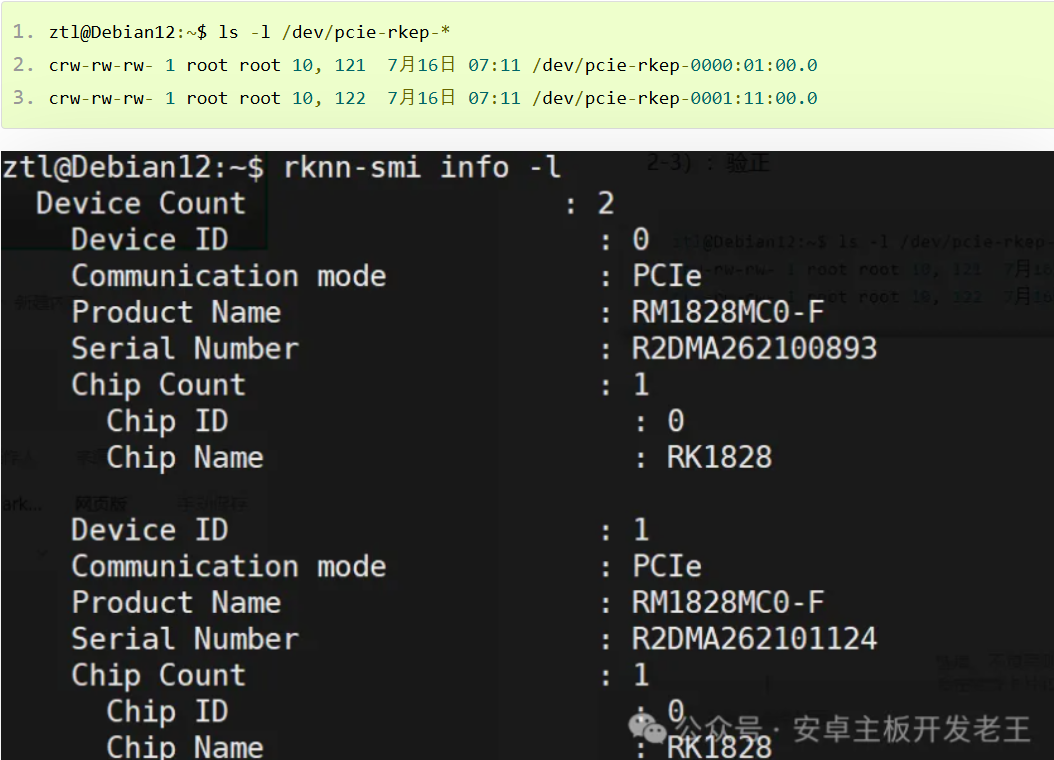
验证:
四、双模组并行推理
双RK1828可以让多个AI任务并行运行。常见方式主要有两种,实际采用哪一种,需要根据模型结构、SDK能力和推理框架的支持情况决定。
方式一:不同模型分配到不同模组
例如,RK1828设备ID 0运行语音识别模型,设备ID 1运行文本生成模型;也可以分别承担目标检测和视觉理解任务。
应用程序通过SDK指定设备ID,将任务提交给对应模组。这种方式可让两片算力棒分别执行不同任务,发挥多模组并行处理的能力。
方式二:同一模型拆分部署
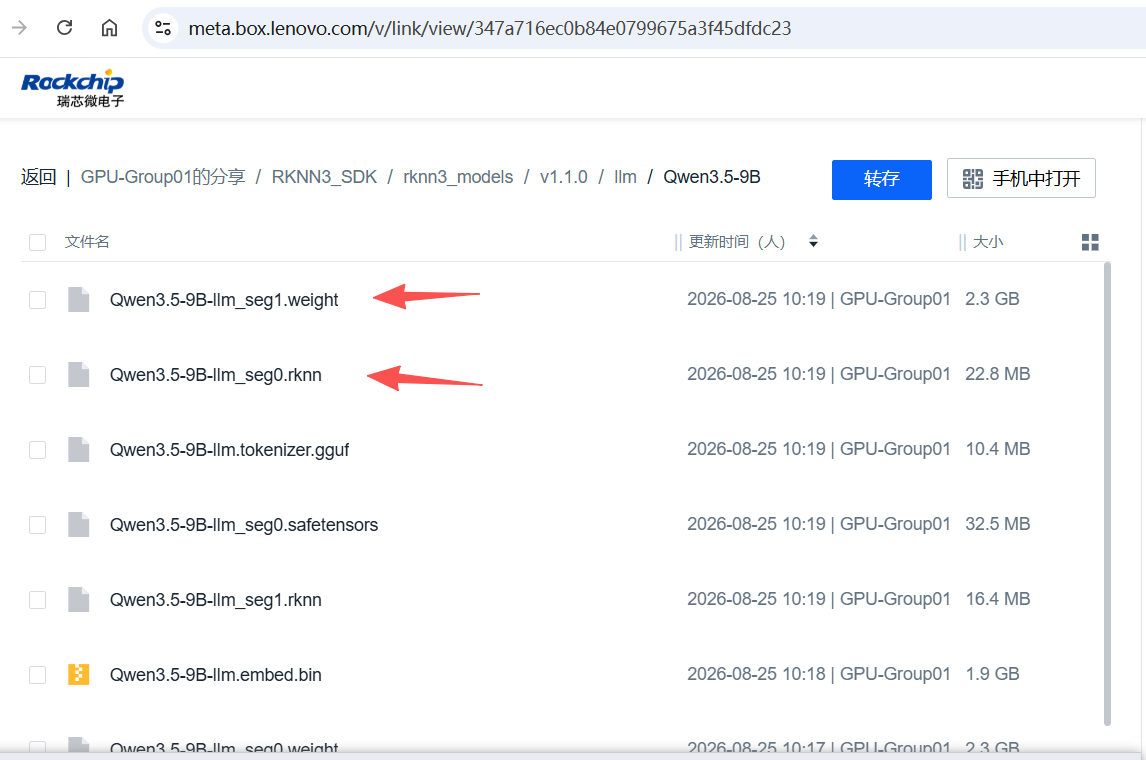
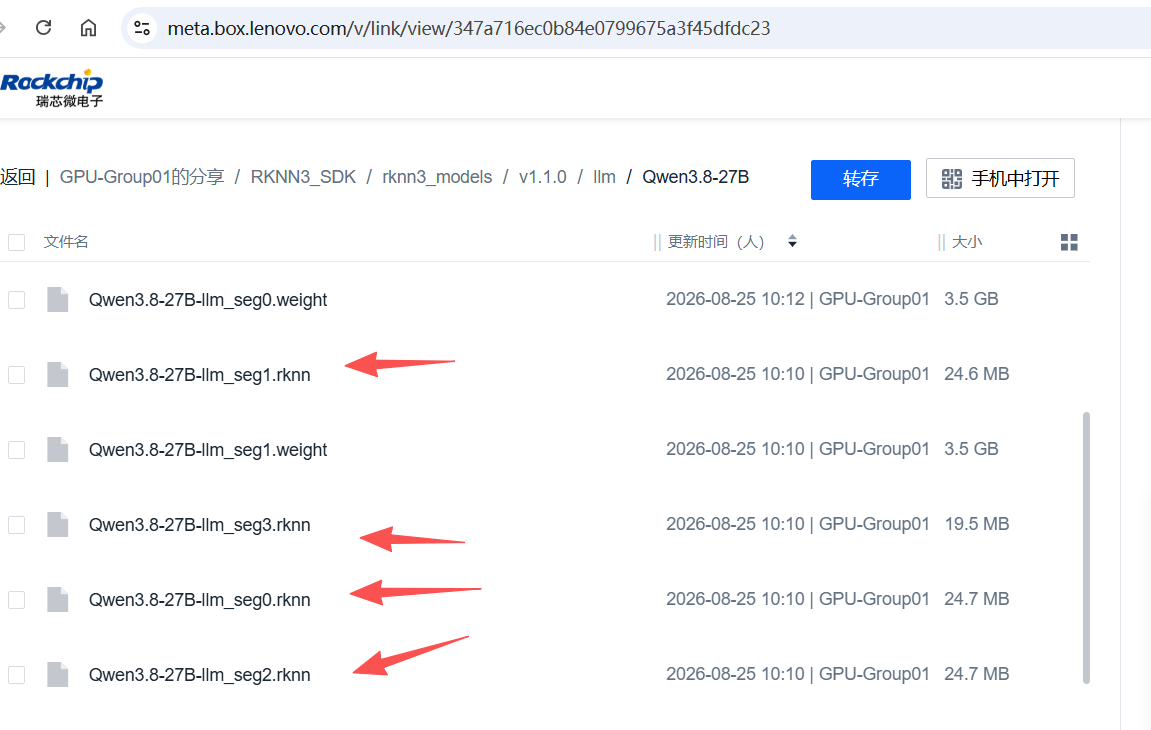
对于较大的模型,可以根据模型转换工具和运行时的支持,将模型划分为多个分段。例如,Qwen3.5-9B-LLM拆分成seg0、seg1,或者Qwen3.8-27B-LLM拆分成四个seg0~seg3,再部署到单片或多片算力模组上执行。
这种方式需要模型本身支持相应的分段方式,并由SDK或推理框架负责张量传递、分段调度和结果合并。
并行推理注意事项
并非所有模型都能直接拆分到两张算力卡上,也不能简单地将两个设备的算力相加后,就认为单模型推理速度会翻倍。应根据实际模型结构、部署方式和测试结果评估性能提升。
五、RK182X SDK模型支持
定昌电子目前固件也升级到了RK182X SDK 1.1.0版本进一步增强了端侧大模型的部署能力,重点升级多卡级联推理机制,可支持更大规模的模型部署,包括Gemma4-12B、Qwen3.5-9B等,为复杂的本地AI应用提供更多选择。
在模型生态方面,新版本扩展了全模态、多模态及视觉模型的支持范围。目前提供的测试数据,各模型性能如下:
部分模型性能数据
Qwen3-Omni:86 TPS
Qwen3.5-Omni:62 TPS
Gemma4-12B:30 TPS
Qwen3.5 4B:50 TPS
Qwen3.5 9B:35 TPS
Dream-Lite文生图:约3.1秒
LocateAnything-3B:102 TPS
以上数值为原文提供的测试数据。实际运行速度会受到模型版本、量化方式、上下文长度、输入数据、运行框架和硬件配置等因素影响,项目部署时建议按照实际应用条件进行测试。
六、Demo演示:Qwen3-ASR多模型部署
RK3588+RK1828算力方案继续进行Qwen3-ASR模型部署,涉及Qwen3-ASR-1.7B和Qwen3-ASR-0.6B等模型。
示例中给出的最大上下文长度宏定义为:
#define MAX_CONTEXT_LEN 1024*24
加载多个模型时,原文提供的params.json示例如下。这里保留了Qwen2.5-0.5B和Qwen3-0.6B两个模型配置,方便参考多模型配置的字段组织方式。
{
"host": "127.0.0.1",
"port": 8080,
"timeout": 30,
"models": {
"Qwen2.5-0.5B": {
"alias": "Qwen2.5-0.5B",
"model": "Qwen2.5-0.5B-Instruct.rknn",
"weight": "Qwen2.5-0.5B-Instruct.weight",
"model2": "",
"weight2": "",
"model3": "",
"weight3": "",
"vocab": "Qwen2.5-0.5B-Instruct.tokenizer.gguf",
"embed": "Qwen2.5-0.5B-Instruct.embed.bin",
"mel-filter": "",
"lora-weight": "",
"ctx-size": 1024,
"predict": 512,
"temp": 0.8,
"top-k": 1,
"top-p": 0.8,
"repeat-penalty": 1.1,
"presence-penalty": 1.0,
"frequency-penalty": 1.0,
"img-start": "",
"img-end": "",
"img-content": "",
"audio-start": "",
"audio-end": "",
"audio-content": "",
"img-width": 0,
"img-height": 0,
"chat-template-file": "",
"embedding": false,
"record-path": "",
"reasoning-format": "none",
"reasoning": "auto",
"n-session": 1
},
"Qwen3-0.6B": {
"alias": "Qwen3-0.6B",
"model": "Qwen3-0.6B.rknn",
"weight": "Qwen3-0.6B.weight",
"model2": "",
"weight2": "",
"model3": "",
"weight3": "",
"vocab": "Qwen3-0.6B.tokenizer.gguf",
"embed": "Qwen3-0.6B.embed.bin",
"mel-filter": "",
"lora-weight": "",
"ctx-size": 1024,
"predict": 512,
"temp": 0.8,
"top-k": 1,
"top-p": 0.8,
"repeat-penalty": 1.1,
"presence-penalty": 1.0,
"frequency-penalty": 1.0,
"img-start": "",
"img-end": "",
"img-content": "",
"audio-start": "",
"audio-end": "",
"audio-content": "",
"img-width": 0,
"img-height": 0,
"chat-template-file": "",
"embedding": false,
"record-path": "",
"reasoning-format": "none",
"reasoning": "auto",
"n-session": 1
}
}
}
七、开发资料与应用
RK182X算力棒生态提供了模型转换、量化和端侧推理相关工具。开发者可以参考以下开源仓库,了解工具链、模型示例和部署方式。可咨询官方客服获取下载链接。
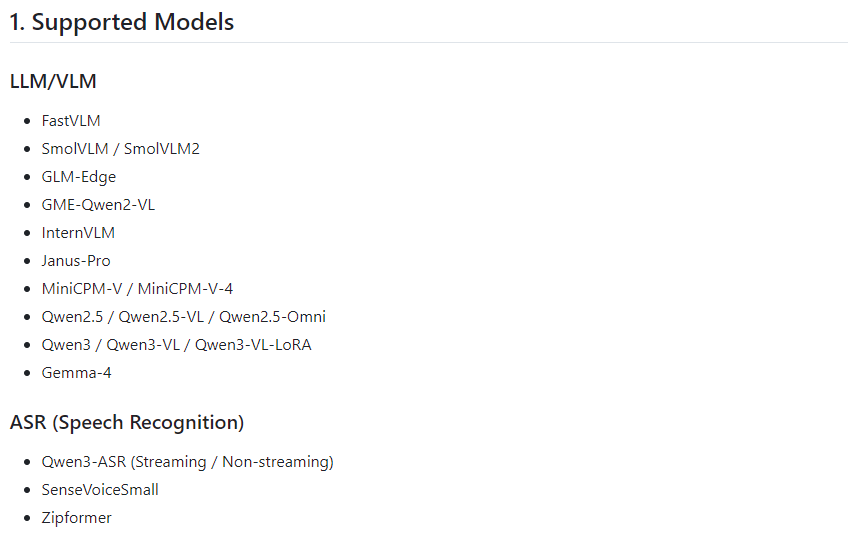
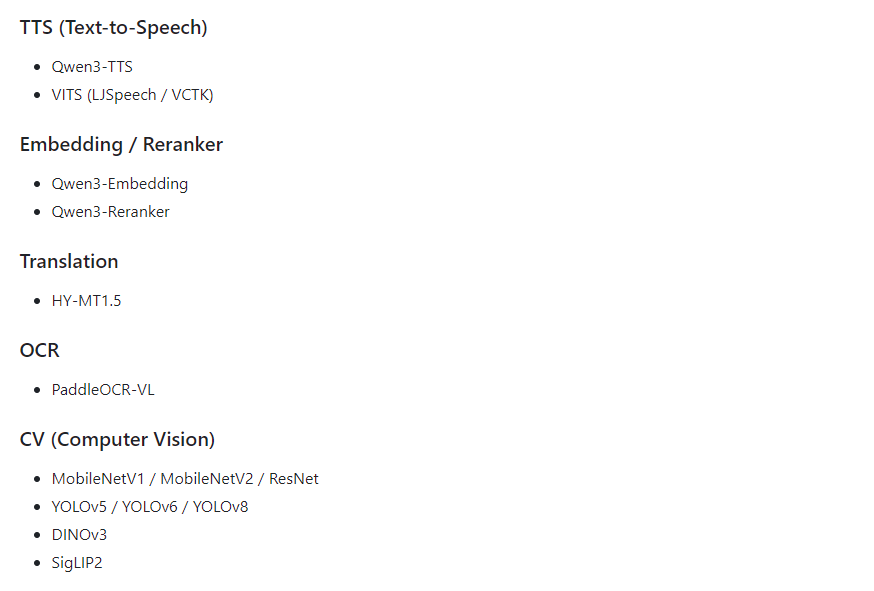
通过配套工具链,开发者可以参考CNN、LLM、VLM以及YOLO、Qwen等模型的部署示例,逐步完成模型转换、量化、设备部署和性能测试。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)