
为什么要用API而不是网页版
网页版的局限
模型选择受限:通常只能使用该平台提供的模型,难以根据任务需要自由切换不同厂商的模型。
工作环境受限:主要在浏览器中使用,与本地文件、开发环境及其他工作软件的集成能力相对有限。
成本管理不够灵活:网页版通常采用免费与付费订阅相结合的模式。免费版的模型能力和使用额度有限,付费版则通常需要购买固定的订阅套餐,难以按照实际使用量灵活计费。
API适用场景
相比直接使用网页版AI模型,通过 API 接入模型更适合以下需求场景:
多模型使用:需要根据不同任务,在 GPT、Claude、Gemini、DeepSeek、Kimi 等模型之间灵活切换。
复杂任务处理:需要结合本地文件操作、工具调用、联网搜索等能力,完成科研、写作、数据分析、软件开发等复杂任务。
弹性使用需求:使用频率或用量波动较大,希望按实际用量付费,而非购买固定订阅套餐。
精细化管理:希望针对不同任务分配独立的API Key、设置消费限额,并精细化追踪每条请求的实际调用情况及其计费。
自定义配置:需要自定义模型参数、系统提示词、Skills、MCP 等配置。
自动化与系统集成:需要执行批量处理、定时任务、多步骤任务,或将大模型能力集成到自研应用、企业内部系统或其他第三方工具中。
基本概念
接口地址
接口地址是应用程序访问大模型服务的网址。当我们在 WorkBuddy 等工具中发送消息时,工具会通过接口地址将请求发送给模型服务,并接收模型返回的结果。不同服务商通常有不同的接口地址,而第三方聚合平台(比如OpenRouter、非线智能等)可以通过统一的接口地址提供多种模型服务。
API Key
API Key 是调用大模型 API 时使用的身份认证凭证,相当于一把专属的【数字钥匙】。每次调用模型时,平台都会通过 API Key 验证调用者的身份,并记录相应的使用量和费用。由于 API Key 通常与账户余额或调用权限关联,因此需要妥善保管,避免泄露。
Token
Token 是大模型处理文本的基本单位,相当于模型阅读和生成文字时使用的【计量单位】。一个汉字或一个英文单词不一定等于一个Token,可能对应多个Token。大模型的上下文长度和 API 使用费用通常都以 Token 为单位计算。
上下文长度
上下文长度是指大模型在一次请求中能够处理的信息量上限,可以理解为模型的【短期工作记忆容量】。它通常包括当前问题、历史对话、系统提示词以及模型生成的内容。例如,支持 128K 上下文的模型,单次请求最多可以处理约 12.8 万个 Token。上下文越长,模型通常就能同时参考更多信息,但不一定能准确记住或理解所有内容。
Token计费(输入 / 输出 / 缓存)
输入 Token 是每次调用模型时,发送给模型的内容所消耗的 Token 数量,可以理解为模型需要阅读的信息量。除了用户当前输入的问题,还可能包含历史对话、系统提示词、文档内容以及工具返回的结果。因此,即使只发送一句简单的问题,如果附带了大量系统提示词或历史上下文,也可能产生较多的输入 Token。典型例子是WorkBuddy的新会话第一轮问答有数万的输入Token。
输出 Token 是模型在处理请求时生成的 Token 数量,可以理解为模型思考和回答所消耗的内容量。除了最终展示给用户的文字,一些推理模型还会产生额外的内部推理 Token,这些也会计入输出用量。因此,即使模型最终只回复了几句话,实际消耗的输出 Token 也可能更多。输出 Token 的单价通常高于输入 Token。
缓存 Token 是指模型服务通过缓存机制复用的输入内容,可以理解为模型重复阅读时可以直接复用的信息。当多次请求包含相同的历史对话、系统提示词或文档内容时,模型可以复用此前处理过的部分内容,减少重复计算。缓存通常具有一定的有效期(TTL),例如 5 分钟,如果超过有效期且没有刷新,缓存可能失效,后续请求就需要重新计算相关内容。缓存命中的输入 Token 通常享有更低的计费价格,部分模型还会对缓存写入单独收费。
模型怎么选
不同厂商不同系列的大模型在推理能力、编程能力、多模态支持、响应速度和价格等方面各有特点,没有绝对的优劣。建议先从性价比较高的模型入手,遇到复杂任务时再尝试更高性能的模型。如果不知道选哪个模型,推荐从 DeepSeek V4.1 Flash 开始。
DeepSeek系列
深度求索公司推出,以较高的性价比受到广泛关注。兼顾综合能力、响应速度和使用成本,能够满足日常问答、文档写作、数据分析和一般编程等多种需求。
GPT系列
OpenAI公司推出,特点是综合能力较为全面,在逻辑推理、编程、科研、数据分析方面表现突出,有较好的指令遵循和计算机使用(Computer Use)能力。适合需要深度调研、推理以及自动化浏览器和桌面软件操作的用户。
Claude系列
Anthropic公司推出,在编程、创意设计、数据分析方面表现突出,有较好的意图理解能力。适合内容创作和开放任务场景的用户。
Gemini系列
Google公司推出,拥有原生多模态能力(文本、图片、视频、音频)、丰富的世界知识和优秀的写作能力。适合需要深度写作和处理多类型素材的用户。
“AI工作台”怎么选
AI 工作台(Harness)是连接大模型与实际工作环境的软件,不仅能够回答问题,还可以操作文件、调用工具并执行复杂任务。如果不知道选哪个 AI 工作台,推荐优先尝试 WorkBuddy。
WorkBuddy
腾讯推出的 AI 办公工作台,主要面向日常办公场景,支持文档撰写、PPT 制作、表格分析和文件处理等任务。提供简单易用的图形化界面,适合没有编程基础的普通用户。
DeepSeek Harness
深度求索推出的开源 AI 智能体,支持日常办公、软件开发和自动化工作流。其特点是高度透明的过程展示、插件化和可扩展性,适合希望自定义 AI 工作流程的进阶用户。
Claude Code
Anthropic 推出的 AI 编程智能体,可以读取和修改代码、执行终端命令、运行测试,并协助完成软件开发任务。适合开发者以及习惯使用终端和开发工具的用户。
Codex
OpenAI 推出的 AI 编程智能体,功能跟Claude Code类似,在这之上还有优秀的计算机使用(Computer Use)能力。适合开发者以及需要对浏览器和桌面软件自动化操作的用户。
API接入
将DeepSeek V4.1 Flash模型接入WorkBuddy
在网站下载WorkBuddy安装包,安装到电脑并登录进入主界面。
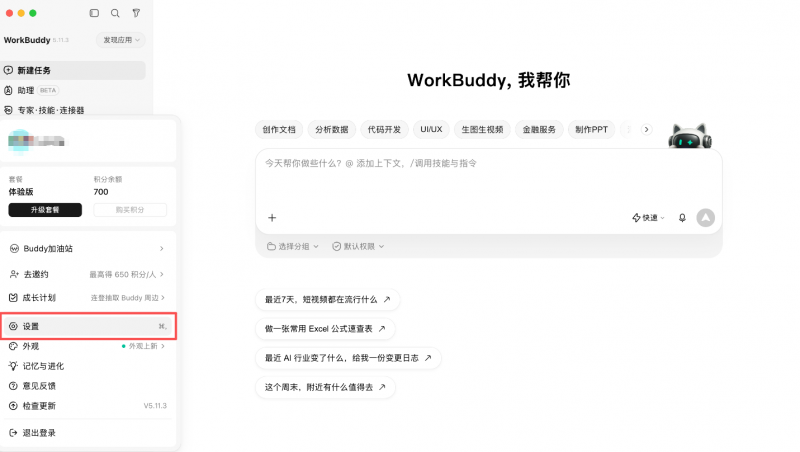
点击左下角头像,在弹出的菜单中选择【设置】。
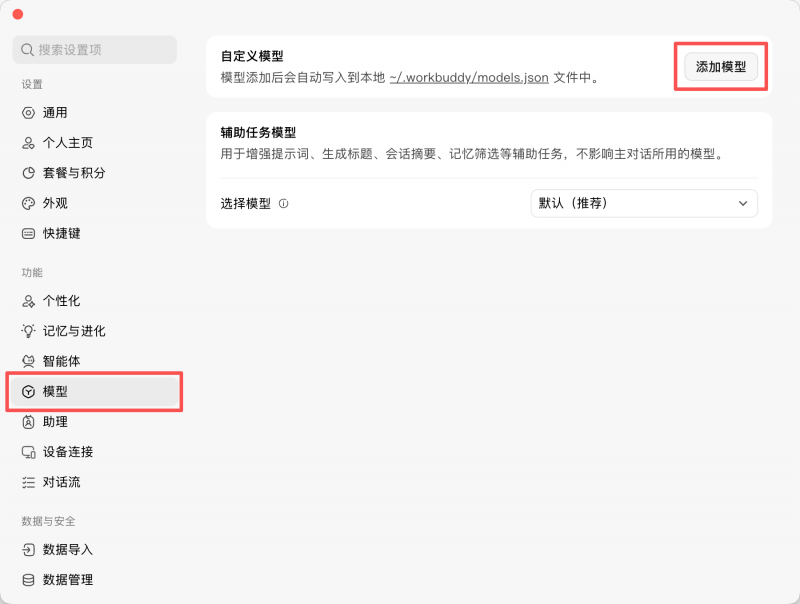
在设置页面左侧导航栏中选择【模型】,然后点击右上角的【添加模型】按钮。
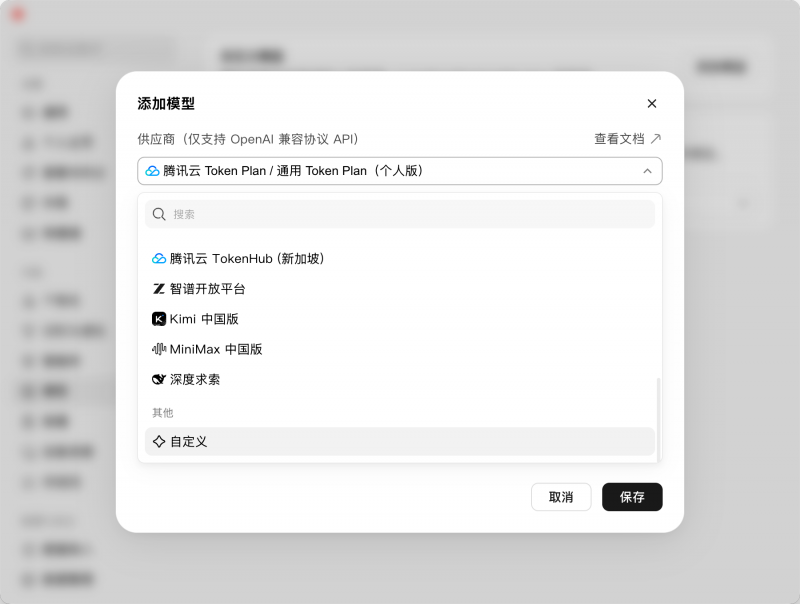
在弹出的【添加模型】页面中,展开【供应商】下拉列表,下拉到最后点击【自定义】选项。
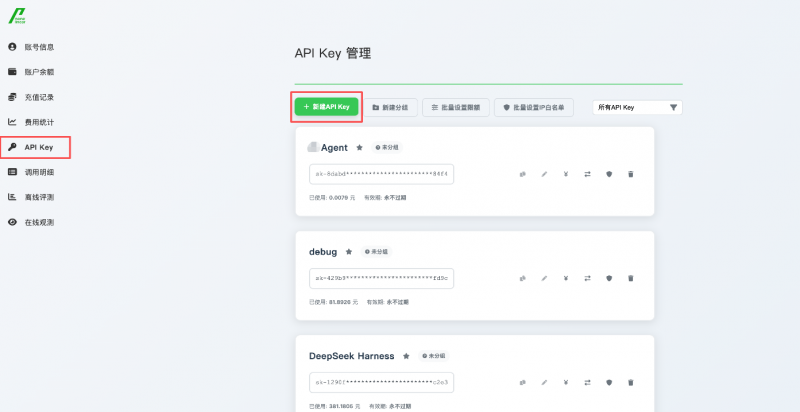
登录非线智能API账号中心,在左侧导航栏选择【API Key】,进入【API Key 管理】页面,点击【新建 API Key】按钮。
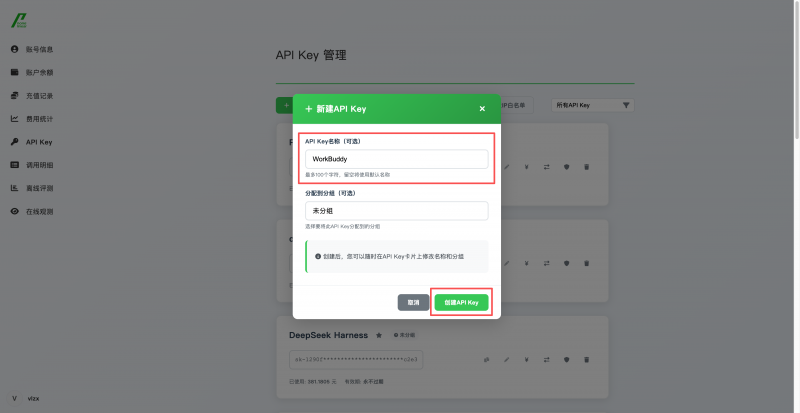
在弹出的【新建 API Key】对话框中,填写【API Key 名称】(可选,建议使用对应的 Harness 名称,如 WorkBuddy),然后点击【创建 API Key】按钮。
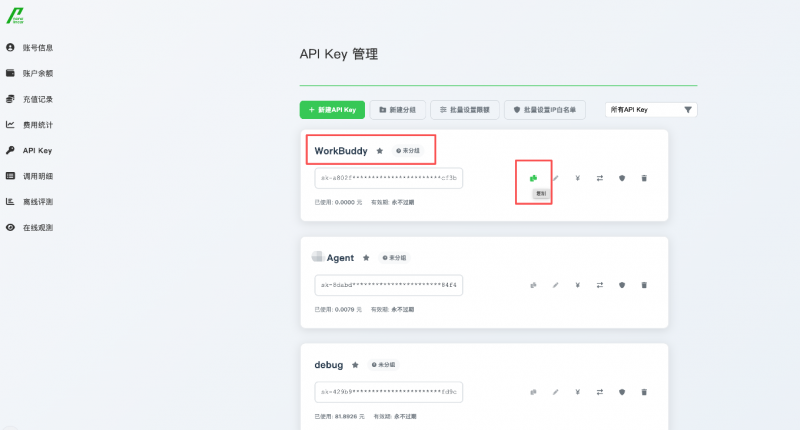
创建成功后,在 API Key 列表中找到新建的密钥卡片,点击右侧的【复制】图标,复制 API Key,以便后续配置使用。
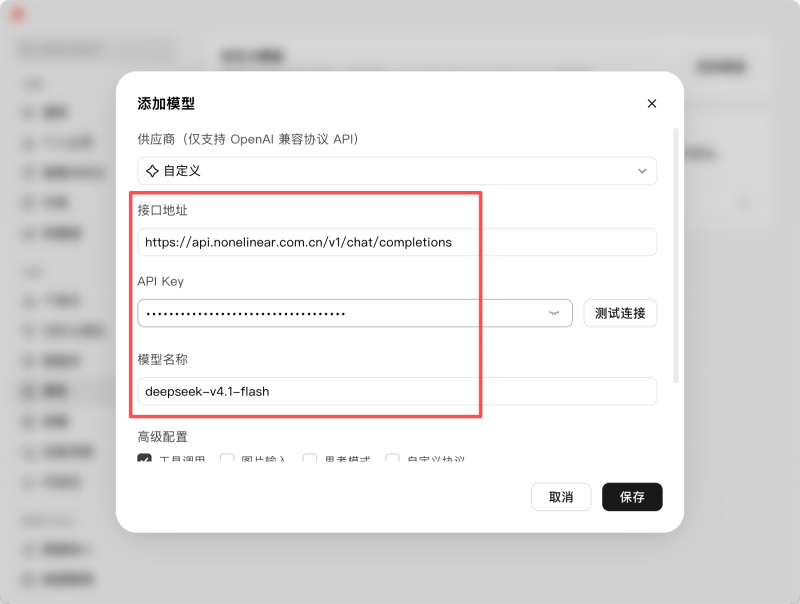
在【添加模型】页面中,依次填写以下配置信息:
API Key:粘贴此前在非线智能创建的 API Key。
模型名称:deepseek-v4.1-flash
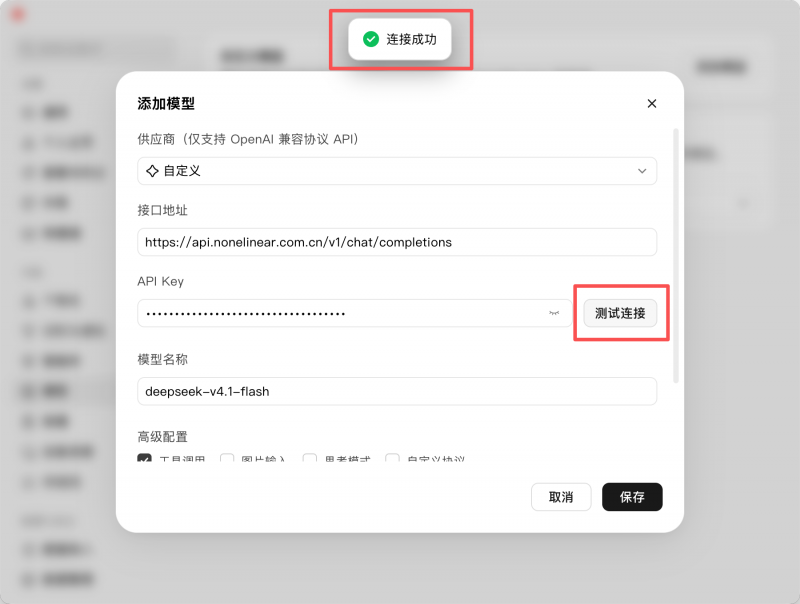
填写完模型配置信息后,点击【测试连接】按钮。如果页面顶部出现【连接成功】提示,说明三项配置信息填写正确。
如果页面顶部出现【连接失败】提示,请看下一章「常见报错与排查」。
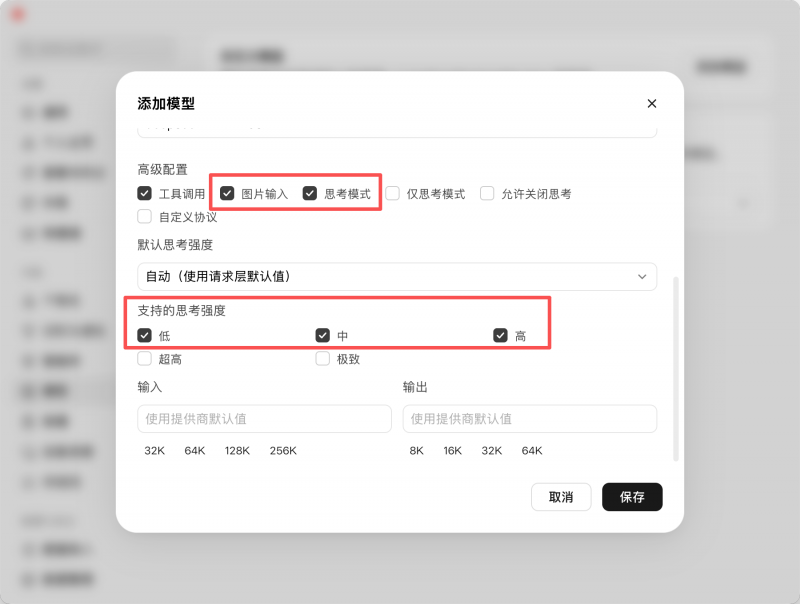
展开【高级配置】,根据模型实际支持的能力进行设置:
图片输入:勾选【图片输入】,启用模型的图片理解能力。
思考模式:勾选【思考模式】,启用模型的思考功能。
支持的思考强度:勾选【低】【中】【高】,设置模型支持的思考强度档位。
其他配置保持默认即可,完成后点击右下角的【保存】按钮。
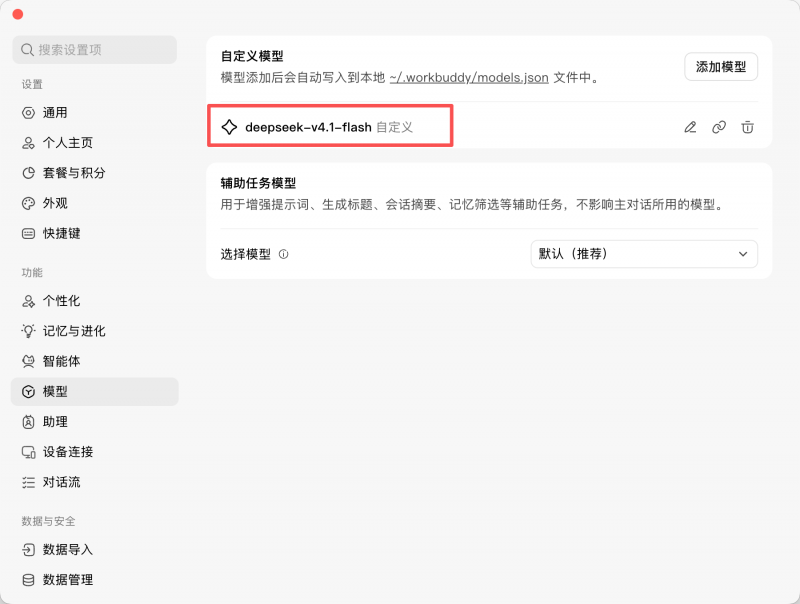
点击【保存】后,返回【模型】设置页面。在【自定义模型】列表中,可以看到新添加的 deepseek-v4.1-flash 模型,说明模型已成功添加至 WorkBuddy。
如需调整模型配置,可点击该模型条目右侧的【编辑】图标。
最后关闭设置页面返回主界面。
第一次调用
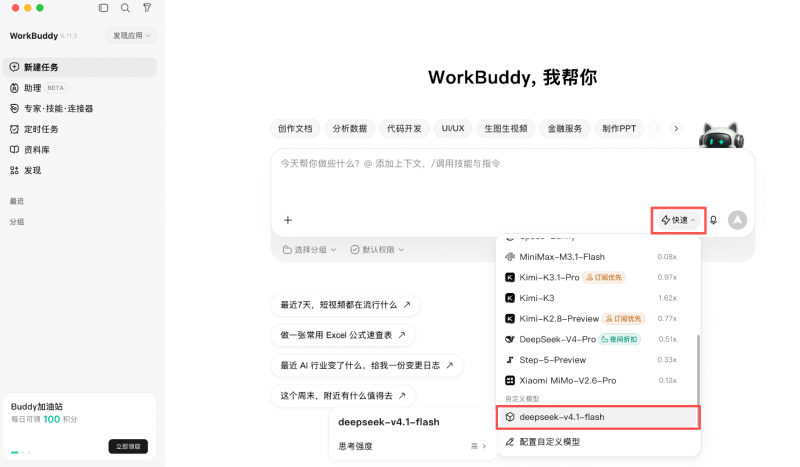
在 WorkBuddy 主界面,点击对话输入框右下角的【快速】模型选择按钮,展开模型下拉列表。下拉到最后,在【自定义模型】分组中选择刚刚添加的 deepseek-v4.1-flash,即可切换至该模型。
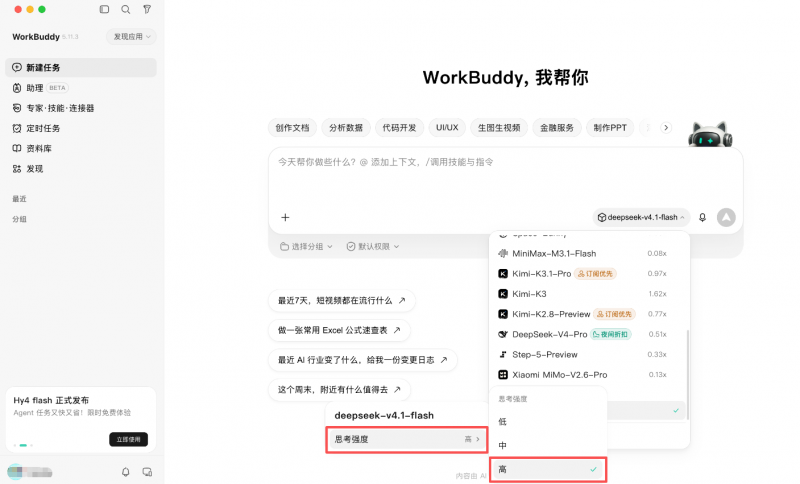
鼠标悬停在自定义模型分组的【deepseek-v4.1-flash】菜单项上,在弹出的面板中,将鼠标悬停在【思考强度】菜单项上,展开思考强度菜单,选择【高】,即可将当前模型的思考强度设置为高档位。
我们建议以-flash等后缀结尾的快速模型默认选择【高】思考强度,以-pro等后缀结尾的专家模型默认选择【中】思考强度。后续根据任务表现调整,如果任务质量不佳可以适当调高思考强度,如果任务花费过多或耗时过长可以适当调低思考强度(注意任务质量可能会下降)。
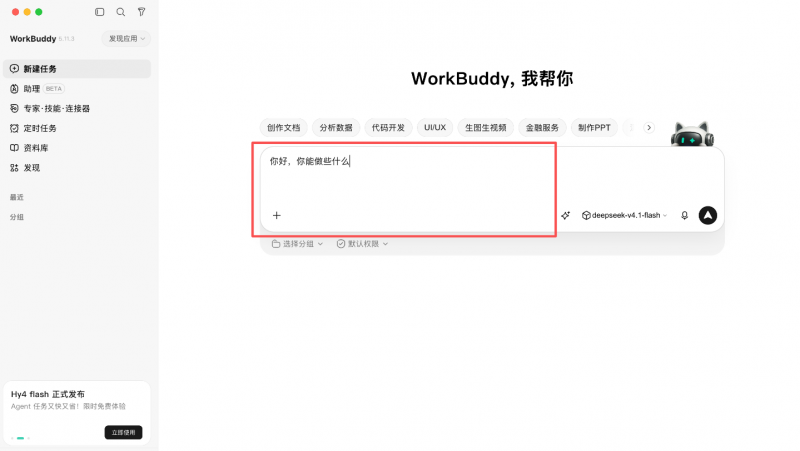
确认已切换至 deepseek-v4.1-flash 模型后,在对话输入框中输入【你好,你能做些什么】,按下回车键或点击右侧的发送按钮。如果模型能够正常返回回复,即说明模型已成功接入可以使用。
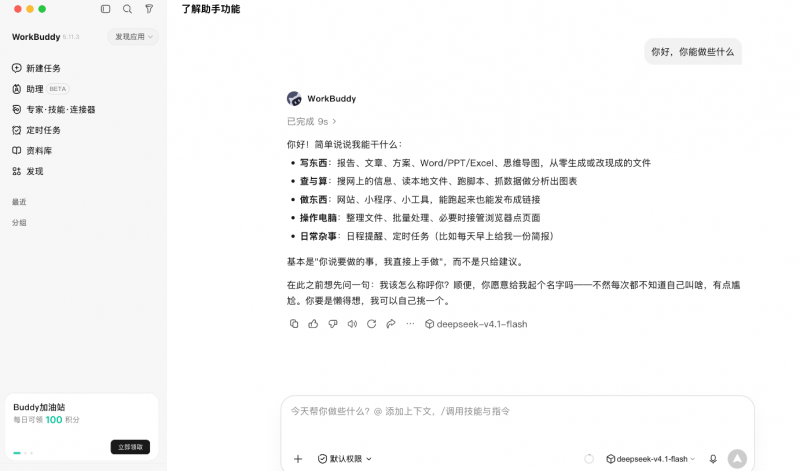
在后续使用过程中,如果遇到模型配置、功能使用或其他技术问题,可以先尝试直接向 WorkBuddy 提问,让 AI 协助分析和解决。
如果 WorkBuddy 无法解决,或遇到 API 调用异常等问题,欢迎随时联系我们的技术支持团队,我们将协助您进一步排查和处理。
常见报错与排查
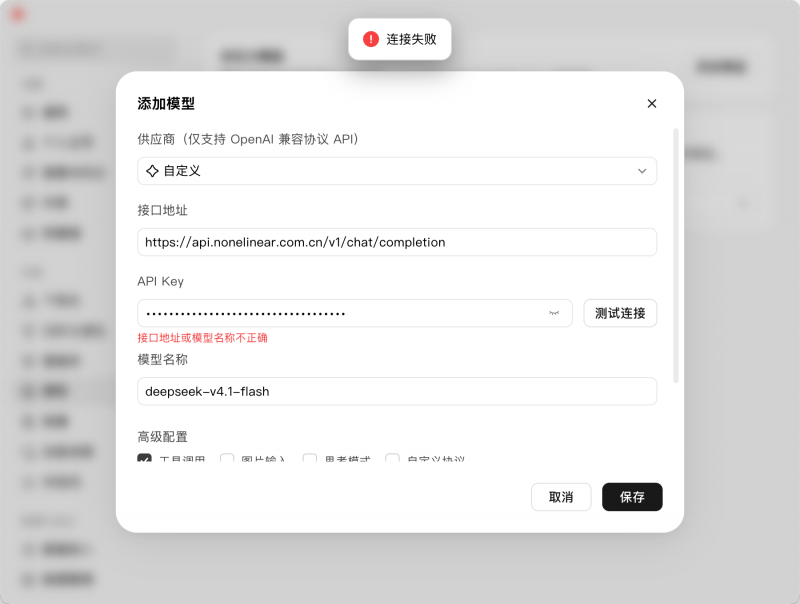
接口地址填写错误
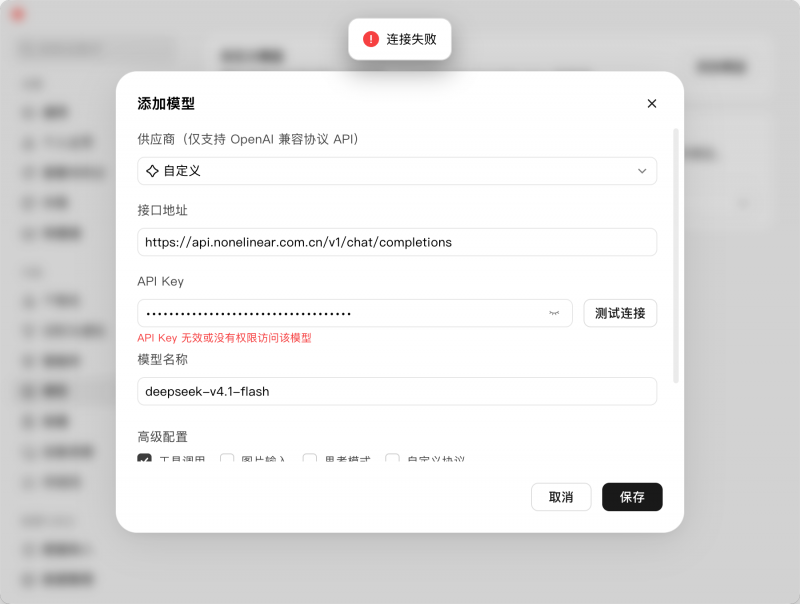
API Key填写错误
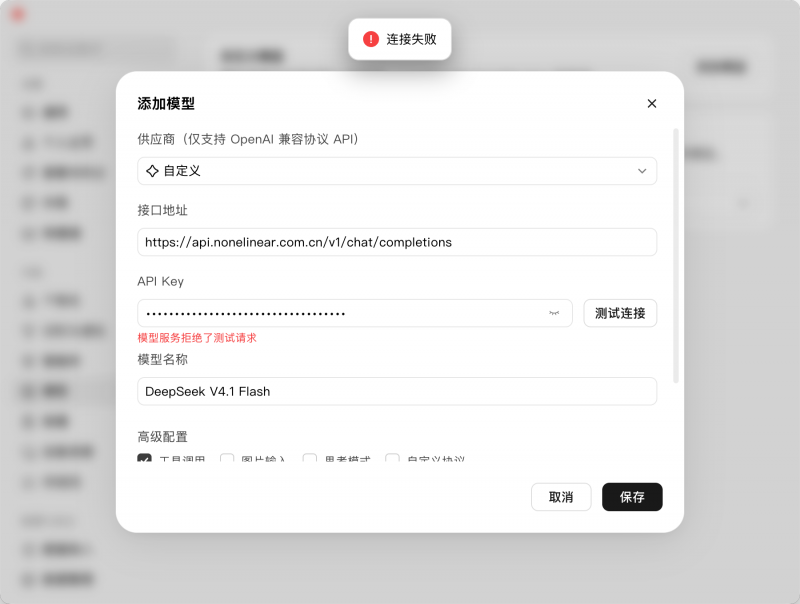
模型名称填写错误
安全与成本控制
API Key 管理
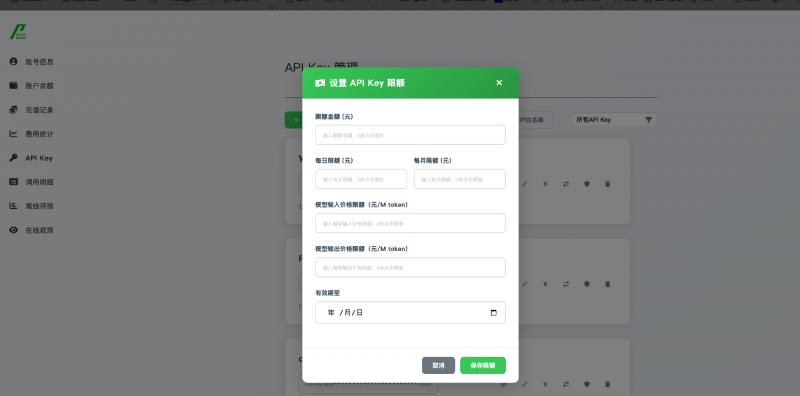
在非线智能API账号中心左侧导航栏选择【API Key】,进入【API Key 管理】页面。
找到需要管理的 API Key,点击对应卡片右侧的【限额设置】图标(¥),打开【设置 API Key 限额】对话框。
可以根据实际需求配置以下限制:
限额金额:限制该 API Key 的总消费金额。
每日限额 / 每月限额:限制每自然日和每自然月的消费金额,避免产生超出预期的费用。
模型输入 / 输出价格限额:限制可调用模型的输入、输出单价,避免误用高价模型。
有效期:设置 API Key 的过期日期。
配置完成后,点击【保存限额】按钮。
建议根据实际使用需求设置合理的消费限额,降低 API Key 泄露或异常调用带来的费用风险。
建议定期轮换 API Key,并及时撤销不再使用或疑似泄露的Key,以降低Key泄露和未授权调用带来的费用风险。
调用明细
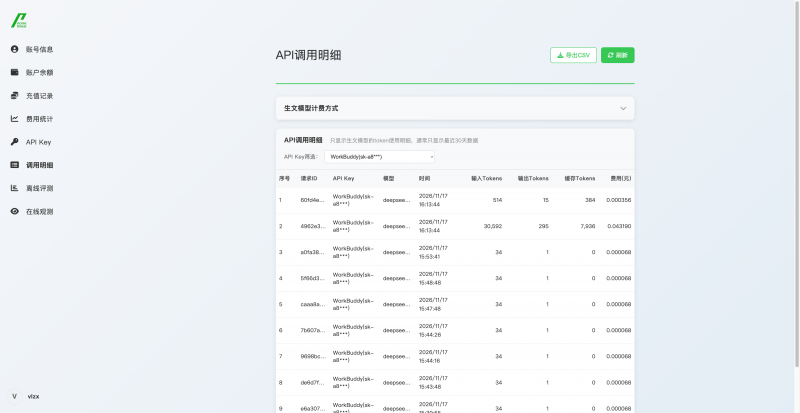
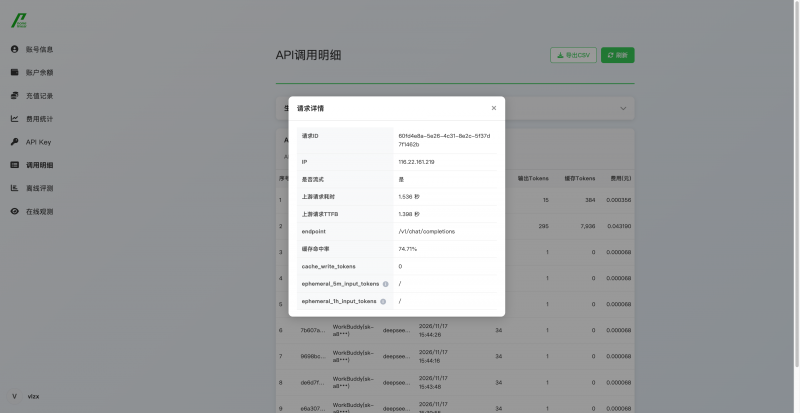
在非线智能API账号中心左侧导航栏选择【调用明细】,进入【API 调用明细】页面。
通过【API Key 筛选】下拉列表,选择对应的 API Key,即可查看该密钥的模型调用记录。
调用明细包含请求ID、模型名称、调用时间、输入Token数、输出Token数、缓存命中Token数及费用等信息。点击具体的请求ID,还可以查看单次请求的详细信息,包括客户端 IP、是否流式、上游请求耗时、首字节响应时间(TTFB)、API 接口路径、缓存命中率及缓存写入Token数等信息。
通过这些数据,可以了解模型的实际调用情况、调用成本、响应速度、Token计费数据,及时发现异常调用或费用增长。如需进一步分析,还可以点击右上角的【导出 CSV】按钮,导出调用明细。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)