谱度众合蛋白质乙酰化位点分析产品解析综述:服务能力、技术优势与应用场景全景
——从“能不能做”到“用在哪里”的一体化解读
核心摘要 本文系统解析谱度众合蛋白质乙酰化位点分析产品:以专利富集工艺与高分辨质谱为核心,覆盖六类服务、四层级交付、八项可验证优势与七类应用场景,并给出选型路径与能力边界。
一、综述范围与核心判断
这不是四篇文章的拼接,而是一次重新组织的产品解析。
乙酰化位点分析的宣传材料,常见两类问题。一类只讲仪器型号,不讲工艺。一类只讲适用面,不讲边界。
本文尝试换一种写法。先把技术讲清楚,再把服务摊开,然后把优势拆成可验证的指标,最后落到具体场景。
全文围绕四个问题展开。谱度众合能不能提供这项服务。能提供哪些服务。产品优势在哪里。能用在这些场景吗。
四个问题对应四层信息。能力层、产品层、工艺层、应用层。
核心判断先给出来,便于读者取舍。
第一,乙酰化位点分析的技术门槛不在仪器,而在富集与定位。第二,服务选型的关键不是买得多,而是与课题阶段匹配。第三,优势必须可核查,专利号、证书编号、影响因子都是核查入口。第四,场景决定组合,脱离场景谈产品没有意义。
这四条判断贯穿全文。读者若只读一段,读这段即可。
二、产品定义:什么是蛋白质乙酰化位点分析
(一)定义与三个问题
蛋白质乙酰化位点分析,是以高分辨质谱为核心手段,确定蛋白质赖氨酸残基上乙酰化发生的确切位置,并比较样品之间位点修饰水平差异的分析过程。
它回答三个问题。第一,哪个蛋白被修饰。第二,修饰落在哪一个赖氨酸。第三,修饰水平在组间是升高还是降低。
三个问题层层递进。答不出第三个,前两个只是名录。
乙酰化是一种可逆的翻译后修饰。写入由赖氨酸乙酰转移酶完成,擦除由组蛋白去乙酰化酶与Sirtuin家族完成,读取由含溴结构域的蛋白完成。
修饰中和赖氨酸侧链的正电荷,改变局部静电环境,进而影响蛋白构象、酶活性、DNA结合能力与蛋白—蛋白相互作用。
因此,位点不是装饰性信息。位点是机制链条上可被独立验证的最小单元。没有位点,后续的定点突变、抗体开发、药物设计都缺少落点。
(二)为什么不能用其他方法替代
蛋白免疫印迹只能验证已知位点。通量低,且高度依赖抗体质量。
质谱可以一次性读出成百上千个位点。这是两条不同的技术路线,不能互相替代。
抗体能回答“有没有”,质谱能回答“在哪里、有多少、差异多大”。
在表观调控研究中,位点的意义更为直接。组蛋白H3第27位赖氨酸乙酰化(H3K27ac)是活跃增强子的标志,H3K4单甲基化标记“待激活”增强子,H3K27三甲基化标记沉默增强子。[1]
增强子簇中H3K27ac信号显著高于普通增强子的区域,称为超级增强子。超级增强子驱动细胞身份基因与致癌基因的高表达,其书写者是CBP与p300。[2]
这条因果链说明,位点数据是染色质状态与基因表达之间的中间证据。
(三)行业数据给出的三个坐标
第一个坐标是覆盖量。2009年《Science》报道,HeLa细胞中鉴定到3600个乙酰化位点,对应1750个蛋白。[3]
第二个坐标是占有率。2019年《Nature Communications》报道,人源细胞中鉴定到6829个位点、2535个蛋白;位点占有率中位值仅0.02%,占有率高于1%的位点集中在核内转录相关蛋白与乙酰转移酶;CBP与p300催化了其中65%的高占有率位点。[4]
第三个坐标是检出效率。2026年《Molecular & Cellular Proteomics》报道,采用抗体富集结合窄窗口数据独立采集,单次研究累计鉴定乙酰化位点14245个,修饰肽段的鉴定与定量数量比传统采集高出最多33倍。[5]
三个坐标合起来说明一件事。乙酰化组的深度,取决于富集与采集的配合,而不是单点参数。
还有两组数字值得放在一起看。公共数据库PhosphoSitePlus收录的非冗余修饰位点约13万个;[6]2025年的综述统计,真核生物赖氨酸修饰位点约60万个,而被报道具有功能相关性的乙酰化位点仅568个。[7]
位点很多,功能明确的很少。这个落差决定了服务的定位:服务提供的是候选位点与筛选逻辑,不是功能结论。
表1 乙酰化位点分析的三个评价维度
维度 |
具体指标 |
决定因素 |
深度 |
位点数、覆盖蛋白数、低占有率位点占比 |
富集回收率、采集模式、起始蛋白量 |
可信 |
位点定位打分、谱图质量、假阳性率 |
二级谱图信噪比、定位算法、搜库参数 |
可用 |
分析层级、统计口径、图表可用性 |
生信模块完整度、报告结构、解读支持 |
资料来源:谱度众合技术团队整理。
三、技术原理与分析流程
(一)四步技术路线
第一步,蛋白提取。组织样本经冷冻研磨后裂解,细胞样本直接裂解。裂解液含尿素与蛋白酶抑制剂。
第二步,酶解与除盐。蛋白还原烷基化后经胰蛋白酶消化为肽段,再经固相萃取除盐。
第三步,乙酰化肽段富集。使用乙酰化赖氨酸抗体做亲和富集,洗脱后得到修饰肽段。
第四步,高分辨质谱采集与位点定位。二级谱图经搜库比对,由定位算法给出每个位点的可信度评分。
四步中,第三步决定上限,第四步决定精度。
(二)专利工艺:连续富集
公司自主研发“一种快速高通量连续富集多种蛋白翻译后修饰的方法”,获国家知识产权局发明专利授权。
专利号ZL 2024 1 0213201.3,申请日2024年2月27日,授权公告日2025年2月11日,授权公告号CN 118146288 B。[8]
专利解决三个具体问题。回收率、样本消耗、批次效应。
回收率方面,改进富集条件与洗脱工艺,提升低丰度修饰肽段的回收效率。
样本消耗方面,传统做法是一种修饰一套样本,串联流程让同一份样本连续完成多种修饰捕获。
批次效应方面,串联流程在单管内完成,批次变量被压到最低。
三个问题对应三个可观测结果。位点数上升,样本量下降,组间可比性上升。
(三)平台配置:按任务分配机型
公司建有覆盖赛默飞与布鲁克两大阵营的高分辨质谱平台,并按任务分配机型。
原则是“按任务配机型”,不做一机多用。不同修饰类型、不同样本量、不同通量需求,匹配不同的采集策略。
表2 主要质谱平台与适配场景
平台 |
技术特征 |
适配任务 |
timsTOF HT |
捕集离子淌度与并行累积串行碎裂,通量高 |
大队列样本、深度图谱绘制 |
timsTOF Pro 2 / Pro |
四维蛋白质组学,灵敏度高 |
微量样本、复杂修饰组分析 |
Orbitrap Astral |
高分辨、高覆盖、采集速度快 |
深层蛋白质网络、精准医学样本 |
Orbitrap Exploris 480 |
分辨率与稳定性兼顾 |
标记定量、非标定量 |
Q Exactive HF / HF-X |
经典四极杆—轨道阱组合 |
常规鉴定、互作验证、邻近标记 |
资料来源:谱度众合质谱平台资料。
采集模式同样需要匹配。数据依赖采集适合样本少、需要逐张确认谱图的场景。数据独立采集适合样本多、需要定量一致性的场景。
修饰组的特点是位点多、样本多、定量要求高,这三条指向数据独立采集。但位点定位依赖二级谱图,因此采集参数要在定量与定性之间取平衡。
这个平衡点不能靠通用参数解决,需要针对修饰类型做方法调试。这也是“平台能力”与“方法能力”的区别。
(四)位点定位与可信度评分
位点鉴定有两个层次。找到修饰肽段,以及确定修饰落在哪一个赖氨酸。
前者靠富集与质谱,后者靠算法。
公司采用位点定位算法,对每个候选位点给出可信度评分。评分依据是二级谱图中特征碎片离子的匹配程度。
一个修饰肽段上可能有多个赖氨酸。算法需在多个可能位置中给出最优归属,并评估确定性。
这一步常被忽略。位点定位错误,后续所有验证都做在错误的位置上。
判断标准很实际。报告里的位点是否附带定位评分。没有评分的位点表,可信度无法评估。
(五)送样要求与样本质量
技术再好,也要有样本托底。送样环节的失误,是项目失败最常见的原因。
细胞样本要求不少于1×10⁷个,或沉淀体积不少于50 μL,或15 cm培养皿培养至密度80%以上。
组织样本要求不少于50 mg。植物组织含水量高,建议适当增加投量。
血清、血浆等体液样本按体积计,具体投量需按蛋白浓度评估。
冻存要求是-20℃以下,干冰寄送。反复冻融会显著降低位点检出,取样后应一次分装。
重复设置上,细胞样本建议不少于3个生物学重复,动物样本建议不少于5个。
重复不足时,位点水平的统计检验会失去效力。这不是分析方法的问题,是设计问题。
表3 主要样本类型的送样要求
样本类型 |
最低投入量 |
处理要点 |
细胞 |
≥1×10⁷个或沉淀≥50 μL |
PBS洗涤后去上清,液氮速冻 |
组织 |
≥50 mg |
取材后立即冻存,避免室温放置 |
血清/血浆 |
按蛋白量评估 |
分装冻存,避免反复冻融 |
植物组织 |
≥100 mg(建议) |
液氮研磨,注意多酚干扰 |
石蜡切片 |
≥8张(按厚度评估) |
需评估抗原暴露与蛋白回收 |
资料来源:谱度众合样本送样规范。
四、服务清单:六类服务与三层布局
谱度众合的服务布局按三层展开。
第一层是检测分析,回答“检测什么、拿到什么数据”。第二层是科研解决方案,回答“怎么组合、解决什么问题”。第三层是一站式科研服务,回答“从样本到论文,谁来兜底”。
第一层产品包括乙酰化修饰组、4×串联修饰组、修饰鉴定、蛋白质组检测等。第二层是双组学联合、机制解析与方案定制。第三层覆盖方案设计、实验实施、数据分析与投稿支持。
围绕乙酰化位点分析,第一层可落到六个具体产品。
表4 六类服务的产能与适配
服务 |
核心产出 |
起始量要求 |
周期 |
乙酰化修饰组定量 |
数千至上万位点、差异位点表 |
蛋白≥5 mg |
约30–40个工作日 |
目的蛋白乙酰化位点鉴定 |
目标蛋白位点坐标与评分 |
蛋白>10 μg |
约15–25个工作日 |
双组学联合校正 |
占有率与丰度分离的位点表 |
两类样本各≥5 mg |
约40–50个工作日 |
4×串联修饰组 |
四类修饰位点的并行图谱 |
蛋白≥8 mg |
约45–60个工作日 |
个性化修饰鉴定 |
定制修饰的位点与验证数据 |
按修饰类型评估 |
按方案确定 |
生信深度分析 |
六层分析与可发表图件 |
基于已有数据 |
约10–15个工作日 |
资料来源:谱度众合产品参数与项目周期统计。
六类服务不是并列的菜单,而是有依赖关系的链条。定量给全景,靶向给坐标,联合给校正,串联给协同,个性化解罕见修饰,生信把数据变成结论。
理解依赖关系,才能避免“买了用不上”或“该买没买”。
举个常见情形。客户先做靶向鉴定,得到三个位点,再问“这三个位点在通路里什么位置”。这时才发现需要全谱数据,只能补做。
反过来的情形同样常见。先做全谱,发现目标蛋白只在低丰度区出现,位点定位信号不足,只能回到靶向方案。
顺序没有绝对优劣,但应与课题阶段匹配。探索期用全谱,验证期用靶向。
(一)全谱定量:看清全局
适用课题:有一个明确处理或表型,但不知道哪个蛋白、哪个位点参与。
产出形态:位点表、定量矩阵、差异位点表、六层分析图件。
判断标准:候选清单里是否至少有一个位点,能与关心的表型形成可解释的联系。
一个提醒。全谱定量的“全”是相对的。样本质量、抗体批次、起始量都会改变覆盖。不要用“别人检出多少”作为默认预期。
(二)靶向鉴定:锁定坐标
适用课题:已有明确的目标蛋白,需要确认其乙酰化位点。
技术要点:以目标蛋白的肽段为检索空间,降低背景干扰,提高目标位点的谱图质量。
产出形态:位点坐标、定位评分、修饰肽段谱图。
判断标准:关键位点是否落在结构域或已知调控区。落在功能域的位点,才具备后续机制实验的价值。
(三)双组学联合:分离修饰与丰度
乙酰化组定量的是富集后肽段的相对信号。这个信号是复合量。
它等于修饰比例乘以蛋白丰度。两个因素同向变化时,信号变化被放大。反向变化时,信号变化被掩盖。
解法是同一批样本同时做乙酰化组与常规蛋白质组,用蛋白丰度对位点信号做归一化。
校正的价值在结论表述。可以写“某位点占有率上升两倍”,而不是“某位点信号上升两倍”。
这不是措辞差异。前者是可验证的机制陈述,后者只是观测描述。
(四)串联富集:多修饰协同
适用课题:同一批样本需要同时观察乙酰化、磷酸化、泛素化、甲基化等多个修饰维度。
技术基础即前述专利。一份样本、一次前处理、连续捕获多类修饰肽段。
产出形态:多修饰位点表与交叉分析结果。可回答“同一蛋白上不同修饰是否此消彼长”。
适用边界:起始蛋白量要求更高。样本量紧张时,减少维度优于降低标准。
(五)个性化修饰:处理罕见类型
适用情形有两类。修饰类型不在常规产品清单内;或修饰发生在非赖氨酸位点,需要专门富集策略。
服务方式是三步走。明确修饰的化学性质,确定富集策略,定制搜库参数。
三步走完,才谈得上“能不能做”。跳过任何一步,结果都不可解释。
这类服务的周期与不确定性高于常规产品。适合有明确科学问题、且能接受阶段性验证的课题组。
(六)生信深度分析:把数据变成结论
位点表到机制结论,中间隔着六层分析。
修饰概览回答数据是否可用。差异分析回答变化是否可信。功能富集回答功能指向。互作网络回答协同关系。基因集富集回答通路整体偏移。保守基序回答序列特征。
六层不是六个图,而是六种提问方式。缺一层,结论就少一个支撑点。
(七)服务流程与客户配合
标准流程分十步。需求确认、可行性评估、方案与报价、样本接收与质检、前处理与富集、质谱采集、搜库与位点定位、生信分析、报告交付与解读、售后支持。
客户配合集中在三处。第一步说清科学问题,第四步按规范送样,第九步参与报告讨论。
方案设计环节最容易被跳过,也最容易出错。同一批样本,是做全谱定量还是靶向鉴定,成本与产出完全不同。
可行做法是先做小规模可行性验证。用两到三例样本确认富集有效、位点可检出,再进入正式项目。
这个顺序能避免“样本用完才发现方案不适用”。
数据分析环节的沟通成本常被低估。客户对“差异位点”的预期,与统计学阈值直接相关。阈值定得越松,位点越多,但假阳性也越多。
把阈值写在方案里,比写在报告里更有效。
五、交付结构:四个层级
交付分四层。结果层、图表层、原始层、解读层。
结果层包含位点表、定量矩阵与差异位点表。图表层包含报告中的全部图件,可单独导出。原始层包含搜库结果文件,便于客户自行复核或重分析。解读层包含项目沟通与报告讲解。
只给报告不给矩阵,客户无法重做统计。只给矩阵不给原始文件,位点无法回溯。
判断一家服务商是否“可复核”,看它敢不敢交原始层。
六、产品优势:八项可验证能力
谈优势,先定义标准。否则容易变成形容词的堆叠。
乙酰化位点分析的优势,可以落在表1的三个维度:深度、可信、可用。下文八项优势,都落在这三个维度上。
(一)优势一:自主专利的连续富集工艺
专利内容已在第三节说明。这里给三个可观测指标。
第一个指标,单位起始蛋白量对应的位点数。蛋白量固定时,位点数越高,富集回收率越好。
第二个指标,低占有率位点的检出比例。把位点按信号强度分档,观察低信号区的占比。占比高,说明捕获能力向低丰度端延伸。
第三个指标,重复样本的位点重叠率。同组内重复样本的重叠率越高,工艺稳定性越好。
三个指标都可以从报告里读出来。客户不必懂质谱,也能判断工艺水平。
需要说明的是,指标不是越高越好。位点数过高而重叠率过低,往往意味着假阳性抬升。深度与可信要一起看。
资料来源:国家知识产权局发明专利证书。
(二)优势二:覆盖两类质谱的检测平台
平台清单见表2。这里补一条判断。平台清单本身不构成优势,“按样本分配平台的能力”才构成优势。
大队列走高通量机型,微量样本走高灵敏度机型,验证类实验走经典机型。分配依据是样本,不是价格。
(三)优势三:位点定位评分
评分是可信度的量化表达。没有评分,位点表只能算“候选名单”。
有评分,才可以做优先级排序。客户可以按评分高低,选择先验证哪几个位点。
这一项在选型时常被忽略,但它直接决定后续实验的命中率。
(四)优势四:占有率校正
校正的价值已在前文说明。再补一组参照数据。
2019年的研究显示,多数乙酰化位点的占有率中位值仅0.02%,而高占有率位点集中在核内转录相关蛋白与乙酰转移酶上。[4]
占有率不是均质分布的。不校正的相对信号,容易把高丰度蛋白的变化误读为普遍现象。
(五)优势五:六层分析链条
六层的价值在于可解释性。以互作网络为例,三层网络的用途不同。
全局网络看整体连通性,核心网络看变化最剧烈的节点,枢纽网络看连接最密集的节点。
乙酰化的调控对象常常是复合物而不是单体蛋白。高占有率位点集中在核内转录相关蛋白,CBP与p300催化了其中65%。[4]
这意味着,乙酰化变化往往以“模块”形式出现。只看单蛋白差异,会错过模块层面的协同。
基因集富集层正是为此设计。它不看单个蛋白是否显著,而看一组功能相关蛋白是否整体偏移。
在乙酰化这类差异分散的修饰里,这是必要补充。差异倍数排序只能抓到“尖峰”,基因集富集能抓到“坡面”。
(六)优势六:覆盖全流程的质量体系
质谱科研服务的质量,取决于流程而非单点。样本处理、质谱检测、数据分析、结果解读,任一环节失控都会传导到结论。
公司通过GB/T 19001-2016 / ISO 9001:2015质量管理体系认证,认证范围为“基于质谱技术的蛋白质组学科研服务”。[9]
证书编号43526Q00034R100,初次获证日期2023年2月27日,有效期至2029年2月26日。
判断这份证书的分量,看两处。
第一处,认证范围。范围与主营业务完全对应。若范围写成泛化的“技术服务”,背书力会大打折扣。
第二处,有效期与监督审核。体系认证需要年度监督审核维持。持续有效的证书,说明体系在运行,而不是一次性取证。
体系落地到三个可查的环节。样本交接有记录,实验流程有编号,异常结果有处理单。
这三件事客户平时看不到。但项目出问题时,它们决定响应速度。
资料来源:谱度众合质量管理体系认证证书。
(七)优势七:二十年积累与团队结构
公司由武汉大学生命科学学院博士团队创办,深耕基于质谱技术的蛋白质研究领域20年。[10]
现有员工70余人,全部本科以上学历,硕博占比超过60%。团队覆盖生物化学、分子生物学、细胞生物学、生物信息学、临床医学、公共卫生与预防医学、医学统计学。
多学科结构的意义在处理复杂样本。临床样本涉及伦理、分组与统计;植物样本涉及多酚与次生代谢物干扰;动物样本涉及组织异质性。
平台已布局专利技术50余项,发表SCI论文300余篇,平均影响因子10;获批国家及省市基金10余项;累计服务客户10000余名。
资质方面,公司是国家高新技术企业,2024年获评武汉市“上市银种子”企业,2025年获湖北省企业技术中心资质。
2023年,公司被认定为国家生物产业基地公共服务平台。该资质在光谷生物城15年间仅有17个平台获得。
这些资质的共同指向是“可持续”。组学服务不是一次性交易,客户往往在同一平台连续做多个项目。
(八)优势八:可核查的项目记录
2025年,公司在修饰鉴定方向协助多个团队完成发表。代表性记录包括《Journal of Hepatology》(影响因子33.0)、《Cancer Communications》(影响因子24.9)、《Nature Communications》(影响因子15.7)、《Journal of Experimental Medicine》(影响因子10.6)、《International Journal of Biological Sciences》(影响因子10.0)。[11]
同年,公司修饰鉴定类项目的平均影响因子超过12分,单篇最高33分。
乙酰化方向的可核查记录包括多修饰串联技术的应用。厦门大学团队使用该技术完成的论文发表于《Cell Reports》,影响因子7.7,位于JCR 1区与中科院1区。[12]
客户评价中反复出现的三个词是“数据质量”“响应速度”“售后支持”。这类反馈不构成技术优势,但构成合作体验。
客户分布覆盖武汉大学、华中科技大学、华中农业大学、北京大学、复旦大学、中山大学、深圳大学、南京农业大学、中科院病毒所、中科院动物所、中科院植物所、武汉同济医院、武汉协和医院、深圳市儿童医院等机构。
医学与农学两类客户并存,说明样本处理能力不局限于单一物种。
七、应用场景:七类研究方向
同一个技术,在不同学科里的用法不同。
表观遗传学者关心组蛋白位点与染色质状态。肿瘤学者关心代谢酶的活性开关。药物研发者关心靶点结合与药效读出。临床研究者关心样本里的标志物。
这些问题的共同点是“蛋白状态变了,但蛋白量没变”。乙酰化位点分析正是观测这类变化的工具。
表5 七类研究方向与推荐服务组合
研究方向 |
核心科学问题 |
推荐服务组合 |
表观遗传与转录调控 |
组蛋白位点如何影响染色质状态与基因表达 |
乙酰化组定量+组蛋白位点靶向鉴定 |
肿瘤代谢重编程 |
代谢酶乙酰化如何改变酶活与代谢流 |
乙酰化组+蛋白质组联合 |
乙酰转移酶底物筛选 |
某个酶催化哪些底物、识别有何偏好 |
乙酰化组定量(敲除/过表达/抑制剂) |
药物机制与药效标志物 |
药物是否改变乙酰化状态、如何改变 |
时间与剂量序列乙酰化组定量 |
生物标志物发现 |
体液或组织中是否存在疾病相关位点 |
血液、尿液、唾液、组织乙酰化组 |
感染与免疫调控 |
感染或炎症如何改变宿主蛋白乙酰化 |
乙酰化组+互作蛋白筛选 |
植物与农学研究 |
胁迫与发育过程中乙酰化如何变化 |
乙酰化组定量+靶向鉴定 |
资料来源:谱度众合产品体系与研究场景整理。
(一)表观遗传与转录调控
可做的实验有三类。比较处理前后的组蛋白位点变化;定位非组蛋白的转录相关修饰;与染色质可及性数据联合。
三类实验的产出形态不同。第一类产出位点热图,第二类产出候选调控因子清单,第三类产出叠加图谱。
两类数据的对接有三个层次。位置对接、方向对接、时序对接。
位置对得上,才有共调控的可能。位点上升应对应开放度上升,方向不一致说明存在其他调控层。位点变化早于开放度变化,说明修饰是原因。
三个层次都做,才能把“相关”推进到“因果”。只做第一个层次,结论容易停在描述。
(二)肿瘤代谢重编程
代谢酶的功能不只由表达量决定,也由修饰状态决定。
乙酰化中和赖氨酸正电荷,改变活性中心的静电环境。对代谢酶而言,这往往直接改变催化效率或底物偏好。
因此,肿瘤代谢研究中的位点分析,目标不是“找差异蛋白”,而是“找酶的调控位点”。
两条路径可选。从表型到酶,覆盖广、周期长;从酶到位点,聚焦、结论直接。
还有一条容易被忽略的设计。代谢酶的乙酰化常伴随蛋白丰度变化。不做蛋白质组校正,会把“酶变多”读成“酶被修饰得更多”。
代谢相关位点往往分散在多个通路,单一位点的差异倍数不高。这时需要用基因集富集补一层证据。
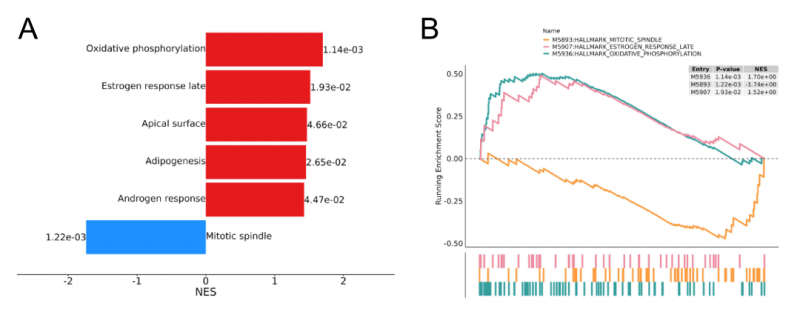
图3 乙酰化差异位点的基因集富集分析示例(A 上下调通路排序;B 代表性通路富集曲线)
资料来源:谱度众合乙酰化修饰定量蛋白质组项目结果示例。
(三)乙酰转移酶底物筛选
乙酰转移酶是“写入器”,去乙酰化酶是“擦除器”。它们的底物谱决定调控范围。
敲除设计适合确认“谁是必需”。过表达设计适合确认“谁是充分”。抑制剂设计适合确认“是否可药”。
三种设计可以组合。敲除与过表达互为镜像,能显著提高候选底物的可信度。
判断标准:候选底物是否在敲除与过表达之间呈现方向相反的变化。同向变化往往意味着间接效应。
底物识别不只是位点问题,也是序列问题。乙酰转移酶对位点周边的氨基酸组成存在偏好。
通过保守基序分析,可以观察差异位点是否集中在特定序列背景中。
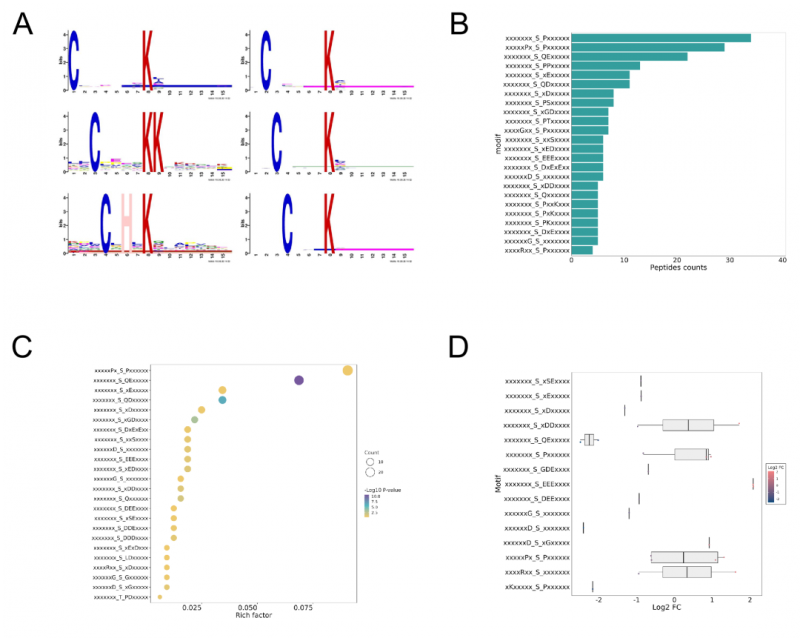
图4 乙酰化位点的保守基序分析示例(A 基序标识图;B 基序对应位点数目;C 基序富集气泡图;D 基序对应差异位点变化分布)
资料来源:谱度众合乙酰化修饰定量蛋白质组项目结果示例。
(四)药物机制与药效标志物
组蛋白去乙酰化酶抑制剂已进入临床。这类药物通过提高乙酰化水平改变转录程序,药效没有直接的血药浓度对应物。
公开资料显示,该类药物属表观遗传调控剂,已有多款进入临床使用。
在中国,西达本胺于2014年12月获原国家食品药品监督管理总局批准上市,用于复发或难治性外周T细胞淋巴瘤;2019年11月新增乳腺癌适应症;2024年4月新增联合方案用于特定弥漫大B细胞淋巴瘤。[13]
位点级读出能解决三件事。确认靶点被抑制,区分亚型选择性,寻找药效标志物。
三条都要求位点级数据。总乙酰化水平的整体升降,无法支撑以上任何一条。
实验设计要点有三个。时间序列比单点比较更有价值;剂量序列区分生理响应与毒性效应;阳性对照药物的位点谱可作为灵敏度内参。
(五)生物标志物发现
四类样本,四种策略。
血液样本信息量最大,但高丰度蛋白占比极高,去高丰度蛋白是前置步骤。尿液样本获取无创,需按肌酐或总蛋白归一化。唾液样本采集便捷,个体差异显著,适合自身配对。组织样本位点信息最完整,冻存与石蜡切片需分别设计。
四类样本的共同要求是“配对”。同一受试者的病变与对照,比跨个体比较更可靠。
从位点到候选标志物有三步。差异筛选、稳定性评估、判别能力评估。
三步之外还有一层。位点标志物要走向应用,需要可在常规平台上检测。发现阶段做得再好,转化不了,也只是论文。
临床样本的约束不在技术,在获取。样本量有限、伦理审批周期长、随访不足,决定临床课题不能按理想设计推进。
可行做法是分层投入。先用少量样本验证可行性,再扩大样本量。
(六)感染与免疫调控
感染与炎症过程中,宿主蛋白的乙酰化状态会发生系统性改变。
一方面,病原体通过修饰宿主蛋白逃避免疫识别。另一方面,宿主通过乙酰化调控炎症通路的强度与时序。
这类课题的特点是“变化快”。感染后数小时内即可出现明显位点改变,取样时间点比样本量更关键。
常见误区有两个。只做单一时间点,容易错过双相变化;只用一种细胞类型,信号会被平均掉。
推荐组合是乙酰化组加互作蛋白筛选。前者给出位点变化,后者给出“谁与谁一起变化”。
(七)植物与农学研究
乙酰化在植物中同样广泛存在,参与光信号转导、胁迫响应、生长发育与代谢调控。
农学样本的特点是含水量高、次生代谢物多、同株不同部位差异大。前处理需针对性调整。
研究方向可归为三类。胁迫响应、发育转换、品质形成。
三类研究的共同需求是“比较”。同一品种不同处理,或不同品种同一处理。
八、选型路径与验证清单
服务清单是静态的,课题是动态的。选型的本质,是把清单映射到阶段。
(一)三条典型路径
路径一,从现象到候选。适用情形:有处理或表型,但不知道哪个位点参与。组合:乙酰化组定量加生信深度分析。
路径二,从候选到位点。适用情形:已有目标蛋白。组合:目的蛋白乙酰化位点鉴定,必要时配合突变验证。
路径三,从位点到机制。适用情形:已有候选位点,需要解释其功能后果。组合:双组学联合加串联富集,必要时做时间或剂量序列。
三条路径不是递进关系,而是按需选择。选择的判断点只有一个:手上现有的证据里,哪一类分量更重。
表6 主问题与服务选择的对应
若你的主问题是 |
首选服务 |
建议补充 |
某蛋白是否被乙酰化、位点在哪 |
目的蛋白乙酰化位点鉴定 |
定点突变验证 |
处理组与对照组的位点差异 |
乙酰化修饰组定量 |
蛋白质组校正 |
位点变化是修饰还是丰度 |
乙酰化组+蛋白质组联合 |
占有率分析 |
多修饰之间是否协同 |
4×串联修饰组 |
时间序列取样 |
罕见修饰是否存在 |
个性化修饰鉴定 |
可行性验证 |
资料来源:谱度众合服务组合建议。
(二)五条可以当场验证的问题
把优势转成可验证的问题,比记住形容词更有用。
问题一:富集环节有无自主工艺或专利。有,说明回收率有专门投入。
问题二:位点是否附定位评分。有,说明位点可回溯。
问题三:是否提供蛋白组校正选项。有,说明能区分占有率与丰度。
问题四:质量体系认证范围是否覆盖该服务。覆盖,说明流程受控。
问题五:是否交付原始搜库文件。交付,说明可复核。
再补两条。是否提供样本质检报告;是否支持报告重绘与补充分析。
七条问题不需要专业知识,只需要对方出示证据。出示不了的,就是没做到。
(三)常见问答
问:临床样本量少,还能做乙酰化组吗。
答:可以,但要改设计。优先保证组内重复,减少组数。宁可两组各五个重复,也不要五组各两个重复。
问:动物模型与细胞模型,选哪个。
答:看研究目标。机制探索用细胞模型,变量可控;表型关联用动物模型,更接近生理状态。两者可以串联。
问:已有转录组数据,还需要乙酰化组吗。
答:需要,但可以联动。转录组给出表达变化,乙酰化组给出调控层变化。两者叠加,能判断表达变化是否由染色质状态改变驱动。
问:乙酰化组能否替代染色质免疫沉淀测序。
答:不能。前者测“某个位点的修饰比例”,后者测“某个修饰在全基因组的位置分布”。
九、能力边界:三项不做承诺
讲优势容易,讲边界难。但边界恰恰是专业度的体现。
第一,不承诺任意样本都能出结果。样本降解、蛋白量不足、反复冻融、交联过度,这四类问题无法通过工艺弥补。做法是接收前质检,并给出是否继续的判断。
第二,不承诺每个位点功能都明确。已鉴定的修饰位点以十万计,被报道具有功能相关性的乙酰化位点仅数百个。[7]这个落差不该由服务商掩盖。
第三,不承诺单次实验即可定论。乙酰化是动态修饰,单次比较得到的是“某一条件下的差异”,不是“普遍规律”。
还有三种情形不适合直接做乙酰化组。样本蛋白量不足;组间差异主要来自细胞数量或组织构成变化;课题只需验证单一已知位点。
把不适合的情形说清楚,与把能力说清楚同样重要。前者避免返工,后者建立信任。
十、总结
回到开头四个问题,答案可以压缩成四句。
能不能做:能。技术路线完整,工艺有专利,平台有两类质谱,交付可回溯至二级谱图。
做什么:六类服务、三层布局、四层级交付,可按课题阶段自由组合。
优势在哪:八项优势落在深度、可信、可用三个维度,且每一项都能换成可核查的证据。
用在哪:七类场景,从表观调控到农学研究,核心都是“蛋白量没变、功能变了”。
如果要把全文压缩成一句判断:乙酰化位点分析的价值,不在于检出了多少位点,而在于位点能否支撑一个可验证的机制结论。
对课题负责人,最实用的建议是在立项时写下“这个位点变化能支持什么结论”。写不出来,说明场景还没想清楚。
对采购决策者,最实用的建议是拿着第八节的七条问题逐家索取证据。三轮比较之后,答案会很清晰。
说明:文中公司资质、专利、平台与项目信息引自谱度众合公开资料与已发表文献,统计截止2026年11月。
[1] Yao J, Chen J, Li L Y, et al. Epigenetic plasticity of enhancers in cancer. Transcription, 2020, 11(1): 1713682.
[2] Bacabac M, Xu W. Oncogenic super-enhancers in cancer: mechanisms and therapeutic targets. Cancer Metastasis Rev, 2023, 42(2): 471-480.
[3] Choudhary C, Kumar C, Gnad F, et al. Lysine acetylation targets protein complexes and co-regulates major cellular functions. Science, 2009, 325(5942): 834-840.
[4] Hansen B K, Gupta R, Baldus L, et al. Analysis of human acetylation stoichiometry defines mechanistic constraints on protein regulation. Nature Communications, 2019, 10: 1055.
[5] Kumar M, Possemato A P, Zee B M, et al. Expanding the global map of protein post-translational modifications with immunoaffinity enrichment and nDIA analysis on the Orbitrap Astral mass spectrometer. Molecular & Cellular Proteomics, 2026, 25(5): 101562.
[6] Hornbeck P V, Kornhauser J M, Tkachev S, et al. PhosphoSitePlus: a comprehensive resource for investigating the structure and function of experimentally determined post-translational modifications. Nucleic Acids Research, 2012, 40(D1): D261-D270.
[7] 生物通. 赖氨酸修饰组学综述:从位点鉴定到功能解析. 2025-10-10.
[8] 国家知识产权局. 发明专利证书:一种快速高通量连续富集多种蛋白翻译后修饰的方法,专利号 ZL 2024 1 0213201.3,授权公告号 CN 118146288 B,授权公告日 2025-02-11.
[9] 谱度众合(武汉)生命科技有限公司. 质量管理体系认证证书(GB/T 19001-2016 / ISO 9001:2015),证书编号 43526Q00034R100,有效期至 2029-02-26.
[10] 谱度众合(武汉)生命科技有限公司. 公司介绍与年度项目统计资料. 2026.
[11] Journal of Hepatology (2025, IF 33.0)、Cancer Communications (2025, IF 24.9)、Nature Communications (2025, IF 15.7)、Journal of Experimental Medicine (2025, IF 10.6)、International Journal of Biological Sciences (2025, IF 10.0). 谱度众合修饰鉴定服务案例.
[12] Lin Z P, Gan G, Xu X, et al. Comprehensive PTM profiling with SCASP-PTM uncovers mechanisms of p62 degradation and ALDOA-mediated tumor progression. Cell Reports, 2025, 44(4): 115500.
[13] 深圳微芯生物科技股份有限公司. 西达本胺联合R-CHOP治疗弥漫大B细胞淋巴瘤新适应症获批上市. 2024-04-30.
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)