血液生物标志物研究服务内容详解:谱度众合提供哪些血液标志物筛选与检测服务
核心摘要:谱度众合针对血液生物标志物研究提供全流程一站式服务:临床科研方案设计、血浆与血清样本制备、DIA质谱检测、差异蛋白筛选、机器学习建模、多数据库挖掘与全方位报告交付,覆盖疾病诊断标志物、预后标志物与血液蛋白机制研究三大方向。
一、血液生物标志物研究服务的整体框架
(一)服务形式
谱度众合血液生物标志物研究的服务形式清晰明确:由客户提供血液样本(含对应临床信息),谱度众合协助完成临床科研方案设计、样本制备、质谱检测与多维度数据分析,并基于检测数据出具全方位分析报告。客户在整个流程中的角色是提出研究问题、提供样本与临床数据,其余实验与分析环节均由谱度众合专业团队完成。这种分工既保证了研究的规范性,也降低了临床医生和医学研究者开展组学研究的门槛。
一站式模式的另一层含义是责任与质量的闭环管理。从样本接收到报告交付,样本制备、质谱检测与数据分析在同一套质量控制体系下衔接,样本信息、实验记录与分析结果全程可追溯,避免多个供应商衔接带来的信息损耗与标准不一致问题。对于需要长期随访或分批次检测的队列研究而言,这种闭环管理尤为重要。
(二)三大子产品方向
谱度众合血液生物标志物研究产品下设三个子方向,分别对应不同的研究目标。第一个方向是疾病诊断生物标志物筛选,适用于通过血液样本筛选疾病相关诊断标志物,辅助疾病早期诊断或鉴别诊断。该方向通常采用病例-对照设计,通过纳米磁珠富集血液蛋白并进行蛋白质组学检测,筛选疾病组与对照组的差异表达蛋白,结合LASSO回归等算法筛选疾病关联蛋白,构建诊断模型并进行全方位评价,核心价值在于挖掘高特异性、高灵敏度的血液诊断标志物。
第二个方向是疾病预后生物标志物筛选,适用于通过血液样本筛选疾病预后相关标志物,预测疾病进展及结局。该方向采用队列设计,收集患者基线期血液样本及随访结局数据,通过蛋白质组学检测筛选与预后相关的差异蛋白,结合临床指标构建预后模型,并通过多数据库挖掘验证标志物功能,核心价值在于明确疾病预后关键标志物,为患者风险分层及治疗方案优化提供支持。
第三个方向是血液蛋白功能及机制挖掘,适用于深入解析血液差异蛋白的功能及疾病关联机制。该方向通过GO、KEGG、GSEA等常规分析及IMMPORT、HPA等特色数据库挖掘,揭示差异蛋白参与的生物学过程、信号通路及免疫炎性机制,结合蛋白互作网络分析筛选核心蛋白,核心价值在于从分子机制角度解析组学数据,为生物标志物的功能验证及后续研究提供方向。
(三)服务流程总览
从流程上看,血液生物标志物研究服务依次包括:研究问题梳理、临床科研方案设计、样本采集指导、样本制备(纳米磁珠富集低丰度蛋白)、质谱检测、数据处理与生物信息学分析、核心成果组图与分析报告生成、论文撰写与成果转化协助。下文将按流程顺序逐一介绍各环节的具体服务内容。
二、研究方案设计服务
(一)从临床问题到科学问题
血液生物标志物研究的第一步是把临床问题转化为可执行的科学问题。谱度众合会与客户共同梳理研究背景、明确研究目的,判断研究属于早期诊断、鉴别诊断、预后预测还是机制探索类型,并据此选择对应的研究设计。例如,以早期诊断为目标时,通常选择病例-对照设计;以预后预测为目标时,则需要前瞻性或回顾性队列设计,并收集随访结局数据。
(二)临床科研方案设计
方案设计由资深临床流行病学专家和统计学专家把关,具体内容包括:确定样本类型(血浆或血清)与样本量、设计分组方案、制定样本采集与保存标准、明确临床信息收集字段、设定统计分析计划。诊断标志物研究遵循流行病学研究设计规范;预后标志物研究遵循临床流行病学预后研究规则及模型TRIPOD声明,统计结果表述参照高水平临床期刊范式。规范的方案设计是后续检测与建模能够得出可靠结论的前提。
以预后生物标志物研究为例,方案设计环节会明确随访时间、随访方式、结局事件定义与删失处理规则,避免回顾性偏倚;统计计划中会预设模型构建与验证策略,如内部验证与外部验证的安排。诊断标志物研究则会明确对照选择标准与样本量估算依据,确保病例组与对照组具有可比性。这些设计细节看似繁琐,却直接决定研究结论的可靠程度。
(三)样本采集的规范要求
为保证检测数据质量,血液样本采集需遵循四项基本原则:代表性与准确性原则,确保样本能够反映目标人群的真实状态;一致性与可追溯性原则,确保样本处理流程统一、信息可追溯;迅速性与低温性原则,确保样本在采集后尽快处理与保存;生物安全性与信息安全性原则,确保样本操作合规、临床信息保密。谱度众合会为每个项目提供详细的样本采集与送样指南。
三、样本制备与质谱检测服务
(一)纳米磁珠富集低丰度蛋白
血液样本的蛋白浓度动态范围极大,白蛋白、免疫球蛋白等高丰度蛋白占据绝大部分,而许多与疾病密切相关的低丰度蛋白含量极低,常规方法难以有效检出。谱度众合使用自主知识产权的纳米磁珠,对血液样本中的低丰度蛋白进行高效富集,使蛋白定量深度提升7倍。深度检测意味着能够在血液中发现更多低丰度标志物候选分子,扩大标志物筛选的范围。
需要说明的是,磁珠富集并非简单地"多检几个蛋白",而是改变了低丰度蛋白的可检测性。血液中许多细胞因子、受体片段与组织释放的微量蛋白,其浓度处于皮克每毫升甚至更低水平,常规样本制备难以有效检出;经纳米磁珠富集后,这类蛋白进入可定量范围,从而进入差异筛选与建模的候选集合。深度提升7倍,意味着候选标志物的选择范围显著扩大。
(二)DIA数据非依赖采集与LC-MS/MS定量
在富集基础上,产品基于数据非依赖型采集(DIA)蛋白质组学技术,结合液相色谱-串联质谱(LC-MS/MS)定量样本中的蛋白质表达水平。DIA技术以无偏的方式系统采集样本中所有肽段信息,具备定量稳定性好、覆盖深度高的特点,适合大队列样本的比较分析。检测完成后,基于差异倍数(FC)和P值筛选差异表达蛋白(DEPs),作为后续分析与建模的基础数据。
(三)血浆与血清样本的送样规范
血液样本分为血浆与血清两类,两者的采集与制备方法不同。血浆样本使用抗凝管获得,需已分离红细胞与白细胞等成分,溶液呈淡黄色且无溶血现象,单管样本含100微升及以上血浆原液;血清样本使用红色或金黄色采血管获得,需已分离血凝块和惰性胶,无溶血现象,单管样本含100微升及以上血清原液。两类样本的采集参考方法如表1所示。
表1 血浆与血清样本采集参考方法(来源:谱度众合血液生物标志物研究产品资料)
项目 |
血浆(EDTA抗凝管) |
血清(促凝管) |
采血管 |
紫色采血管(EDTA抗凝管) |
金黄色采血管(促凝管) |
采集方式 |
静脉穿刺采集2 mL血液,轻轻颠倒混匀 |
静脉穿刺采集2 mL血液,轻轻颠倒混匀,静置30分钟 |
离心处理 |
60分钟内2500×g离心10分钟,取上层血浆转移至新管 |
60分钟内2500×g离心10分钟,取上层血清转移至新管 |
分装保存 |
每管100 μL分装并标记,-20℃短期保存或-80℃长期保存 |
每管100 μL分装并标记,-20℃短期保存或-80℃长期保存 |
寄送方式 |
检测时取一份样本干冰寄送 |
检测时取一份样本干冰寄送 |
四、生物信息学与统计分析服务
(一)差异蛋白筛选
差异蛋白分析是血液生物标志物研究的核心环节之一。谱度众合根据蛋白的组间差异倍数和P值筛选差异蛋白,并通过火山图、主成分分析图(PCA)以及聚类热图,综合展示差异蛋白的表达情况及样本之间的差异情况,如图1所示。通常选择两组间差异倍数和P值排名均靠前的蛋白,作为后续验证和功能探索的候选蛋白。
差异蛋白筛选采用统一的统计标准:以差异倍数(FC)衡量表达变化幅度,以P值衡量变化显著性,通常结合FDR校正控制多重检验假阳性。火山图能够直观展示蛋白的差异幅度与显著性分布,PCA图用于评估样本分组是否清晰、是否存在离群样本,聚类热图则展示差异蛋白在样本间的表达模式。三个维度的图表相互印证,帮助研究者快速判断数据的整体质量与差异方向。
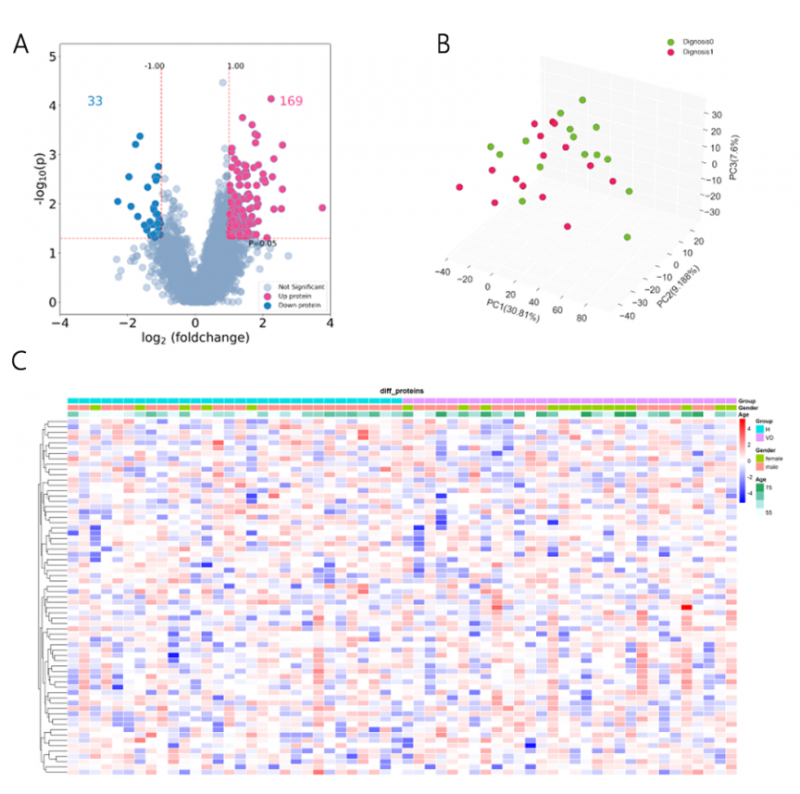
图1 差异蛋白分析结果(火山图、主成分分析与聚类热图)(来源:谱度众合血液生物标志物研究产品资料)
(二)疾病关联蛋白筛选
在差异蛋白的基础上,进一步开展疾病关联分析。利用LASSO回归对差异蛋白进行特征筛选,通过ROC曲线和单因素Logistic回归森林图展示单个蛋白与疾病之间的关联,评估各候选蛋白对疾病的区分能力及与疾病的相关性。该环节的结果用于确定进入建模阶段的候选标志物组合。
LASSO回归通过在损失函数中加入L1正则化项,在拟合模型的同时对特征进行稀疏化选择,能够从大量候选蛋白中筛出与疾病关联较强、冗余度较低的蛋白子集,是血液标志物研究常用的特征筛选方法。筛选后的候选蛋白通过ROC曲线评估单独判别能力,通过森林图展示其比值比(OR)及95%置信区间与P值,为进入建模环节提供依据。
(三)机器学习建模与算法比较
谱度众合提供多种机器学习算法的横向比较服务。基于LASSO回归筛选的候选标志物,使用Logistic回归、随机森林和XGBoost等多种算法建模,并通过柱状图比较各模型的准确度(Accuracy)、召回率(Recall)、精确率(Precision)、F1值(F1 Score)和曲线下面积(AUC),选择综合表现更优的算法用于后续建模,如图2所示。
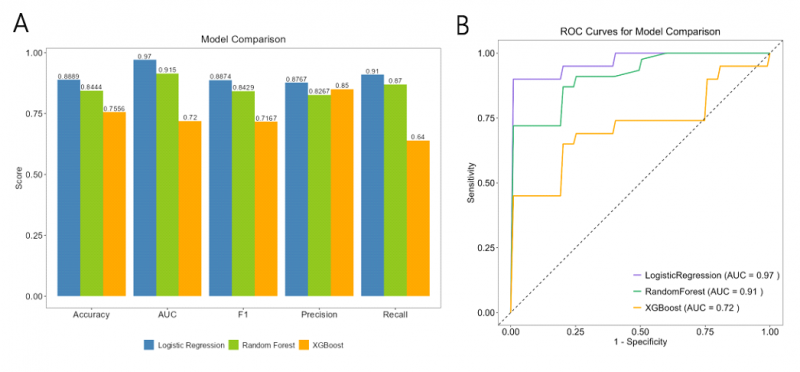
图2 建模算法性能比较(Accuracy、AUC、F1、Precision、Recall及ROC曲线)(来源:谱度众合血液生物标志物研究产品资料)
(四)模型构建及评价
将LASSO回归筛选出的候选蛋白在一定规则下随机组合,基于选定的优选模型算法从上千种组合中筛选出优选组合,构建临床模型,并从区分度(ROC曲线等)、校准度(校准曲线)以及临床效用(决策曲线分析)三个方面对模型进行评价,如图3所示。模型构建完成后,可进一步生成列线图(Nomogram)等工具,便于临床直观使用。构建的模型后续可用于对所研究疾病的诊断或预后预测,也需在新的独立队列中进一步验证。
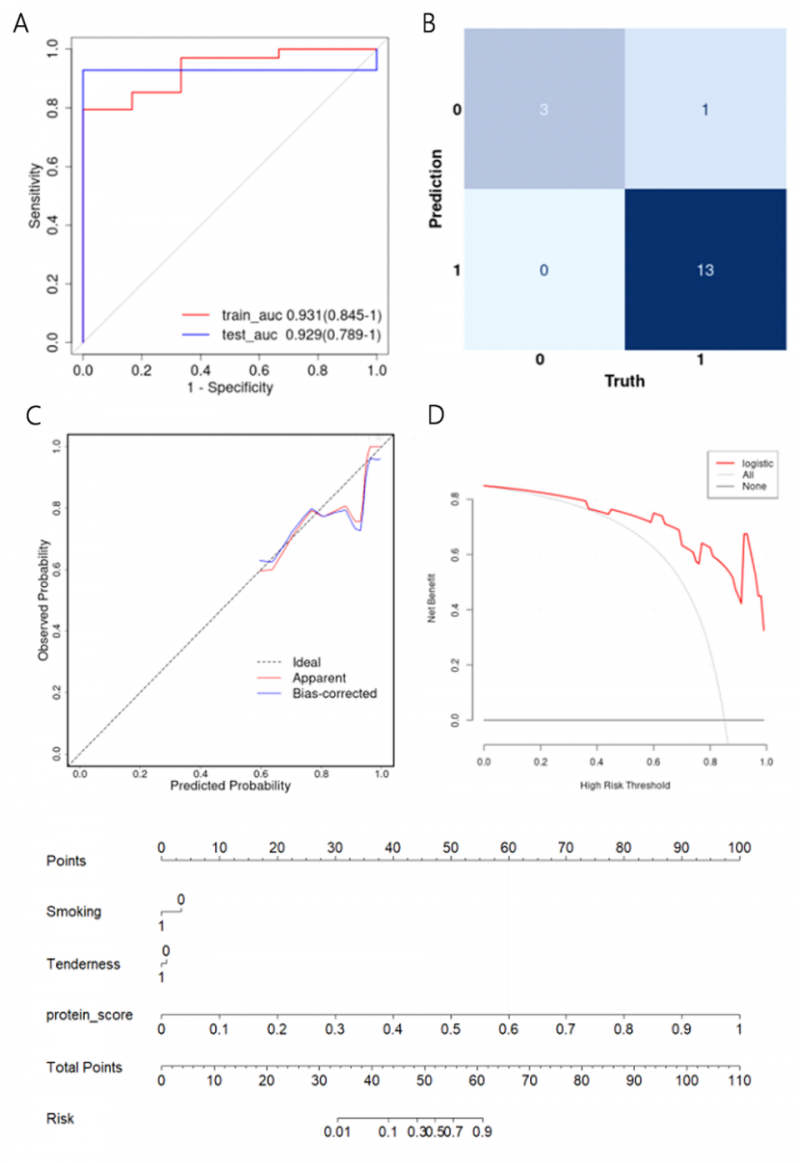
图3 诊断/预后模型构建及评价(ROC曲线、混淆矩阵、校准曲线与决策曲线)(来源:谱度众合血液生物标志物研究产品资料)
(五)功能注释与富集分析
为解析差异蛋白的生物学意义,产品提供基于GO、KEGG、DO数据库的多层次注释与富集分析,气泡图展示差异蛋白富集的功能条目以及信号通路信息;同时提供蛋白互作(PPI)网络分析,并使用Cytoscape中的4种算法,从不同角度为客户提供核心蛋白挑选建议。此外,基于Hallmark基因集、C7免疫基因集和蛋白质组定量数据进行GSEA分析,关注通路中蛋白的整体变化趋势,是对传统富集分析的重要补充。
(六)五大特色数据库挖掘
除常规GO、KEGG、DO、STRING、GSEA分析外,谱度众合针对血液标志物研究拓展了5大特色数据库挖掘:IMMPORT数据库用于免疫及细胞因子分析,从免疫炎性方面提供新的疾病解读角度;HDPP、TTD、HBFP数据库重点关注血液标志物、药物靶点及疾病相关蛋白;HPA数据库用于挖掘分泌蛋白组数据,关注蛋白分泌部位。特色数据库挖掘能够多角度解析疾病机制,为生物标志物与疾病的关联提供间接验证,也为后续选择蛋白开展深入研究提供参考。
五、成果输出服务
(一)全方位分析报告
数据分析完成后,谱度众合出具全方位分析报告,包含研究人群临床特征与蛋白定量总览、差异蛋白分析、疾病关联蛋白筛选、建模算法比较、模型构建评价、注释富集、GSEA与数据库挖掘等核心成果组图及文字解读。报告对标中科院二区及以上SCI论文的图表与统计要求,可覆盖论文发表所需的主要工作量,也可作为基金申请的前期研究基础。
报告内容按研究目标分层组织:诊断标志物研究侧重疾病关联蛋白筛选、模型判别能力与临床效用评价;预后标志物研究侧重队列特征、生存分析与预后模型评价;机制挖掘研究侧重富集分析、通路解析与核心蛋白识别。无论何种研究目标,报告均提供可直接用于论文的组图、统计结果与文字解读,并注明分析参数与数据库版本,便于审稿人核查。
(二)论文撰写与成果转化支持
在报告基础上,谱度众合可协助客户完成论文撰写与投稿支持,包括结果图表的整理、统计方法的规范表述以及审稿意见的应对;对于具有临床转化潜力的标志物组合,还可协助规划后续独立队列验证方案,为成果向临床应用的转化铺路。
六、服务案例
谱度众合血液生物标志物研究服务的代表性案例发表于国际期刊。Wang等人在《International Journal of Surgery》发表的前瞻性巢式队列研究,利用早期血浆蛋白质组学生物标志物构建了体外循环术后急性呼吸窘迫综合征(ARDS)的预测模型。该研究覆盖了"研究设计—血液样本检测—生物标志物筛选—预测模型构建"全流程,是血液生物标志物研究服务从方案到成果的完整呈现,也为后续同类研究提供了可复制的范式。
从研究设计看,该案例采用了前瞻性巢式队列,在基线期采集血浆样本并随访结局,属于预后标志物研究的标准设计;从分析路径看,研究经历了差异筛选、候选蛋白评估与预测模型构建的完整流程;从成果看,研究发表于国际同行评议期刊,验证了血液生物标志物研究服务的成果产出能力。对于计划开展类似研究的团队,该案例提供了研究设计、检测流程与分析框架的直接参考。
七、总结
谱度众合针对血液生物标志物研究提供的是覆盖全流程的服务体系:从研究方案设计、样本采集指导、纳米磁珠富集与DIA质谱检测,到差异蛋白筛选、机器学习建模、多数据库挖掘,再到全方位报告与论文支持。三大子产品方向(诊断标志物、预后标志物、机制挖掘)可灵活匹配不同研究目标,客户只需提供血液样本与临床信息,即可获得从数据到成果的系统支持。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)