
1.一个数字,撕开AI基建的新命题
2026年6月,中国信通院发布《大模型词元服务性能监测报告》——中国日均Token消耗量已达500万亿个。这个数字足够震撼:回溯至2024年初,国内日均Token消耗仅为1000亿,两年间Token消耗实现千倍级增长(国家数据局口径:2026年3月国内日均Token规模已达140万亿)。谷歌的数据同样印证这一趋势:全系AI产品月处理Token超3.2万亿,Gemini API每分钟吞吐达220亿Token。
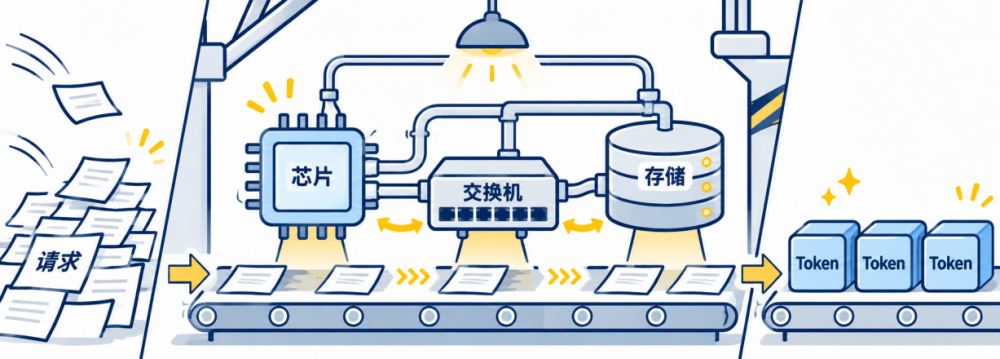
这一增长数据,标志产业已经跨过“算力稀缺”的早期阶段,正式迈入Token经济学主导的规模化生产周期。Token不再只是模型运行的技术指标,而是智能时代标准化的生产要素、价值结算单元,推理业务取代训练,成为基础设施投入的核心主战场。算力供给的瓶颈,已经从“有没有卡”,转向“能不能把算力高效转化为高性价比Token产能”。
2.Agentic AI:把输入"拉长",把KV cache变成战略资产
驱动这场底层变革的核心变量,是Agentic AI从技术探索走向产业规模化部署。
当前主流大模型上下文窗口已突破百万Token,深度调研、工具调用、多轮长程规划成为Agent的标准动作。华为在HC2026上明确提出,10万亿参数级大模型逐步普及,复杂Agent任务持续推高上下文长度,推理过程中产生的KV Cache体量呈爆发式增长。
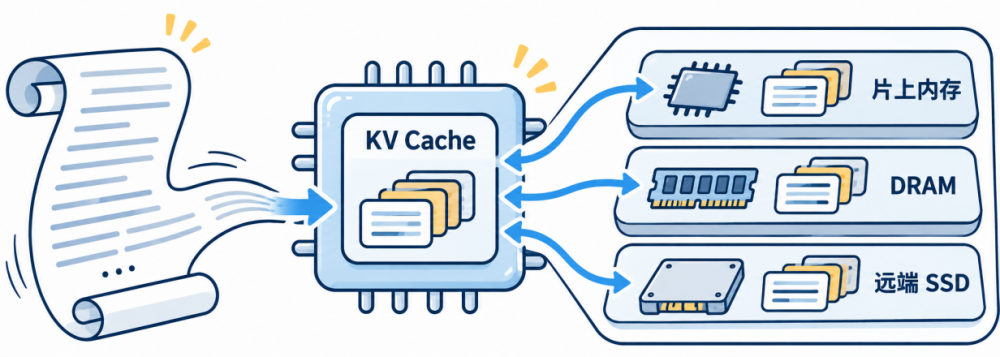
KV Cache,是模型读取历史上下文的核心缓存数据,每一轮Agent思考都需要反复读取、复用这份缓存。但GPU HBM、板载DRAM的容量与成本天花板已经显现,无法持续承载百万Token级场景下的海量KV Cache。行业共识逐步形成:必须打破缓存本地绑定的限制,搭建片上内存—DRAM—远端SSD的多级共享缓存体系,把KV Cache从GPU内部的临时数据,升级为可全局调度、可反复复用、决定Token成本曲线的核心战略资产。
3.烟囱式组网:算力的"孤岛诅咒",制约Token产业规模化
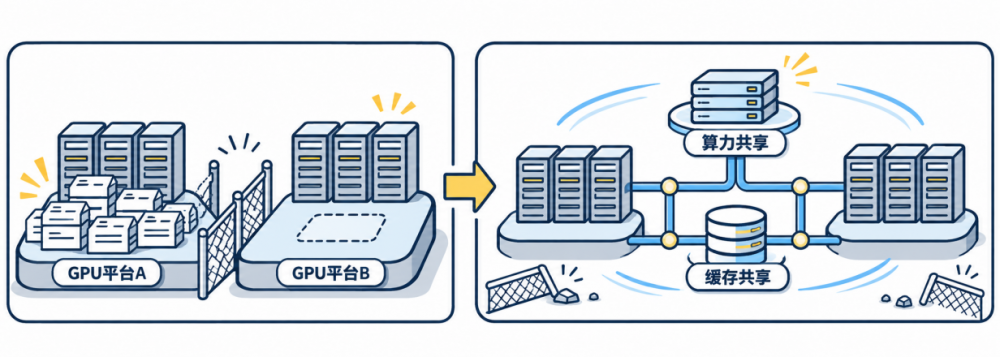
推理集群的组网架构,正在成为大模型商业化落地的核心变量。传统的烟囱式组网将算力、显存、KVCache与网络资源按业务封闭划分,形成一座座算力孤岛,成为Token产业规模化的隐形枷锁。
烟囱式架构下,各业务域资源相互隔离,无法跨模型、跨业务调度复用,显存与算力碎片问题突出,GPU利用率长期偏低。推理负载天然具备潮汐特征,业务只能按流量峰值预留资源,低谷时段大量算力空转,推高单位Token成本。同时KVCache被锁在业务烟囱内部,相同提示词、长上下文前缀无法共享,重复计算持续消耗算力。
面对这一困境,字节、美团、京东等头部OTT纷纷转向池化建网路线,以Prefill与Decode解耦、全局KVCache池化、统一算力调度重构推理底座。字节依托EIC分布式缓存,借助GPU Direct RDMA大幅压低KV访问时延;美团LongCat-2.0将Prefill、Decode 拆为独立资源池,适配长上下文推理;京东云通过池化调度,实现训推混部与弹性扩缩,集群利用率显著提升。实测数据显示,池化方案可将KVCache命中率提升至92.2%,有效请求容量最高提升近5倍,同时节省26%的GPU卡时成本。
4.PD分离:把推理拆成两个"专业队",重构推理资源范式
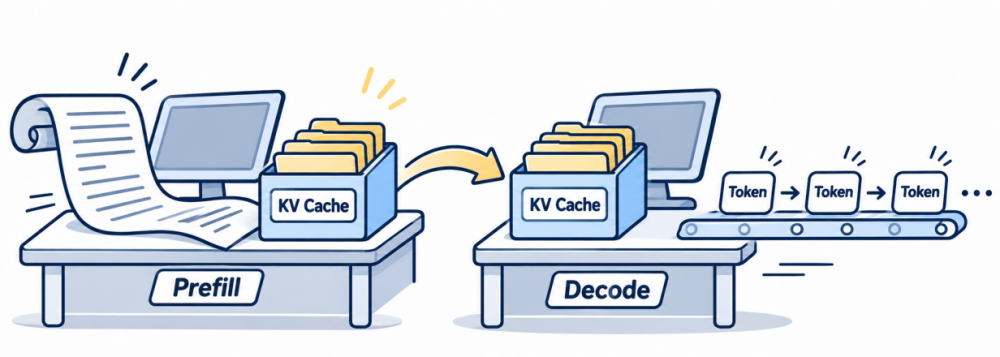
架构重构的另一关键方向,来自产业对推理负载本质的重新认知:推理不是单一负载,而是两类完全不同的生产工序。
Prefill(预填充)负责一次性消化超长上下文输入,属于计算密集型任务;Decode(解码)负责逐Token持续生成,是典型内存带宽密集型负载。两类负载混跑在同一批算力池内,资源分配互相妥协,很难同时兼顾算力利用率、时延与成本。PD分离(Prefill-Decode Disaggregation)架构由此成为业界主流范式:将推理资源拆分为独立双池,Prefill池部署高算力芯片承接超长上下文计算,Decode池采用带宽优化型芯片专注Token生成,实现专业分工、弹性扩缩。
OSDI 2024论文验证,在相同SLO时延约束下,PD分离架构可支撑7.4倍的并发请求;华为CloudMatrix384更进一步,实现Prefill、Decode、通信三段解耦,支持异构部署,Prefill任务跑在昇腾算力,Decode池根据业务特征灵活选配芯片。PD分离的普及,标志推理基础设施从“同构集群”时代,正式走向异构分池、按需调度的工业化生产阶段,为KV Cache全局拉远、跨池共享铺平架构底座。
5.KV Cache池化重构推理底座:产业界典型实践
PD分离架构落地之后,KV Cache跨池调度、远程加载,上升为整个推理体系的核心瓶颈。当Prefill与Decode资源池解耦,海量KV Cache不再局限于单卡、单节点内存空间,必须向外延伸至远端共享存储池。这不是单点技术优化,而是一场贯穿网络、存储、芯片、调度体系的系统性重构。围绕KV Cache拉远存储这条主线,我们看到业界已经有不同的实践和探索。
华为在HC2026推出的HCF超融合Fabric搭配OceanStor M900分级KV存储方案,打造原生算网存一体底座。针对Agent场景下KV Cache规模爆炸、传统三层架构割裂的痛点,这套方案以灵衢UB网络为底座,打通计算、网络、存储,构建PB级全局共享KV Cache资源池。它的核心思路,是从交换机、DPU、存储盘框全栈重构硬件与协议,将KV Cache作为一等公民,构建深度融合的算网存底座,面向超大规模Token工厂提供原生一体化方案。
英伟达则以Dynamo开源推理框架作为PD分离的软件中枢,走出一套 “软件解耦 + 硬件分级” 的路线。面向下一代Agentic AI长上下文场景,英伟达推出了Vera Rubin平台,采用原生异构PD设计:Rubin GPU集群承接Prefill与Decode Attention高吞吐负载,Groq 3 LPX LPU集群专职低延迟FFN解码,由Dynamo AFD异构调度拉通,把Prefill、Decode的负载差异直接映射到差异化芯片,实现Agent场景下每瓦性能提升10倍。
DeepSeek联合高校团队发布的DualPath方案,依靠软件调度盘活闲置带宽,破解Prefill样本带宽瓶颈。PD分离架构下存在一个典型资源错配难题:所有KV Cache加载流量集中在Prefill网卡,长上下文Agent场景中Prefill侧带宽极易快速打满,算力空转等待数据;而Decode侧网卡带宽长期闲置,资源潜力无法释放。DualPath创新设计双路径加载机制:路径A是传统链路,外部存储数据直送Prefill卡;路径B为新增旁路链路,外部存储数据先下发至Decode缓冲池,再通过高速参数面网络转发至Prefill卡。全局调度器会根据两条链路负载动态分配流量,叠加虚拟优先级隔离技术,保障模型计算通信优先,缓存搬运流量在带宽间隙调度传输,不侵蚀推理时延指标。
6.结语:算力时代,赢在"协同",定义下一代AI基础设施
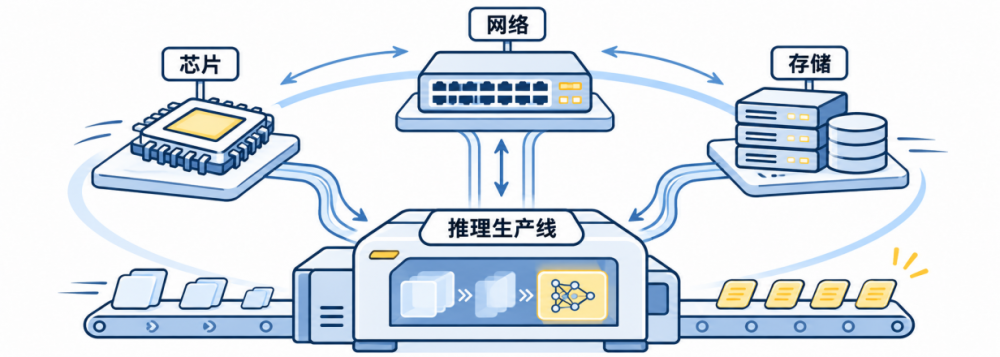
Token高速增长的洪流不会停下。从合池混跑走向PD分池、从烟囱孤岛走向资源池化、从算力单点发力走向算网存协同,AI数据中心正在完成一次代际级架构重构,这也是全球AI基础设施竞争的下半场主线。
过去产业竞争的标尺,是单卡算力、集群规模,而Token经营时代,竞争的核心是算力、网络、存储三者协同形成的系统效率。放眼中长期,算网存协同能力,将决定云厂商、算力服务商、基础设施厂商的长期竞争力。
这场重构的赢家,终将是掌握数据流动能力的玩家。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)