

大模型对算力的渴求,正以前所未有的速度从集中训练延伸至大规模推理。过去评价算力,行业习惯用峰FLOPS或TOPS论英雄;而当千行百业把大模型变成随时响应的服务,能效比、单位Token成本和规模部署能力,正成为新的核心评价维度。传统电计算路径在功耗、散热和海量数据搬运上持续承压——每一次推理都要在外部存储与计算单元之间反复调取动辄百亿、千亿级的模型权重,搬运本身消耗的能源与延迟,常常超过计算本身。
硅光芯片被视为突破上述瓶颈的重要技术路径。它以光子替代电子完成信息传输与计算,天然具备高带宽、低延迟、低功耗的物理优势。不过,随着大模型参数规模和推理需求持续增长,硅光芯片产业化的关键已不止于追求更高的峰值算力,更在于算力提升与能效优化的同步突破。光本位科技给出了新的解题思路。
光本位科技是全球首家商业化的AI光计算系统公司,致力于构建高能效、大规模的新一代全栈式光计算系统。公司开创性地将存储与计算融合于同一光学通路,AI大模型参数可直接存储在光计算芯片内部,无需在外部存储与计算单元间频繁传输,实现模型权重静态保持功耗为零,从根本上降低了大模型推理中反复搬运海量权重的高昂成本。在集成规模上,公司目前已在单颗晶粒上集成65000+光计算单元,在研方案将单片集成百万量级光计算单元。
这一架构的演进有清晰的技术坐标。继2024年6月流片全球首颗达商用标准的128×128硅基光计算芯片后,光本位科技在短短两年内实现矩阵规模翻倍与性能跃迁。2026年7月,光本位科技于WAIC 2026全球首发256×256硅基光计算芯片,该芯片是目前全球矩阵规模最大的全可编程光计算芯片。
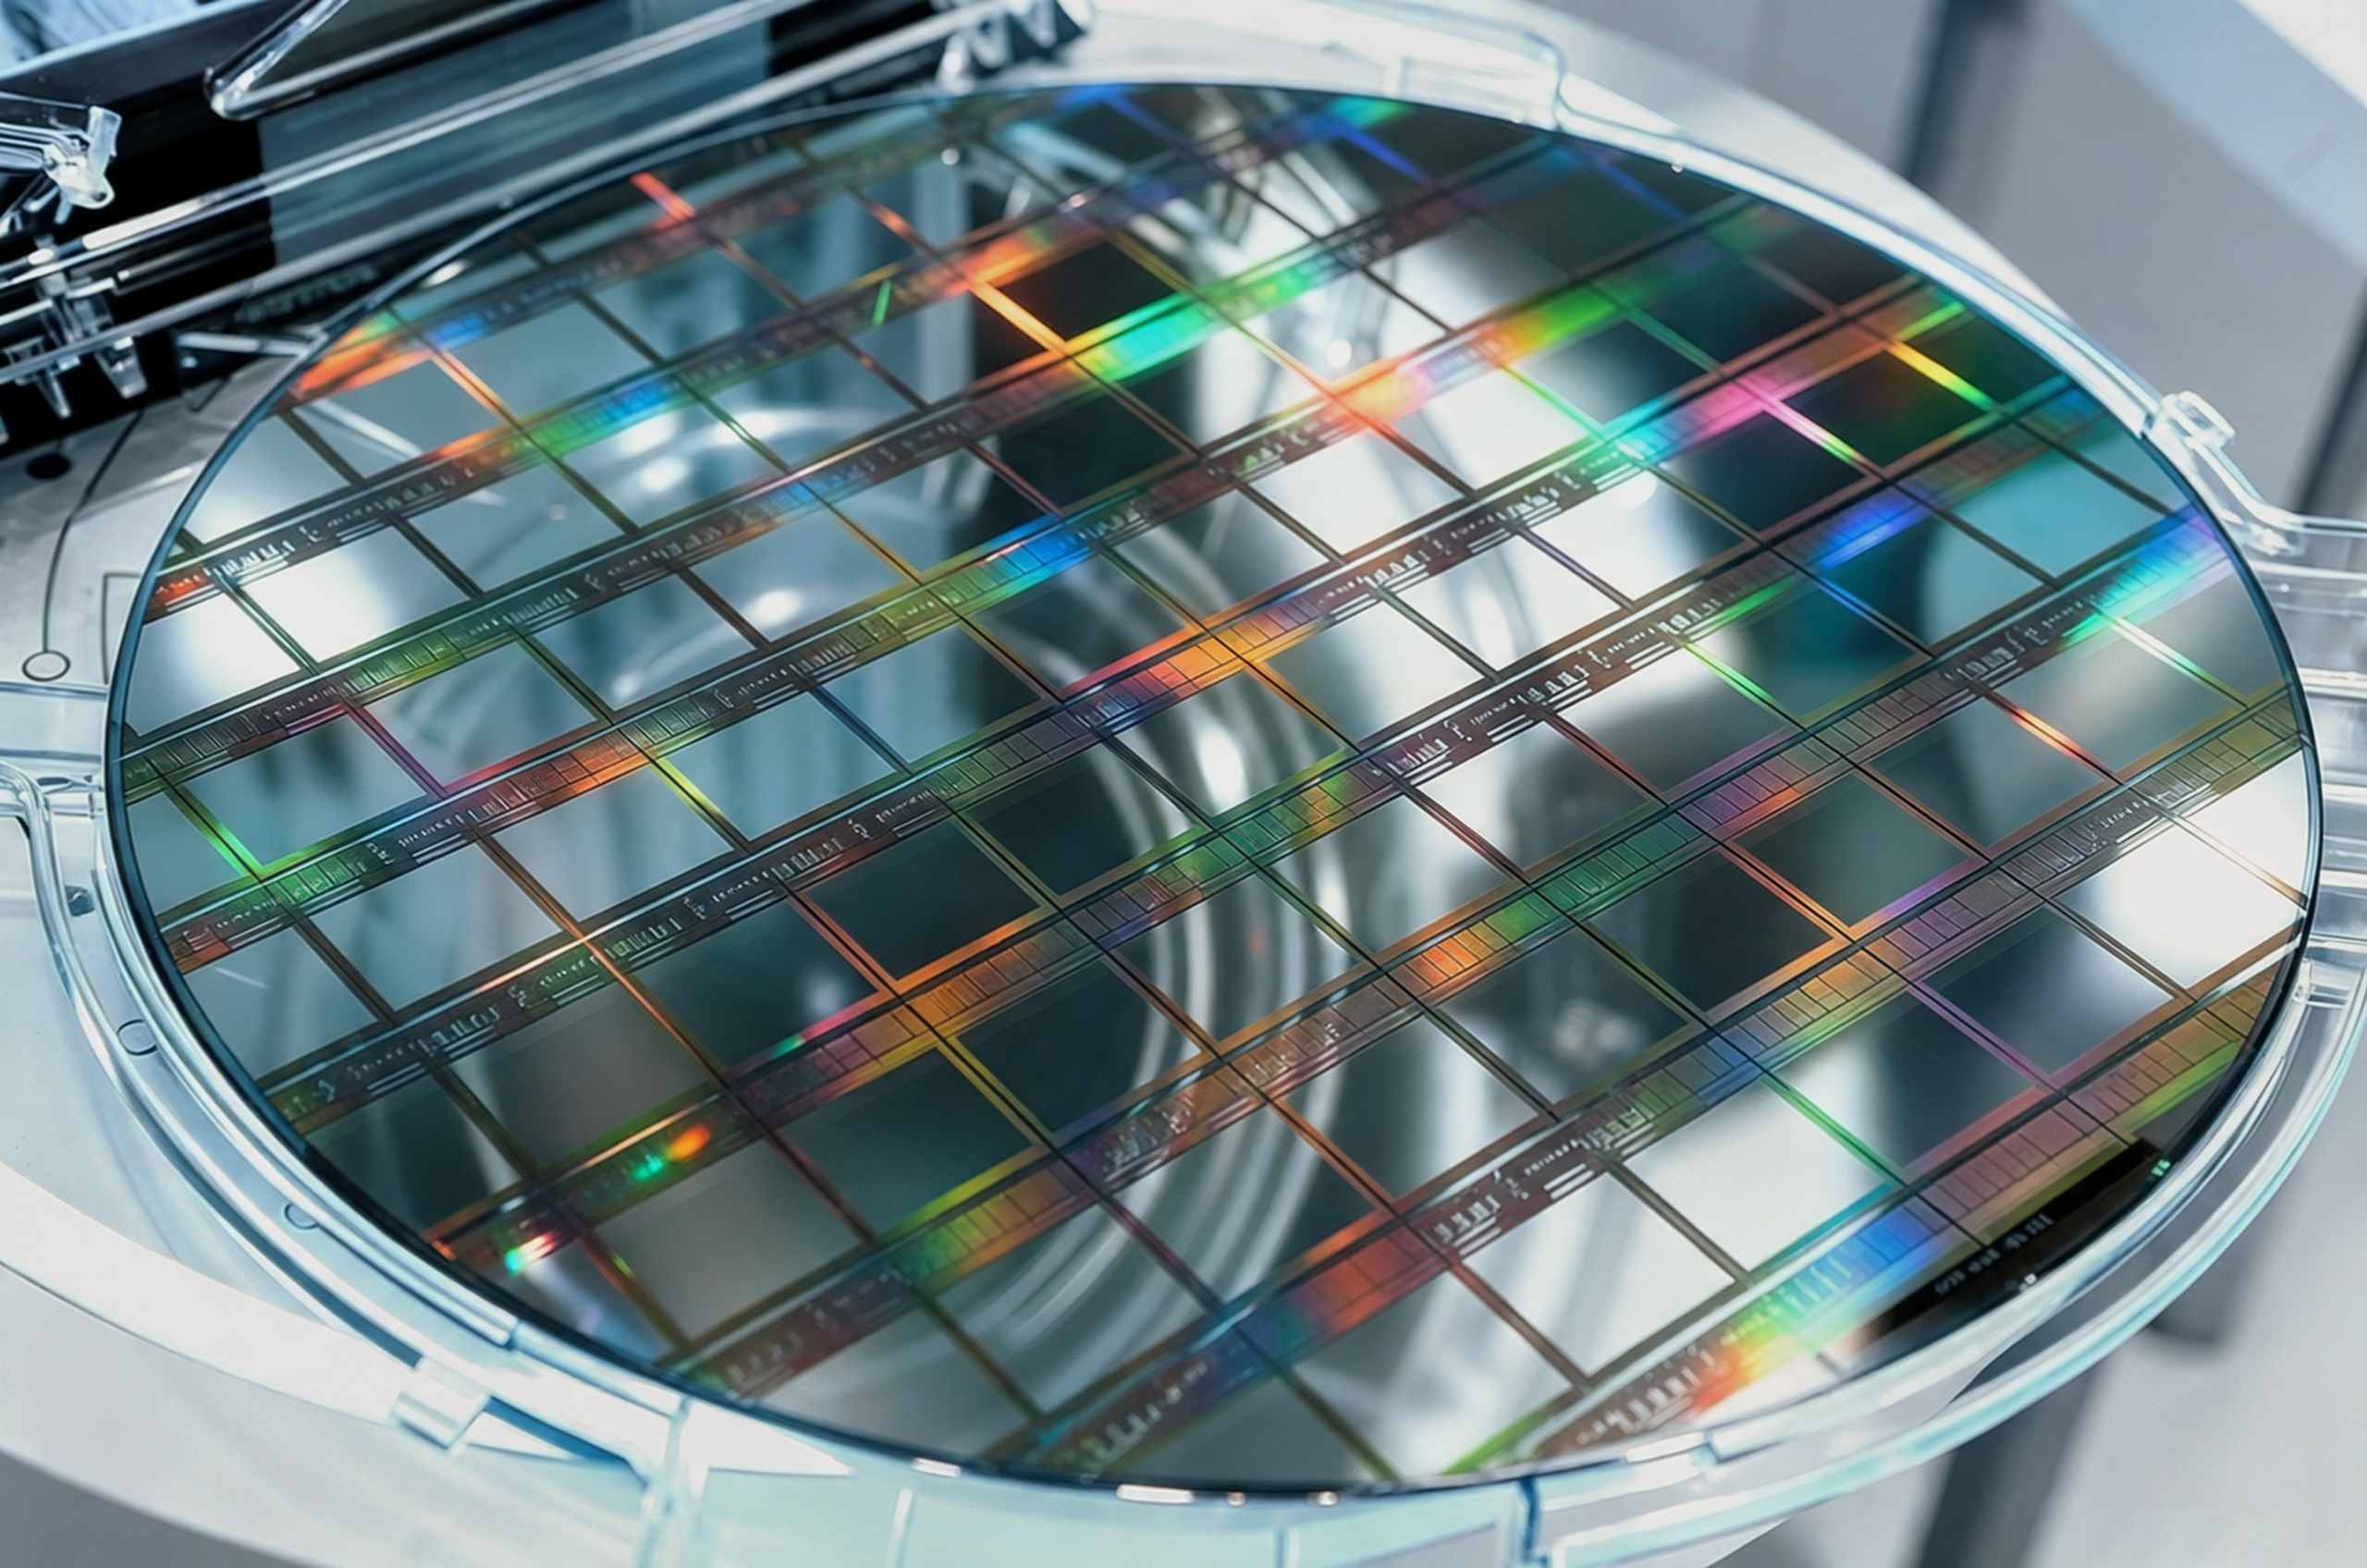
算力跃迁的落点在于系统级产品。基于256×256硅基光计算芯片,光本位科技将推出第二代光电融合计算卡,单卡算力由第一代的百TOPS级跃升至千TOPS级,综合性能可对标国际主流AI推理GPU。在能效维度,经测算,若算力中心大规模部署其光电融合计算卡,整体年耗电量有望降至现有方案的1%左右,为绿色算力基础设施提供了可行的新型技术方案。公司已累计获得数十亿元融资,资本对其前瞻性布局和快速商业化给出了分量十足的反馈。
技术突破之外,产业化底座同样关键。目前,光本位科技的光计算产品已服务头部科技大厂、垂类AI公司、智算中心等数十家客户。公司产品应用于垂类模型、Token工厂、智算中心,并全球首创将光计算的应用从地面拓展至太空。在能源极度受限、温差极端且辐射密集的太空环境中,光计算凭借天然抗辐射、近乎零热耗与超高能效比的优势,首次让毫秒级星载 AI 实时处理成为可能,将算力基础设施竞赛从地面推向近地轨道。
从训练到推理,从地面到太空,大模型算力的竞争标尺正在重写。当能效比与单位 Token成本成为产业胜负手,光本位科技以存储与计算融合于同一光学通路的架构创新,为大模型推理提供了高能效、可持续的算力底座,也让我们看到光计算从实验室走向规模化部署的现实路径。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)