
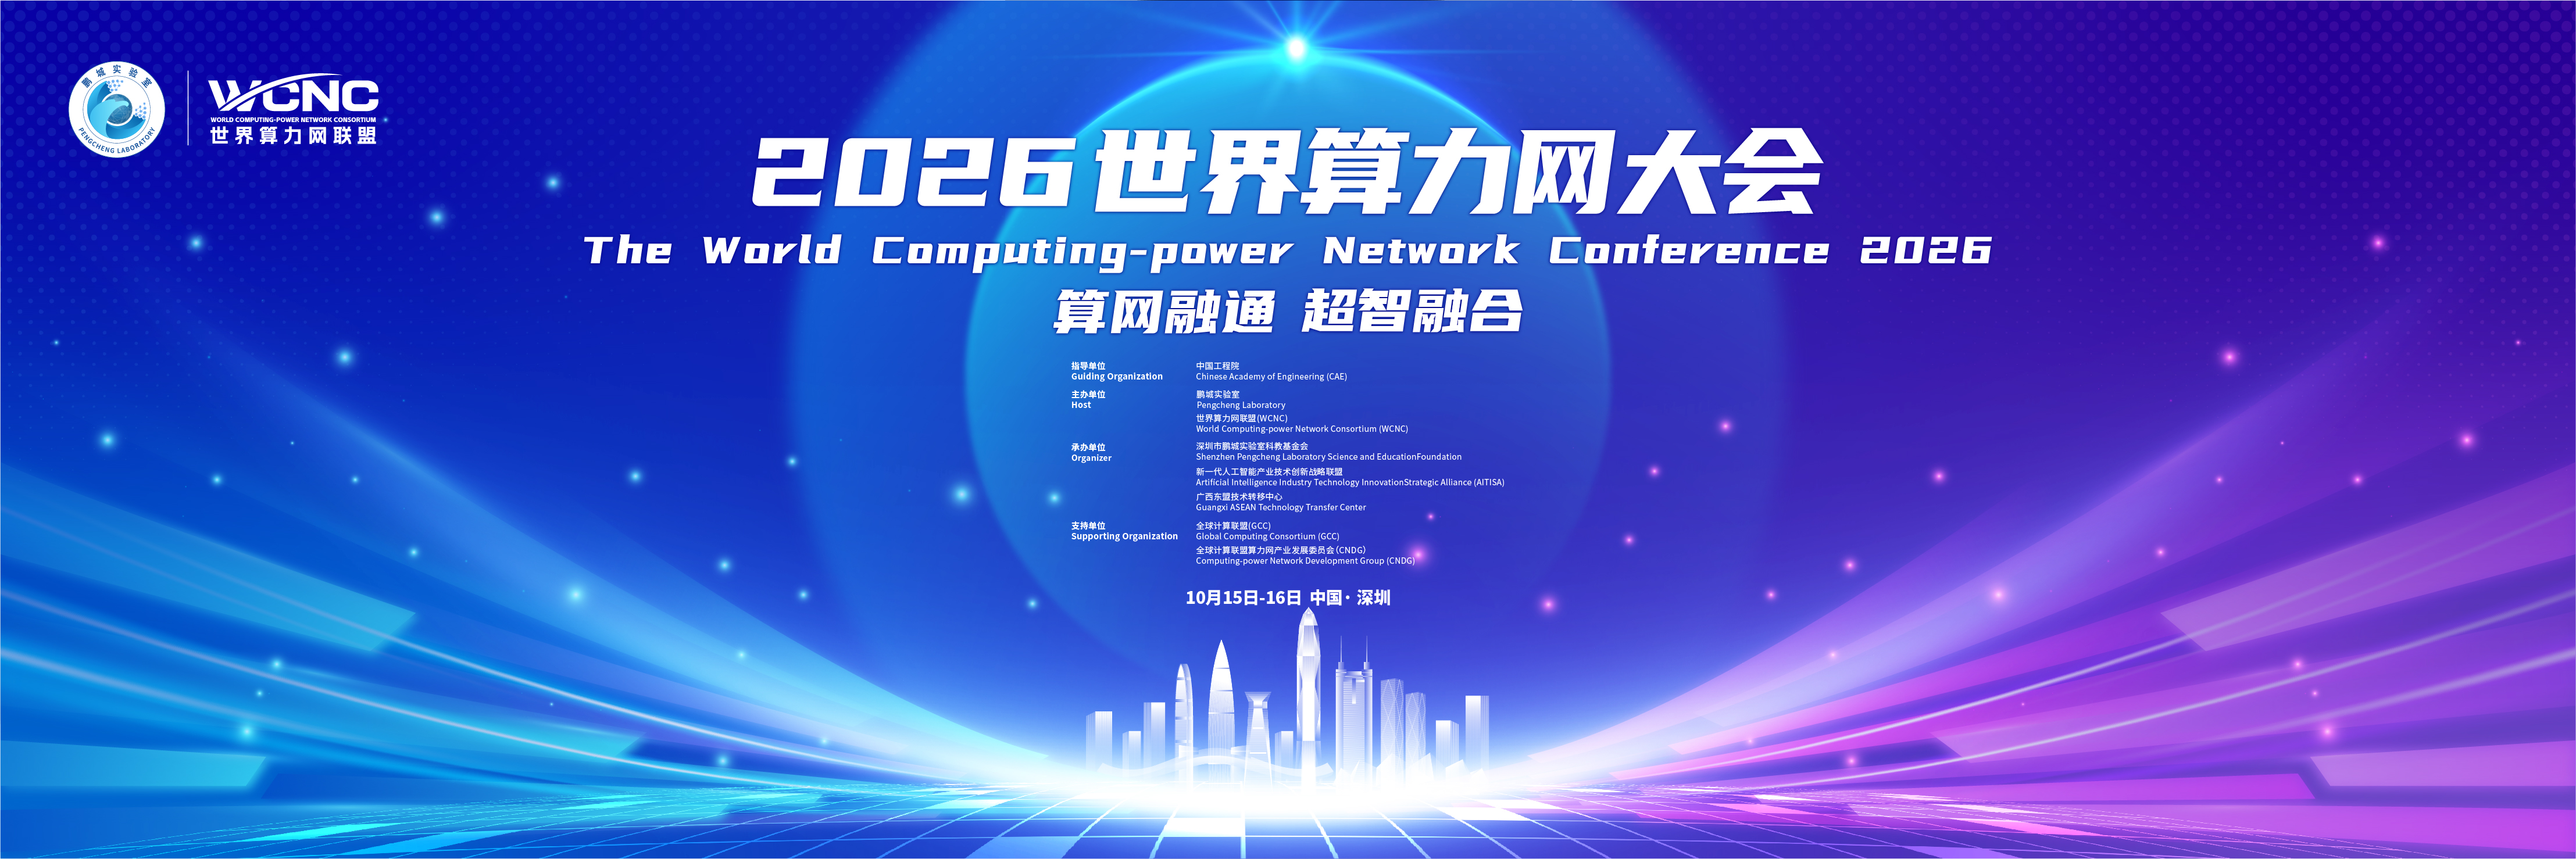
10月15日,以“算网融通 超智融合”为主题的2026世界算力网大会在深圳南山开幕。作为鹏城实验室2026年学术活动周的重要学术交流活动,大会汇聚全球算力、网络、人工智能和能源领域的院士专家、科研机构及产业代表,围绕算力网络化、智能化、绿色化发展展开交流。大会由中国工程院指导,鹏城实验室与世界算力网联盟联合主办,为期两天。
本届大会规模和嘉宾阵容均创新高。图灵奖得主Jack Dongarra,欧洲科学院院士、苏黎世联邦理工学院教授Torsten Hoefler,中国工程院外籍院士、加拿大工程院院士、加拿大皇家学会院士沈学民等国际知名专家在主论坛分享高性能计算、AI网络和边缘智能领域的前沿进展。开幕式还发布“鹏城云脑Ⅲ”最新进展,10000P国产算力正式上线试运行,并发布《世界算力网发展白皮书》和《算电协同技术发展白皮书》。
大会共设置8个分论坛,覆盖算力网络架构与互联互通、基础软硬件、分布式边缘算力网络、光通信与高速互联、算力安全与可信治理等方向。其中,分论坛二“算力网基础软硬件技术”于15日下午举行。论坛由中国地质大学(武汉)主办,天津大学、中山大学协办,曾德泽、李文信、郭得科共同担任论坛主席。来自上海交通大学、清华大学、华中科技大学、天津大学、暨南大学、复旦大学、南京大学及产业界的专家,围绕异构算力调度、模型互联、类脑计算、智能体软件、网络数字孪生和国产超节点优化等议题展开研讨,把大会关于算力互联与协同的讨论进一步推进到基础软硬件协同的工程实践。
面向智能计算重做资源组织方式
欧洲科学院外籍院士、IEEE Fellow、上海交通大学过敏意讲席教授从资源管理、执行框架和请求调度三个层面梳理了智算时代算力网面临的系统问题。他指出,模型规模和词元需求持续增长,单一地域或单一数据中心难以覆盖多样化服务需求,算力网需要跨地域组织CPU、GPU和各类加速器,同时降低资源池化带来的额外开销。
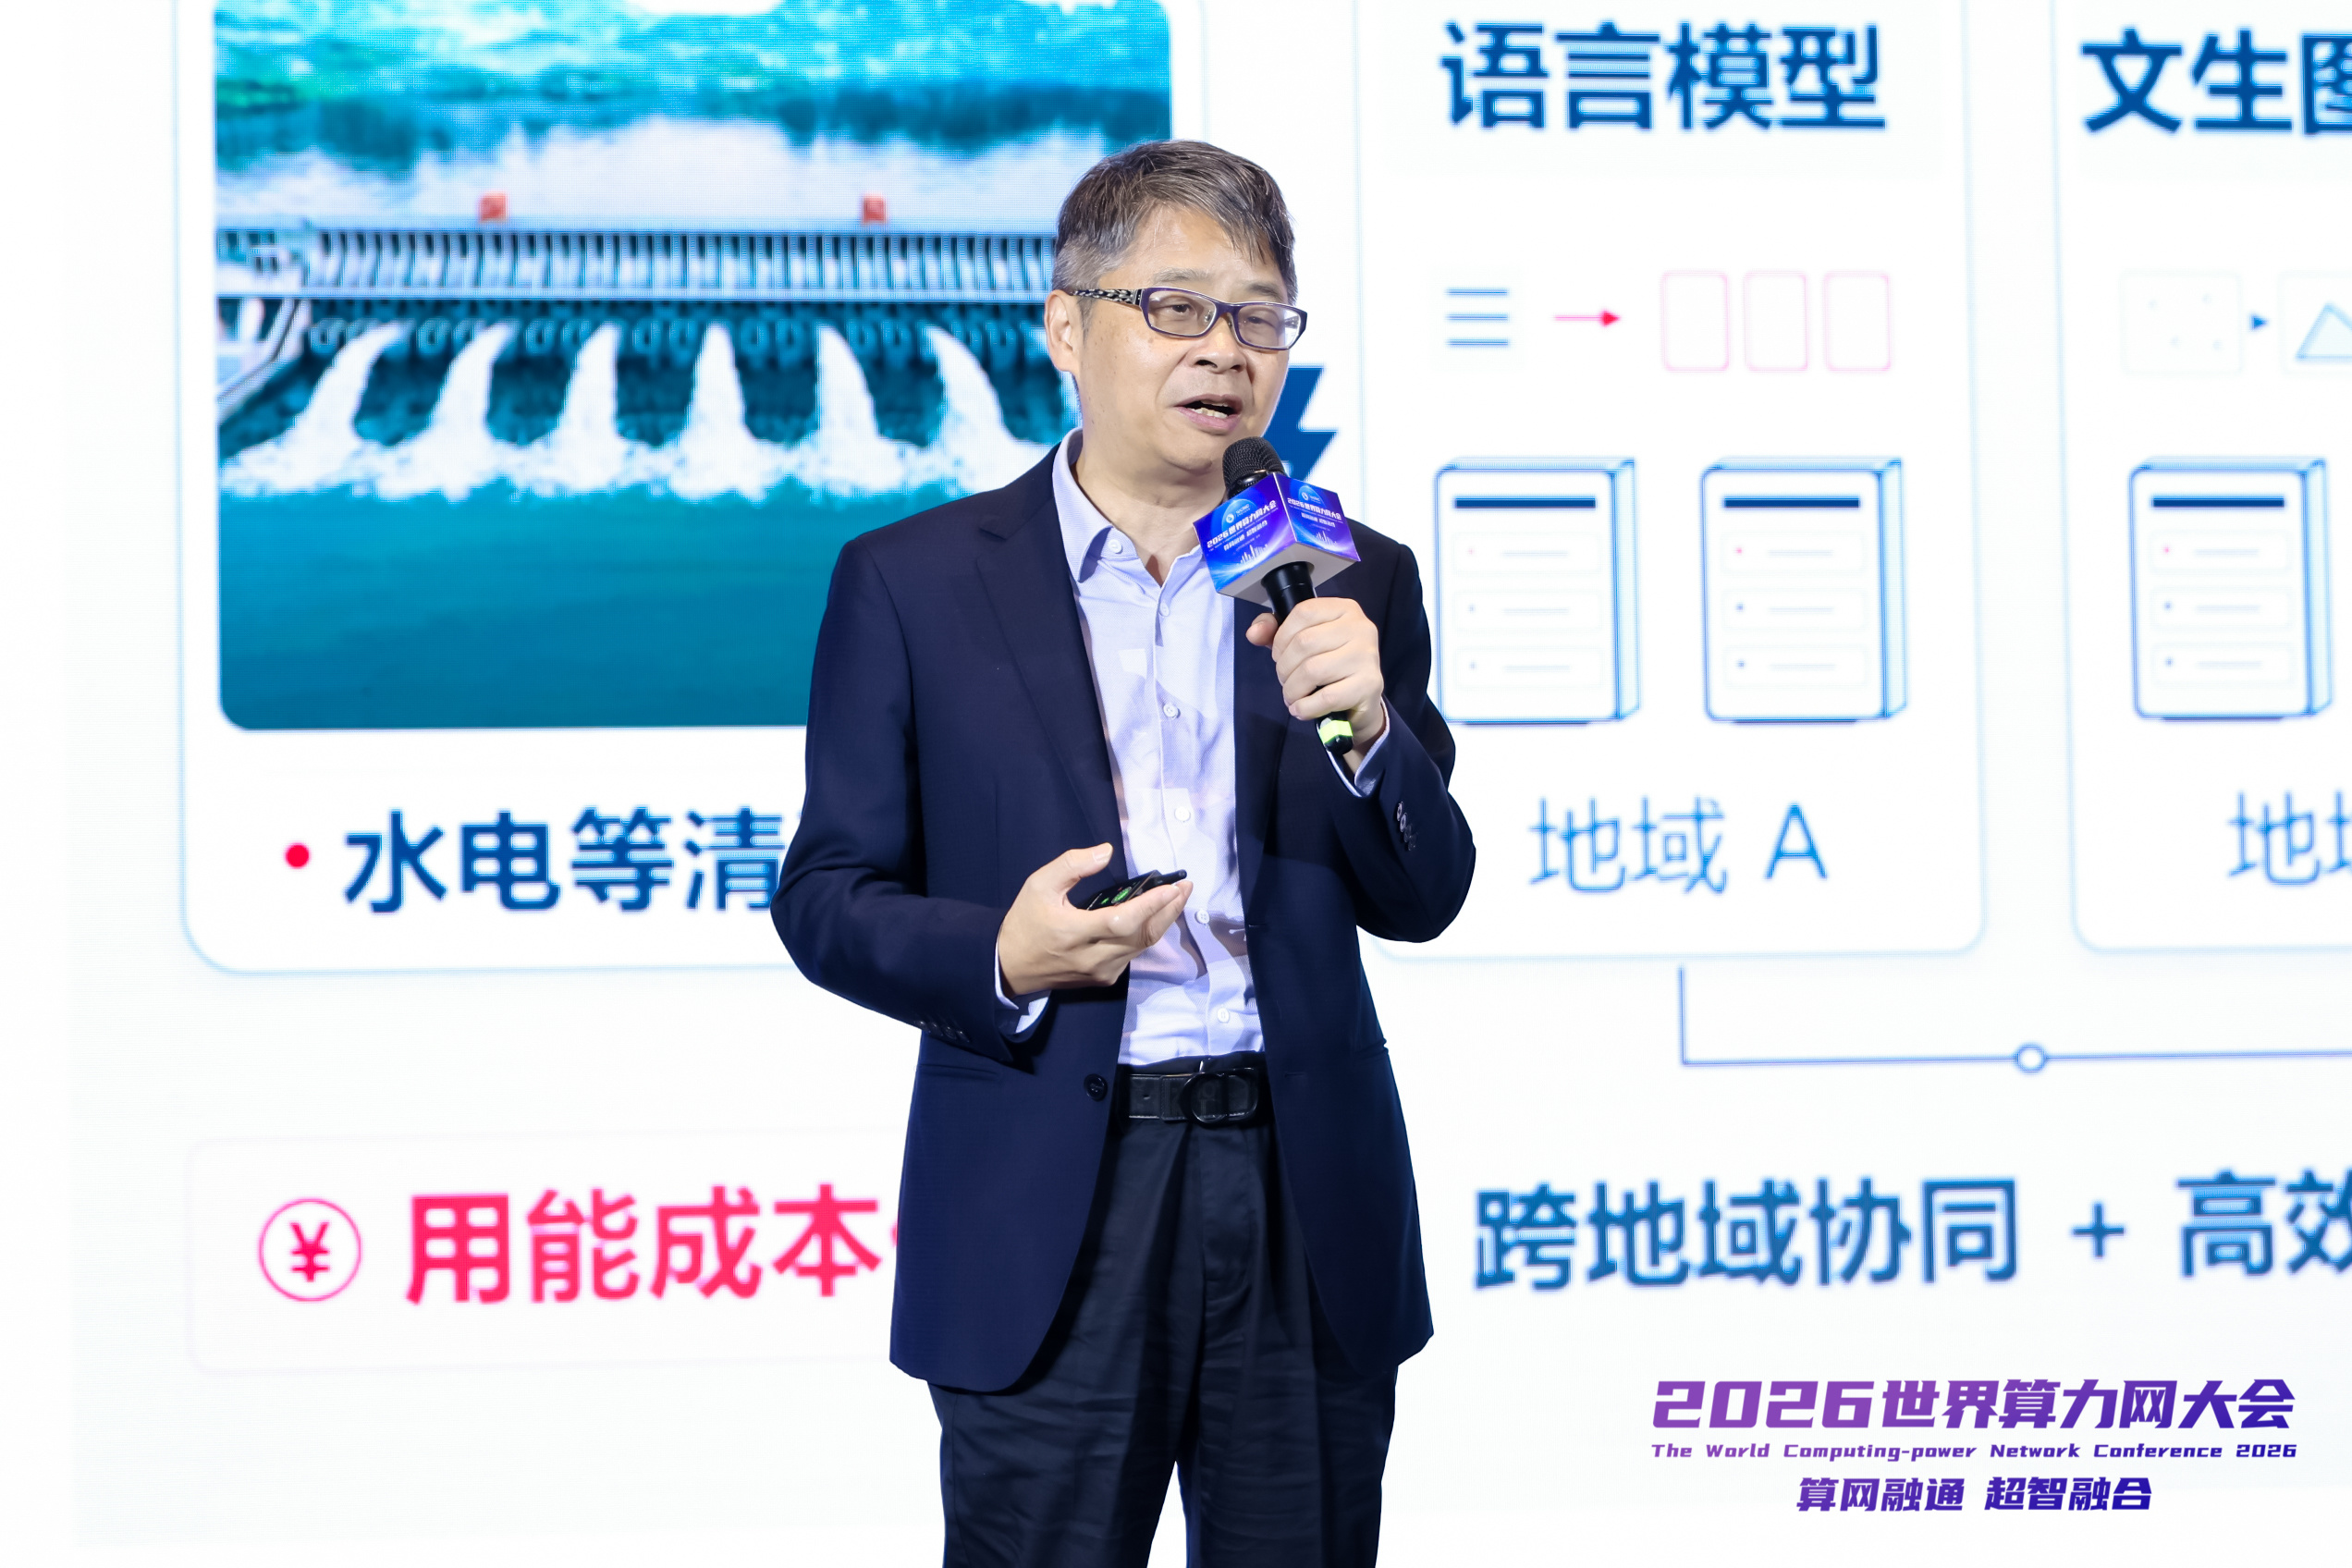
训练与推理的负载特征并不相同,即使在推理内部,预填充和解码阶段对计算、存储的需求也存在明显差异。过敏意表示,面向不同模型和应用目标,系统需要在异构资源匹配、模型并行、显存管理、弹性伸缩和请求调度之间形成闭环。他特别谈到,模型和应用形态的更新以月计,而算力平台的更新往往以年计,如何让存量硬件持续承接新模型,是未来算力网必须解决的问题。
产业嘉宾随后展示了面向国产超节点的优化实践,包括根据实时负载动态调整预填充与解码实例、分层管理缓存,以及协调毫秒级推理调度与秒级集群调度。相关实践表明,国产算力的性能释放越来越依赖计算、存储、网络和系统软件的协同优化,而非单一硬件指标。
模型 类脑芯片与Agent进入同一技术栈
暨南大学网络空间安全学院院长李哲涛以“模型互联网”为题,提出通过标准化通路实现不同AI模型之间的互联互通。他认为,互联网放大了单机计算的价值,模型互联也可能突破单个模型的能力边界。未来的关键不只是把模型连接起来,还要研究模型拓扑、任务路由、质量评价、动态管理以及模型协作带来的隐私与安全问题。
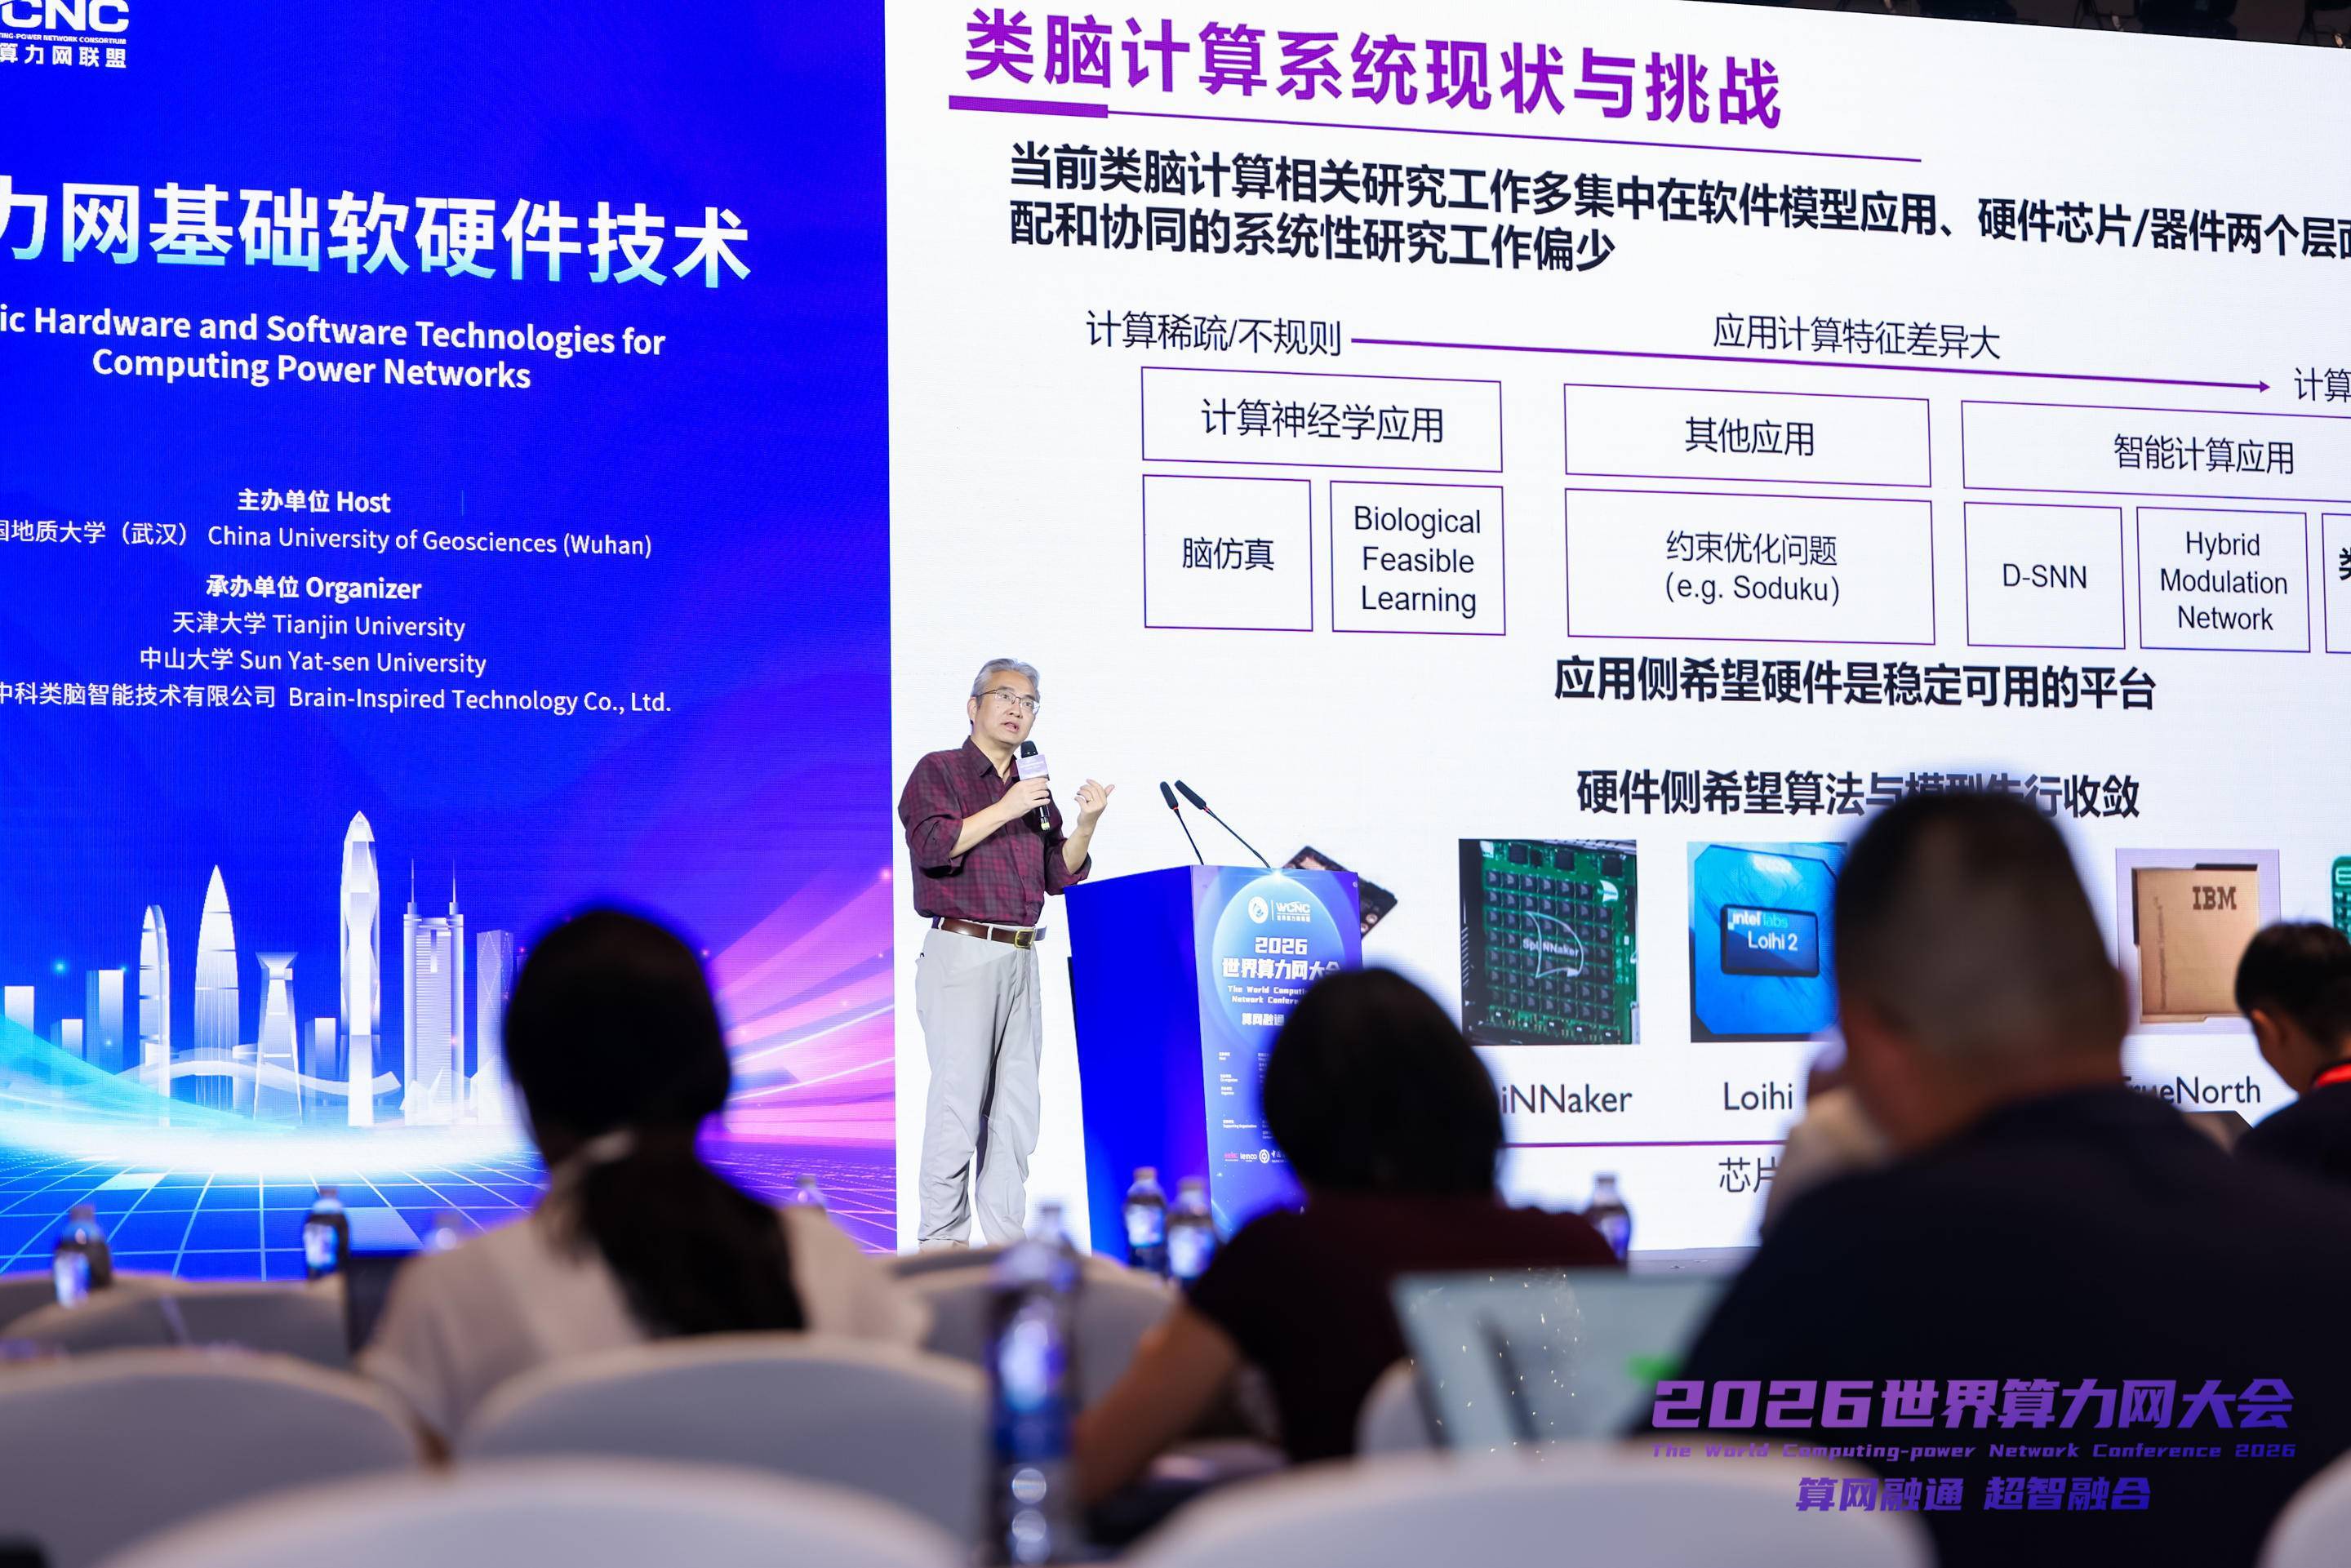
清华大学张悠慧研究员围绕类脑计算基础软硬件及开源实践作报告。张悠慧团队曾参与“天机芯”和类脑计算系统层次结构研究,相关成果发表于《自然》。他在现场指出,当前类脑芯片技术路线尚未收敛,软硬件紧耦合形成的一个个“小生态”,增加了应用复用、开发和标准化的难度。为此,团队正在通过编译基础设施连接多样化模型和硬件,并推进事件驱动型类脑计算硬件开源,希望在保持灵活性的同时提高稀疏、不规则计算的效率。
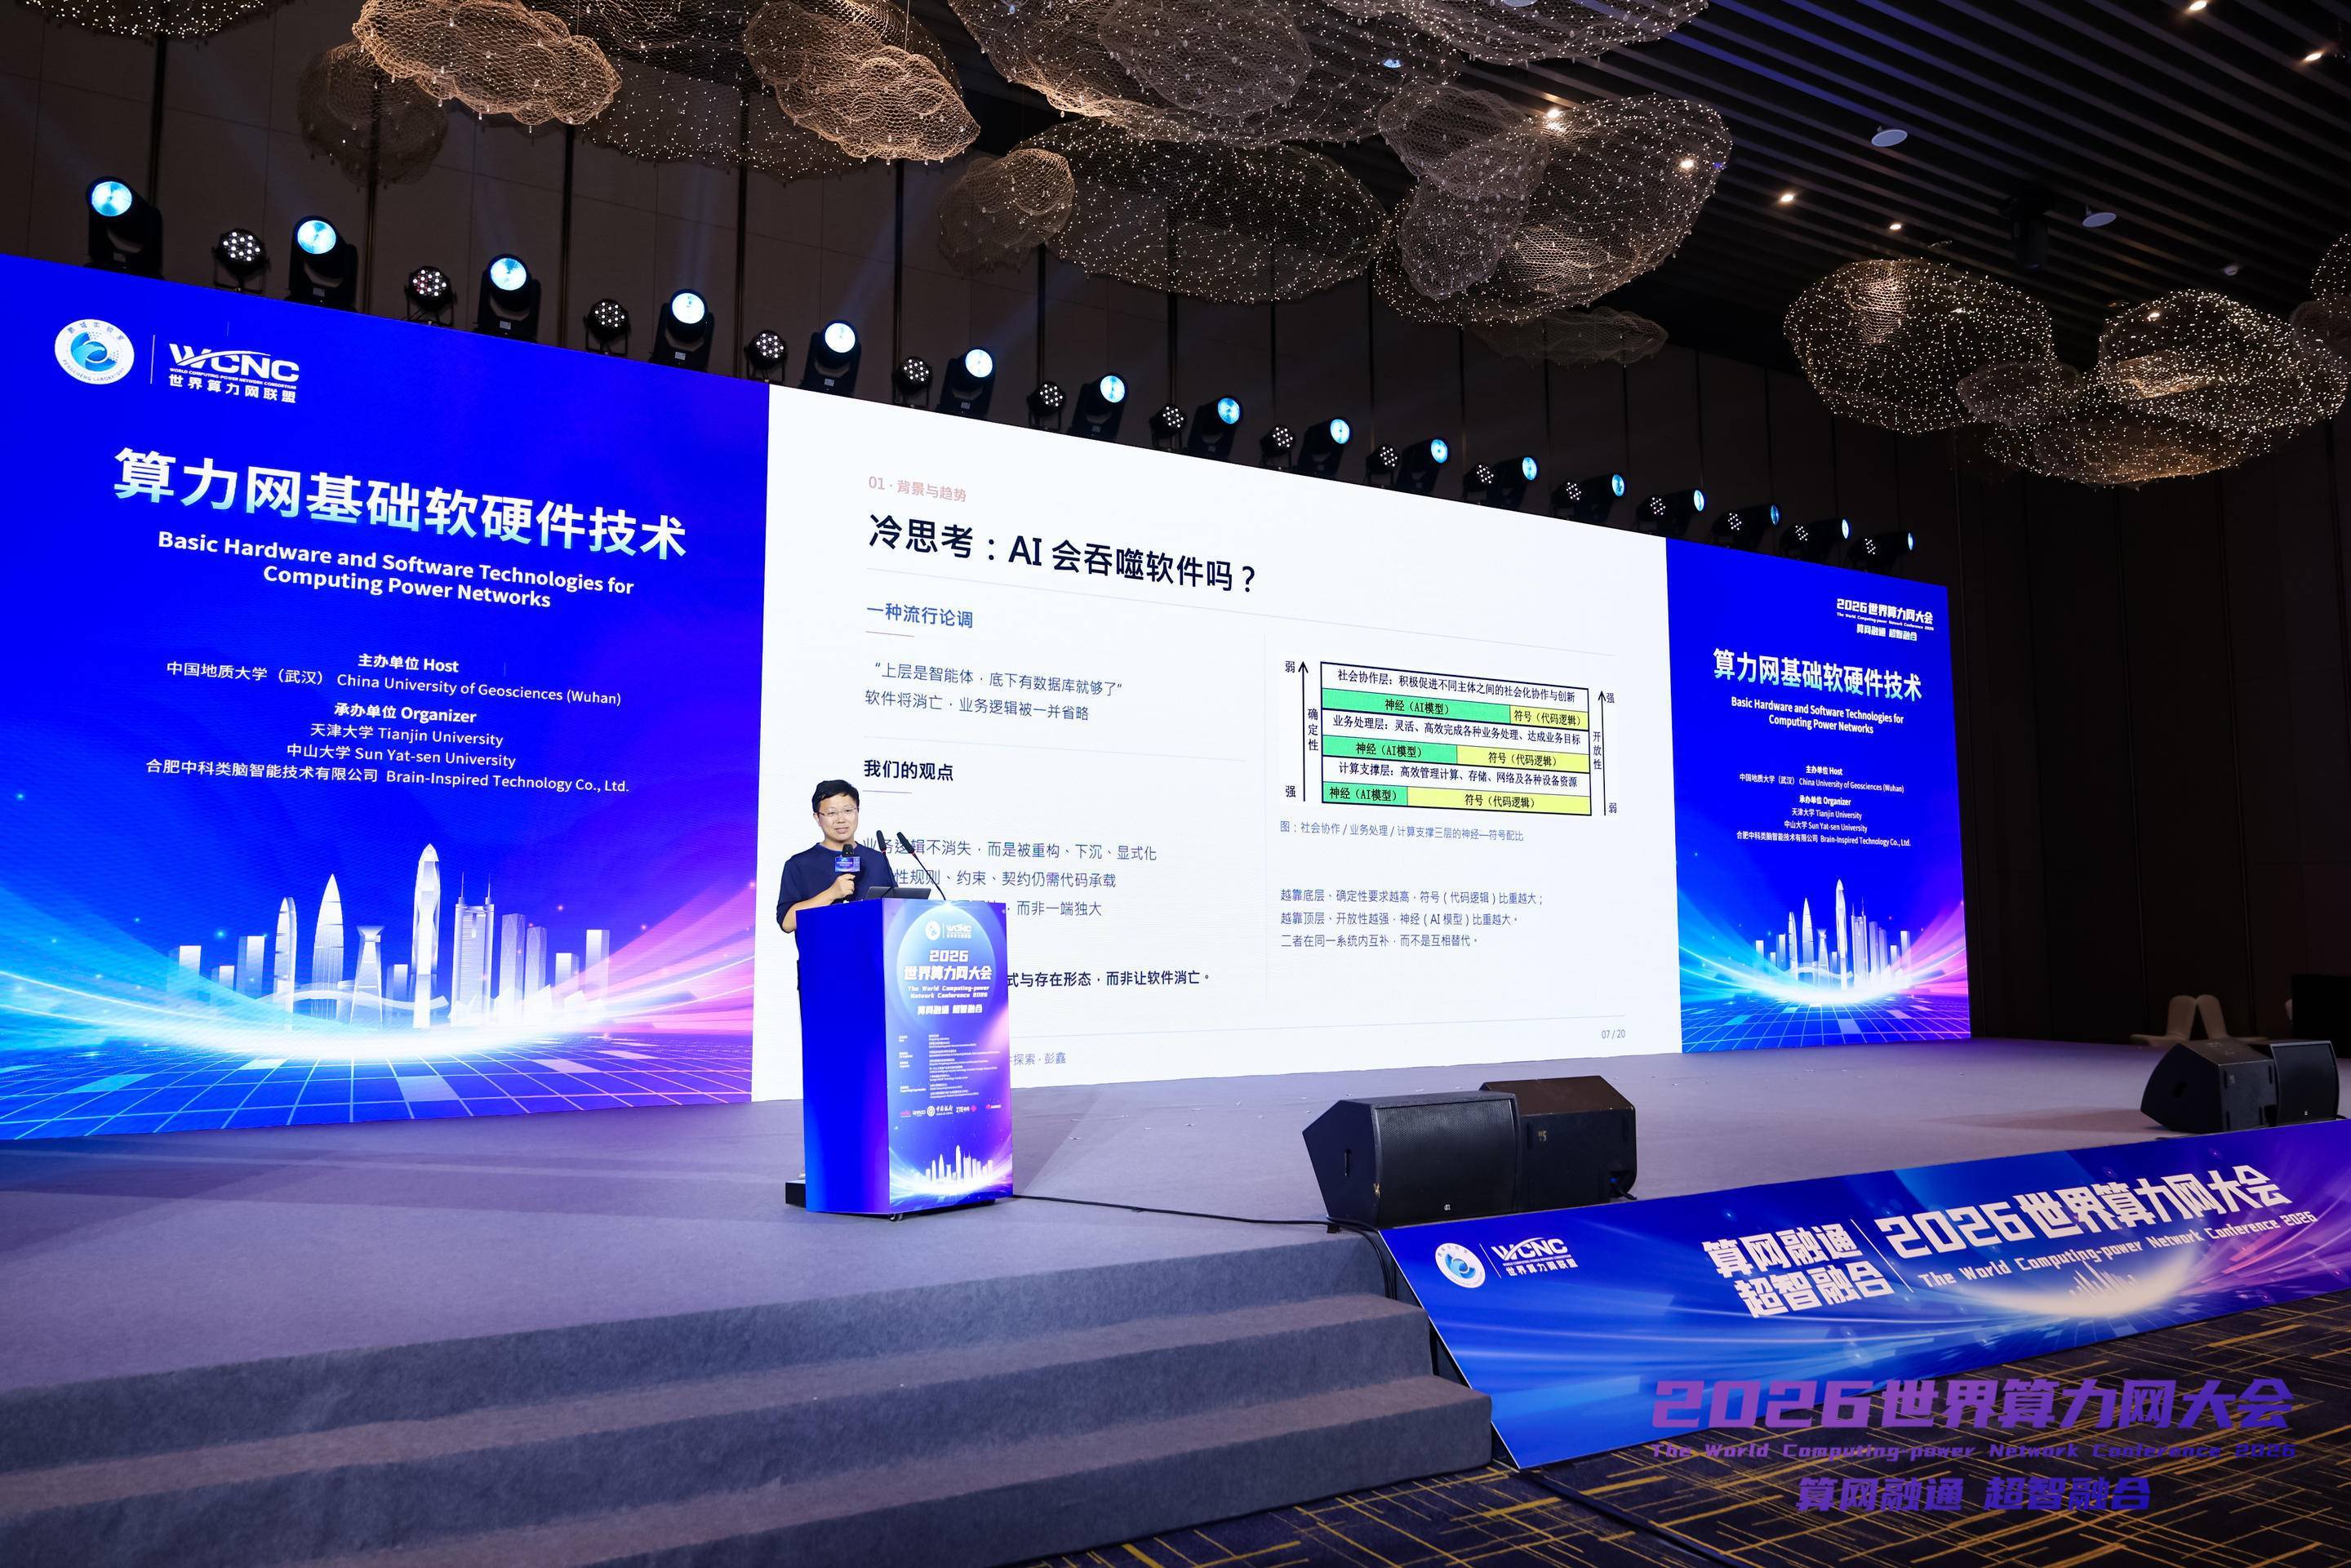
复旦大学计算与智能创新学院副院长彭鑫把讨论延伸到Agent进入真实业务后的软件重构。他认为,AI不会让软件消失,业务逻辑仍然需要由软件系统承载,但代码、智能体和知识将共同成为新型智能化软件的核心组成。代码既可以作为智能体调用的工具,也可以承担权限校验、流程约束和异常处理等“护栏”功能。企业应用和AI for Science场景对可靠性、一致性和可追溯性要求很高,因此,智能体从演示走向生产,必须同步建设任务编排、运行轨迹监测、异常处置和人在回路的审批机制。
从微秒级观测走向任务级调度
南京大学田臣教授介绍了网络数字孪生和微秒级流量测量研究。田臣是国家杰出青年科学基金获得者,长期从事数据中心网络和分布式系统研究。他把网络比作连接算力节点的“血管”:通过持续观察网络流量,可以判断算力系统的健康状态。
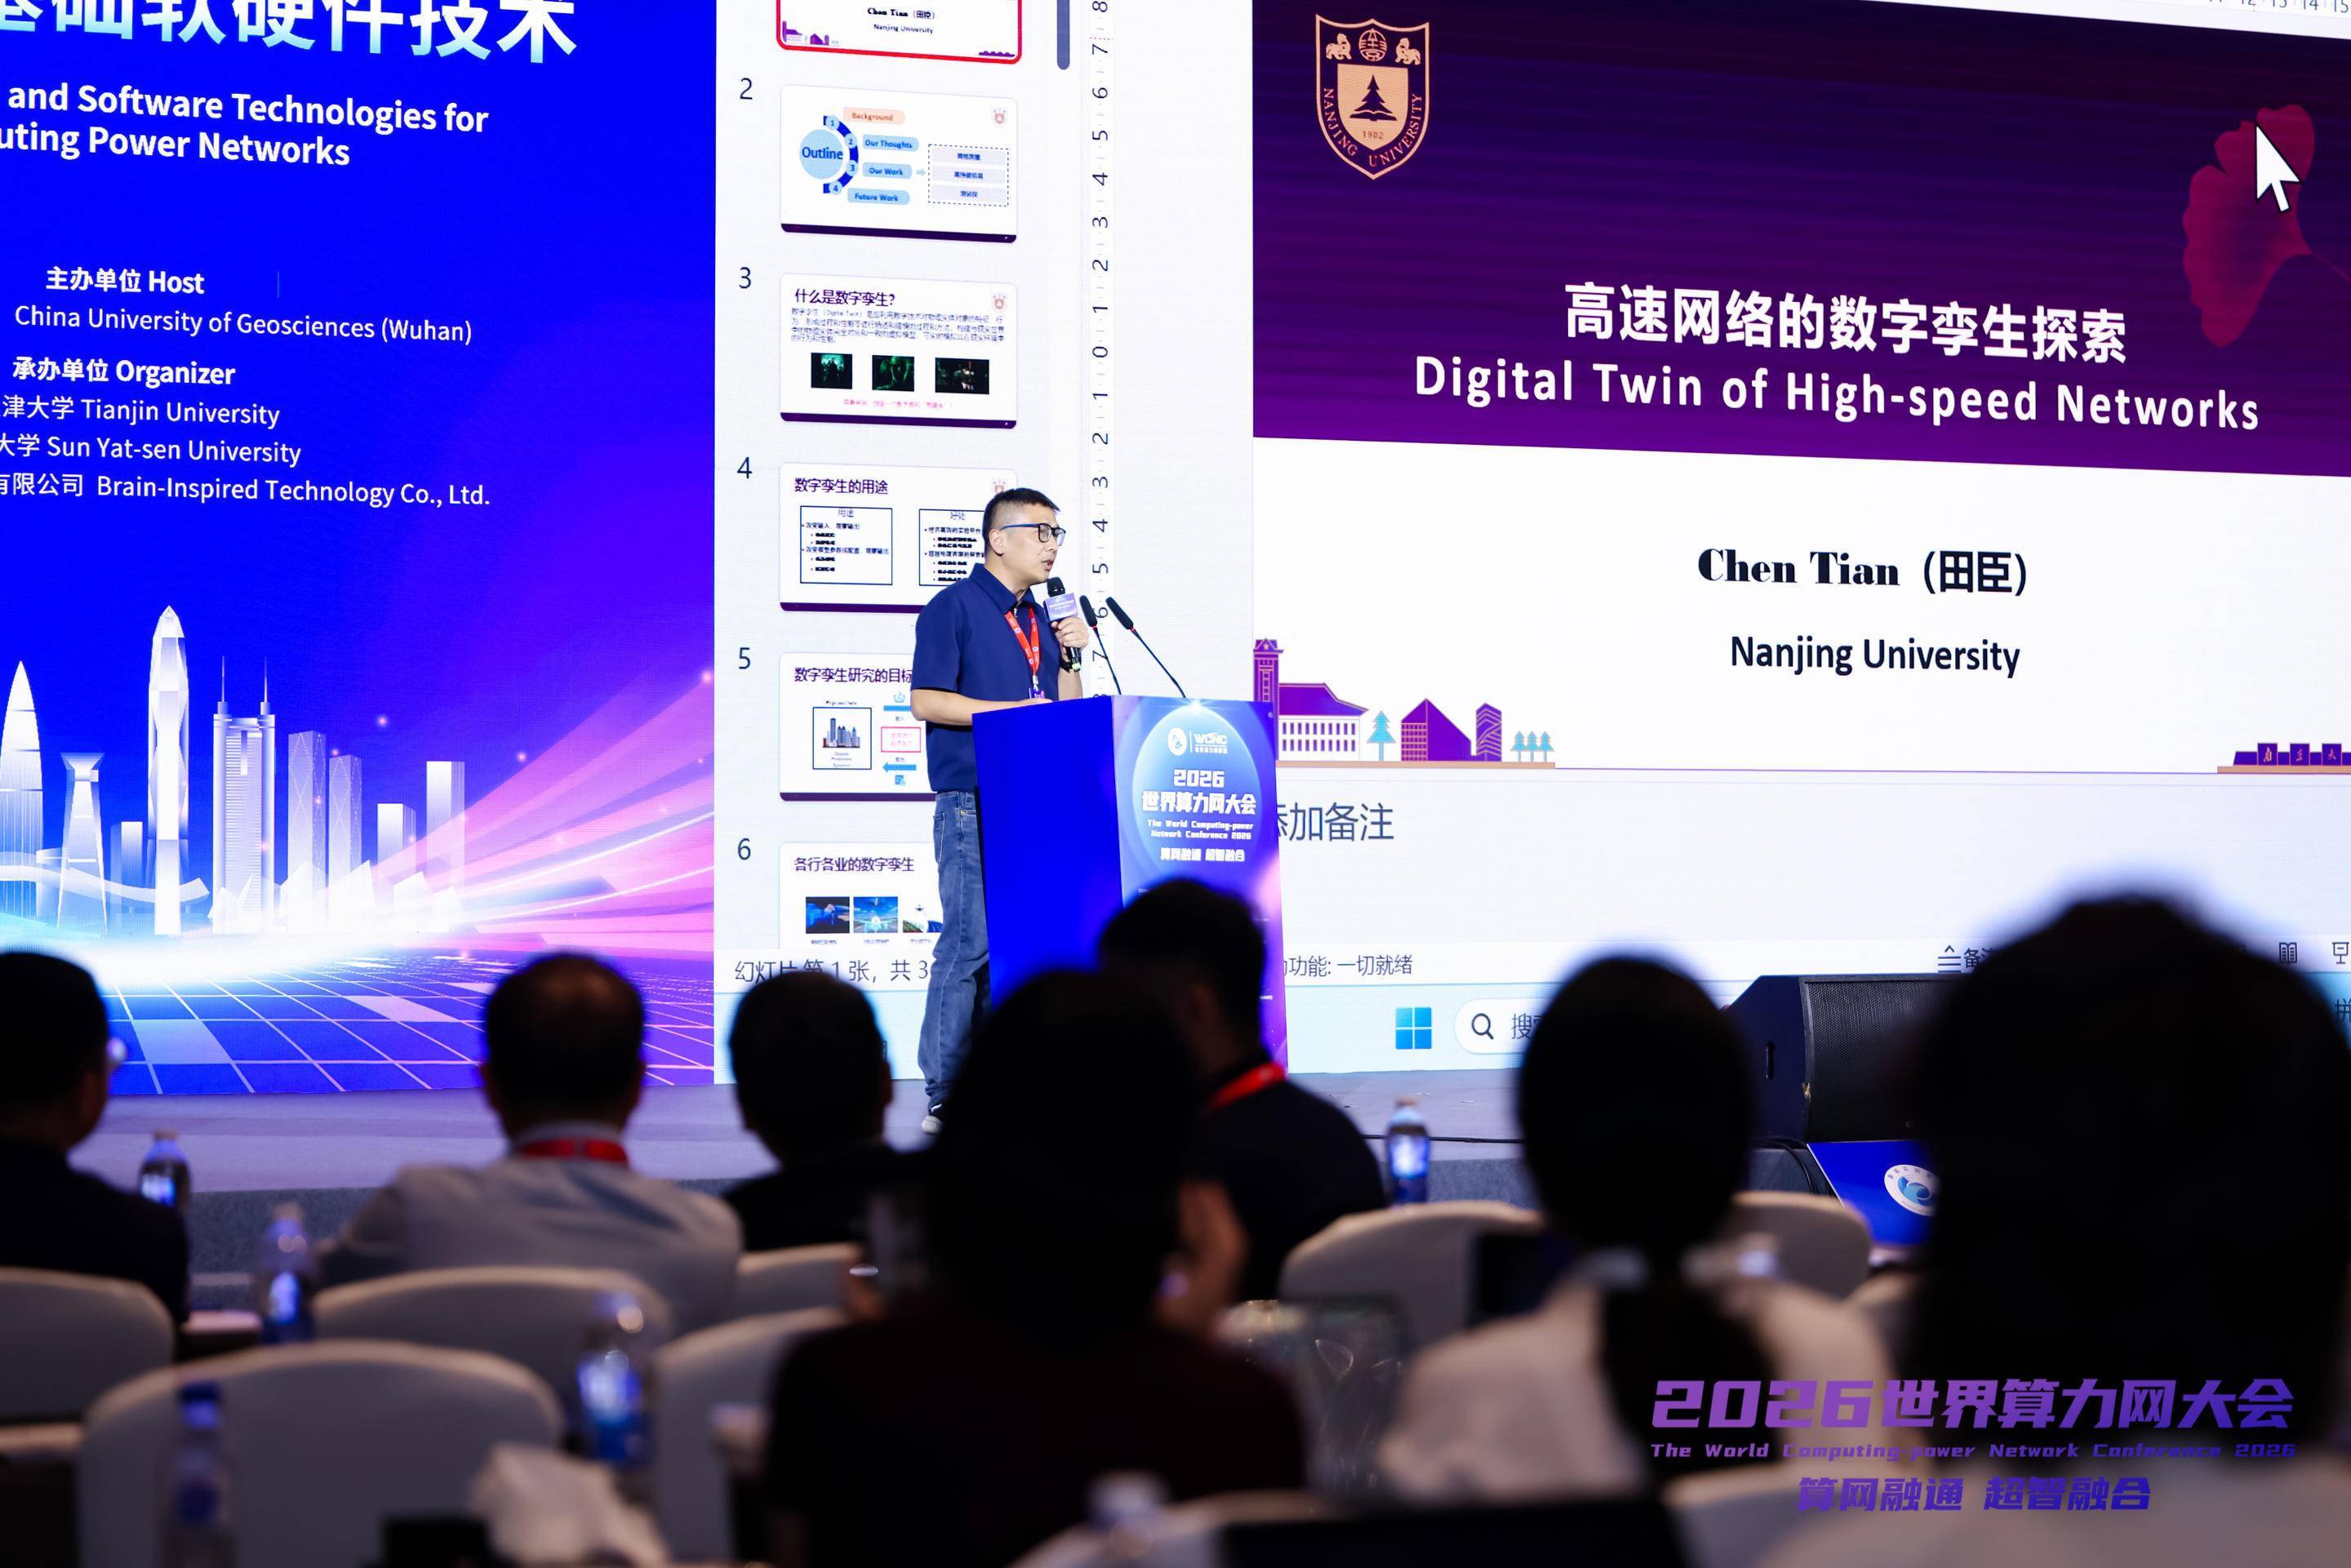
针对大模型训练过程中“机器未宕机但任务明显变慢”等问题,田臣团队把观测粒度推进到微秒级,并通过非侵入式方式关联上层算子语义与底层网络流量,以区分计算、通信、CPU、GPU、网卡和网络本身的异常来源。随着网卡速率持续提升,团队还将探索亚微秒级观测,为训练和推理系统提供更细粒度的故障定位与性能分析能力。
在圆桌环节,ACM Fellow、IEEE Fellow、华中科技大学金海教授,IEEE Fellow、天津大学李克秋教授,华中科技大学计算机学院院长廖小飞教授,以及过敏意、李哲涛、张悠慧、彭鑫、田臣等嘉宾,围绕新型计算架构如何接入算力网、Agent对基础软件的影响、跨数据中心任务调度和算电协同展开讨论。
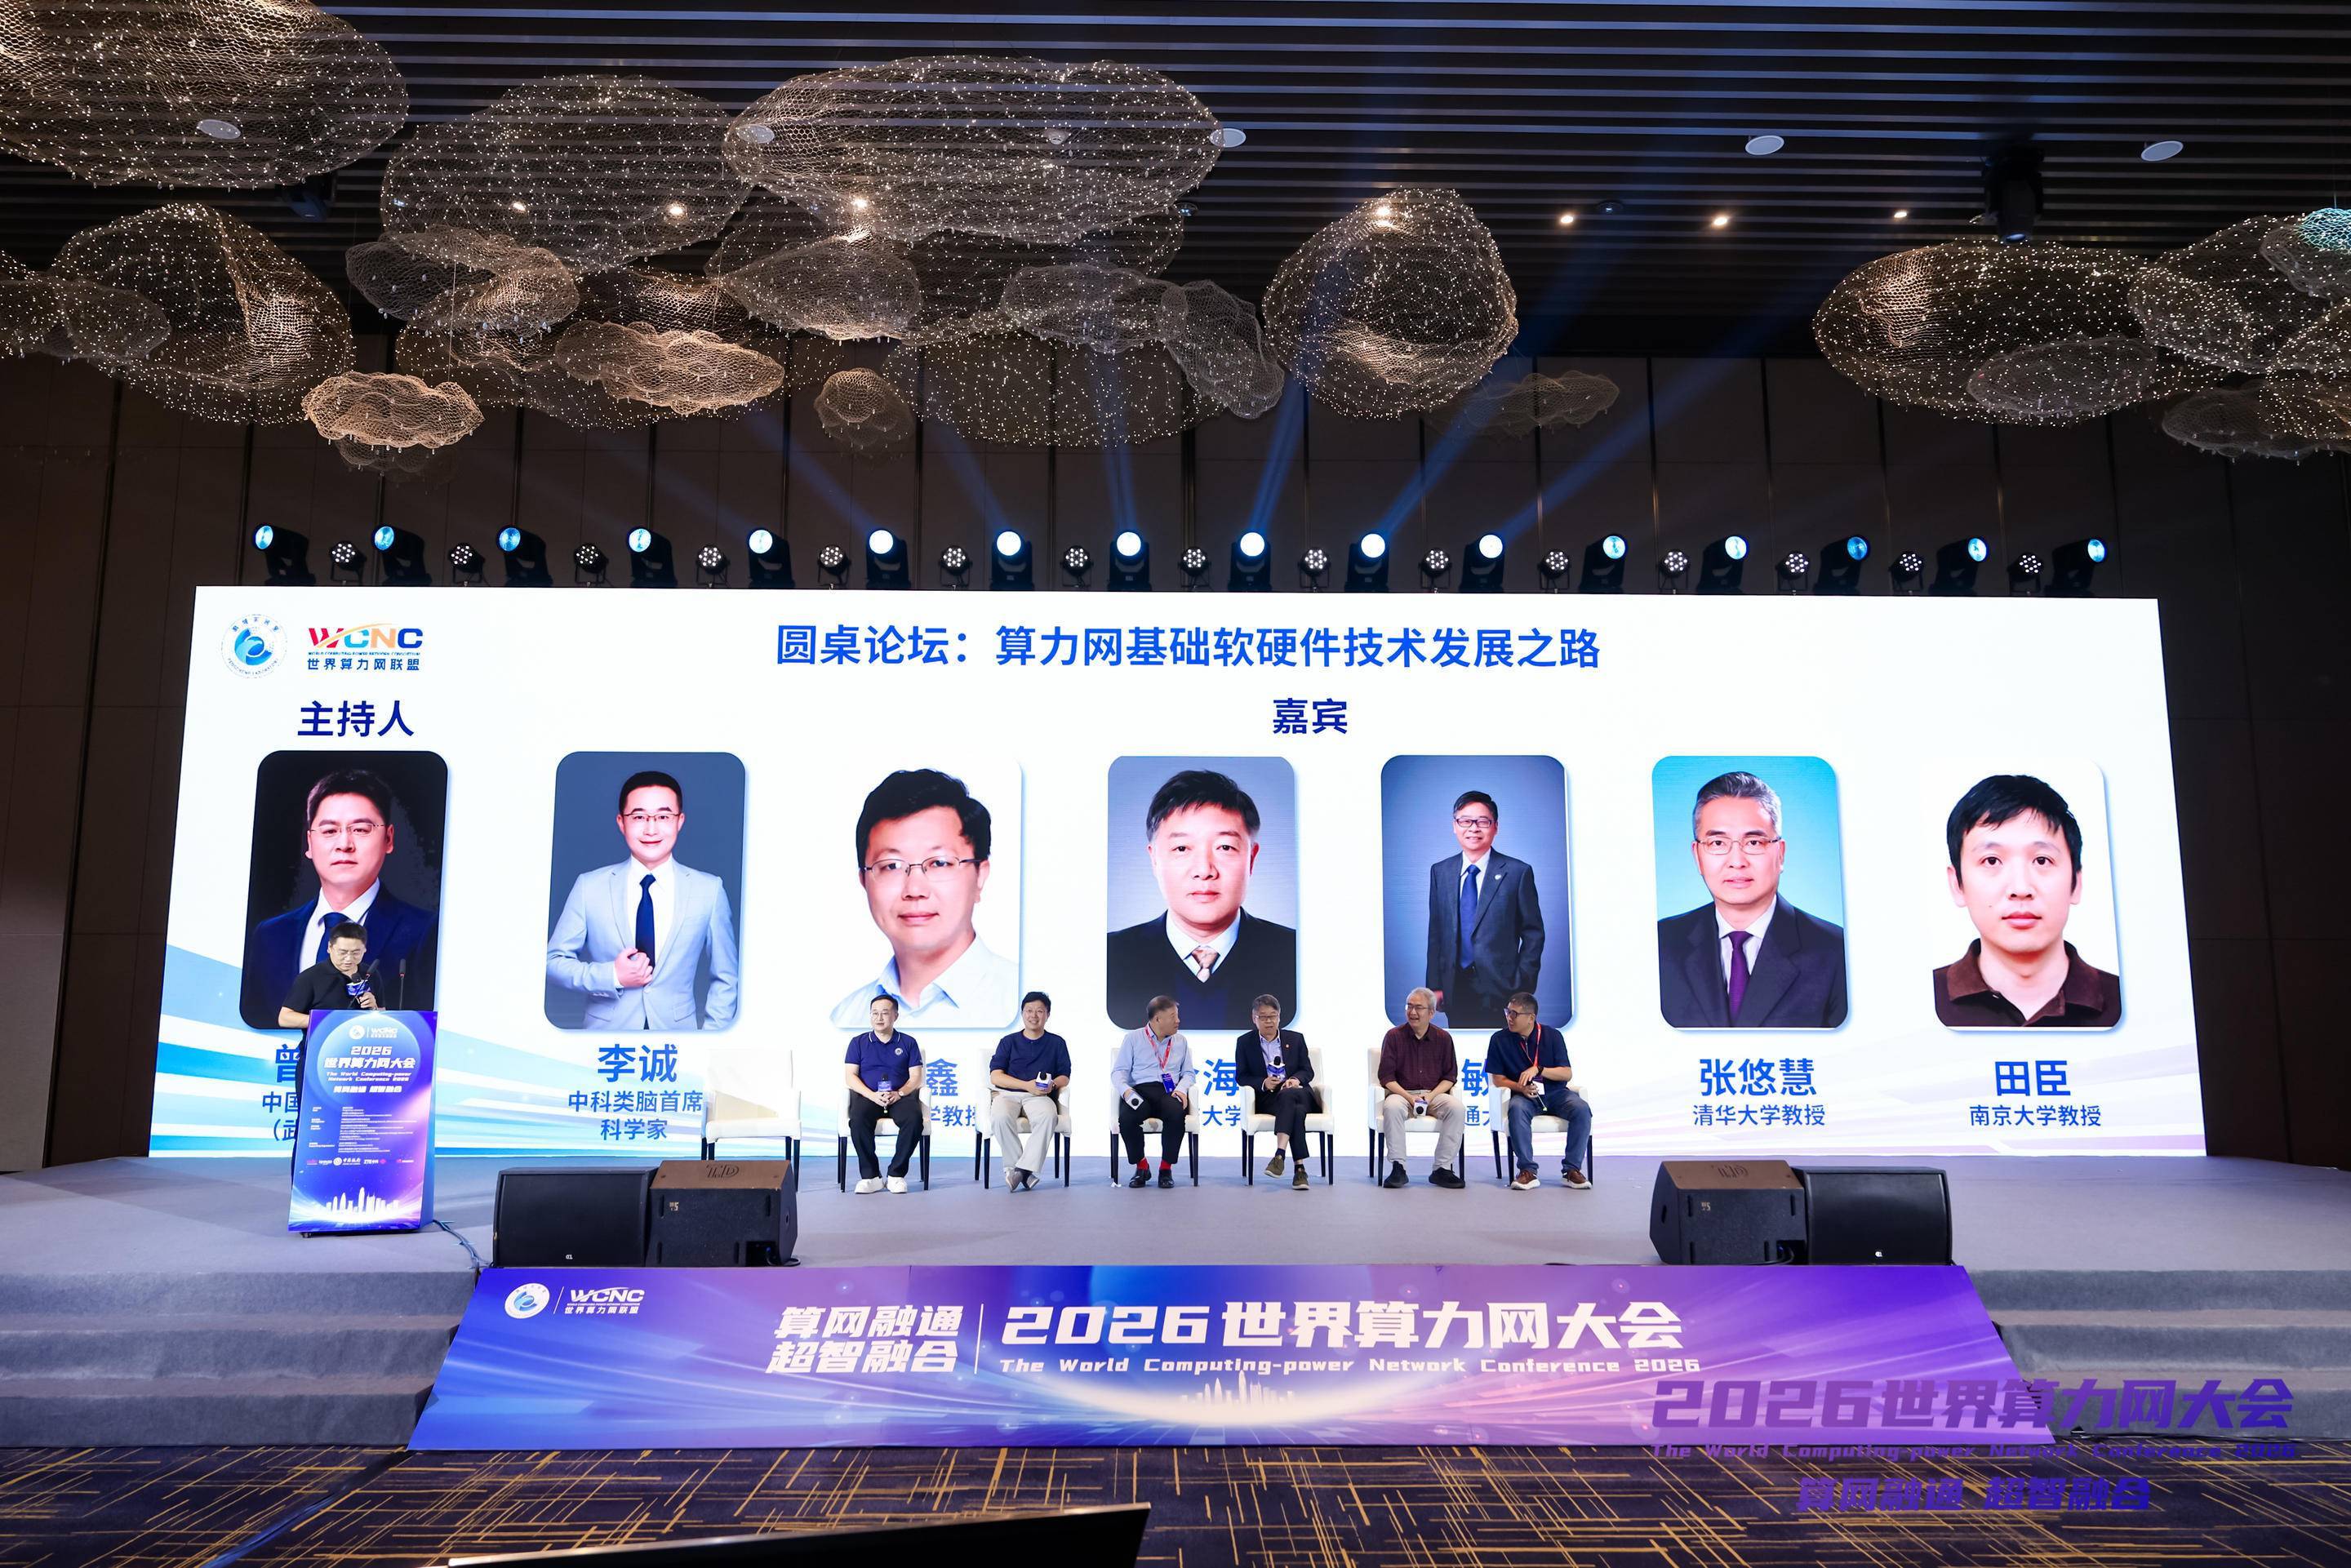
多位专家认为,算力网的调度对象正在从单次计算和单次通信转向完整任务。一个任务可能被拆分为多个步骤并分配到不同算力中心,系统需要从端到端视角统一安排计算、存储和网络资源。面向Agent的复杂负载,CPU与GPU的作用比例、软件栈和性能评测方法也需要重新审视,避免用尚未成熟或缺乏代表性的负载特征反向设计底层系统。
算电协同成为圆桌讨论的另一项重点。专家提出,算力网不仅要连接算力中心,还要把任务调度与不同地区、不同时间的电力供给条件结合起来,提高绿色能源利用效率。西部地区的能源优势能否转化为低成本的智能服务,取决于跨地域网络、异构算力、模型任务和电力系统能否协同运行。与会专家还谈到以单位电力产出的词元数量衡量智算效率,为算力基础设施建设提供更贴近实际产出的评价维度。
从模型互联、类脑编译到智能体软件,从微秒级网络观测到算电协同,本场论坛覆盖了智能计算基础设施的多个关键层次。与会专家的讨论显示,下一阶段的竞争重点将从单点性能转向全栈效率:让不同芯片和模型能够协作,让任务跨越不同数据中心仍可被观测和调度,并让每一份算力投入产生更稳定、更可持续的智能服务。
文/凤凰网深圳 罗沁冰 实习生 刘星辰
图/主办方供图