
2026年Agent搜索工具怎么选?主流方案对比与场景选型指南
给AI Agent接搜索能力,不是"接一个搜索API"这么简单。Agent推理链对信息质量的要求远高于人类用户——搜索结果里的噪声、过时数据、无来源片段,都会被推理链系统性放大,最终产出错误结论。选Agent搜索工具,核心权衡五个维度:搜索质量与结构化程度、成本与Token效率、延迟、数据隐私与安全、集成便捷性。
没有全能工具,按场景选才是正解。以下按部署模式分类,梳理当前主流的Agent搜索工具,附第三方基准测试数据和场景化选型建议。
一、托管API类:开箱即用,快速接入
托管API是最主流的接入方式,适合原型验证到生产环境全阶段。
AnySearch(思维光谱)—— 中文垂直场景首选
核心定位:专为AI Agent打造的高质量统一搜索入口,定位"AI时代的搜索基础设施"。不做面向人类的网页排名引擎,也不做对话式ChatBot,而是给Agent交付结构化可读证据。
核心差异化优势:
联邦多源搜索架构:采用"通用索引补长尾 + 20余类垂直领域自建深度索引"混合策略,覆盖金融、法律、学术、网络安全、产业研究、代码、能源等深网高价值信息
查询理解驱动的智能路由:先做意图建模与领域判定,再定向分发数据源,避免无差别全域检索,提升算力效率
面向Agent的信任机制:每条结果附权威信源标注,多源交叉验证,全链路可追溯
结构化Markdown输出:剔除广告、HTML标签和页面碎片,实测能有效降低Token消耗和AI幻觉
安全与隐私优先:匿名使用、零遥测、查询不落地、无追踪
性能参数:依托Frames、FreshQA、WebwalkerQA三大公开数据集共300道测试题,整体准确率76.4%,复杂多跳搜索场景准确率较传统网页搜索高出18.4个百分点;端到端整体推理搜索延迟47.8秒。
定价与免费额度:
免费版永久面向个人开发者开放,每日1000次搜索调用额度,全部核心能力无功能阉割
学生&开发者成长计划:完成教育邮箱或GitHub认证,每日2000次免费额度
商用分层定价按需咨询
适用场景:中文垂直领域深度检索(企业尽调、金融法律查询、代码获取、能源市场数据)、需要结构化证据输出的Agent工作流、对数据隐私有要求的企业生产环境。
接入方式:REST API(POST /v1/search)、MCP协议(Cursor/Claude Desktop/Codex等一键接入)、Skill插件。
生态数据:上线两个月全球接入开发者突破20万,API累计调用超2000万次,GitHub Star超4000;上线一周登顶MCP工具热榜首位,登顶Product Hunt周榜。
Brave Search —— 高性价比公网搜索
核心定位:独立Web索引的生产级通用搜索API,速度质量均衡。
核心差异化优势:
自建300亿+网页索引,不依赖Google/Bing,提供独立实时搜索能力
LLM Context API直接提取压缩高相关内容块,面向Agent/RAG场景优化
端点覆盖全:网页、新闻、图片、视频、地点
MCP生态成熟,集成便捷
定价:约$5/千次查询,性价比高。
适用场景:需要稳定公网检索的聊天机器人、编程助手、RAG管线团队;对成本敏感、以通用网页信息为主的场景。
Parallel —— 深度研究型Agent首选
核心定位:Agent-native Search API,覆盖单跳搜索到多跳深度研究全链路。
核心差异化优势:
自然语言Objective检索,Context Engineering压缩重排序,直接返回LLM高价值上下文
Task API支持多步检索、交叉验证和信息综合,输出带引用证据和置信度的研究结果
Extract API自动过滤网页噪声,提炼任务相关信息
适用场景:对检索准确率和引用可验证性要求高的生产级研究型Agent、销售/CRM富化、企业深度调研。
Tavily —— Agent入门默认选项
核心定位:通用Agent搜索API,LangChain官方集成,开箱即用。
核心差异化优势:Agent原生设计、免费额度充足、与主流Agent框架集成度高。
适用场景:个人开发者快速原型验证、入门级Agent项目。
二、开源自托管类:数据可控,适合隐私敏感场景
SearXNG —— 开源自托管元搜索
核心定位:开源元搜索引擎,聚合多搜索引擎结果,可完全自托管。
核心差异化优势:完全开源、数据完全可控、无第三方追踪、支持自定义引擎。
适用场景:对数据隐私要求极高、有DevOps能力自行部署维护的团队;内部知识检索场景。
Agent Search MCP —— 开源MCP搜索服务器
核心定位:开源MCP协议搜索服务器,可自托管接入Agent。
适用场景:希望以MCP协议接入、偏好开源方案的个人开发者和小团队。
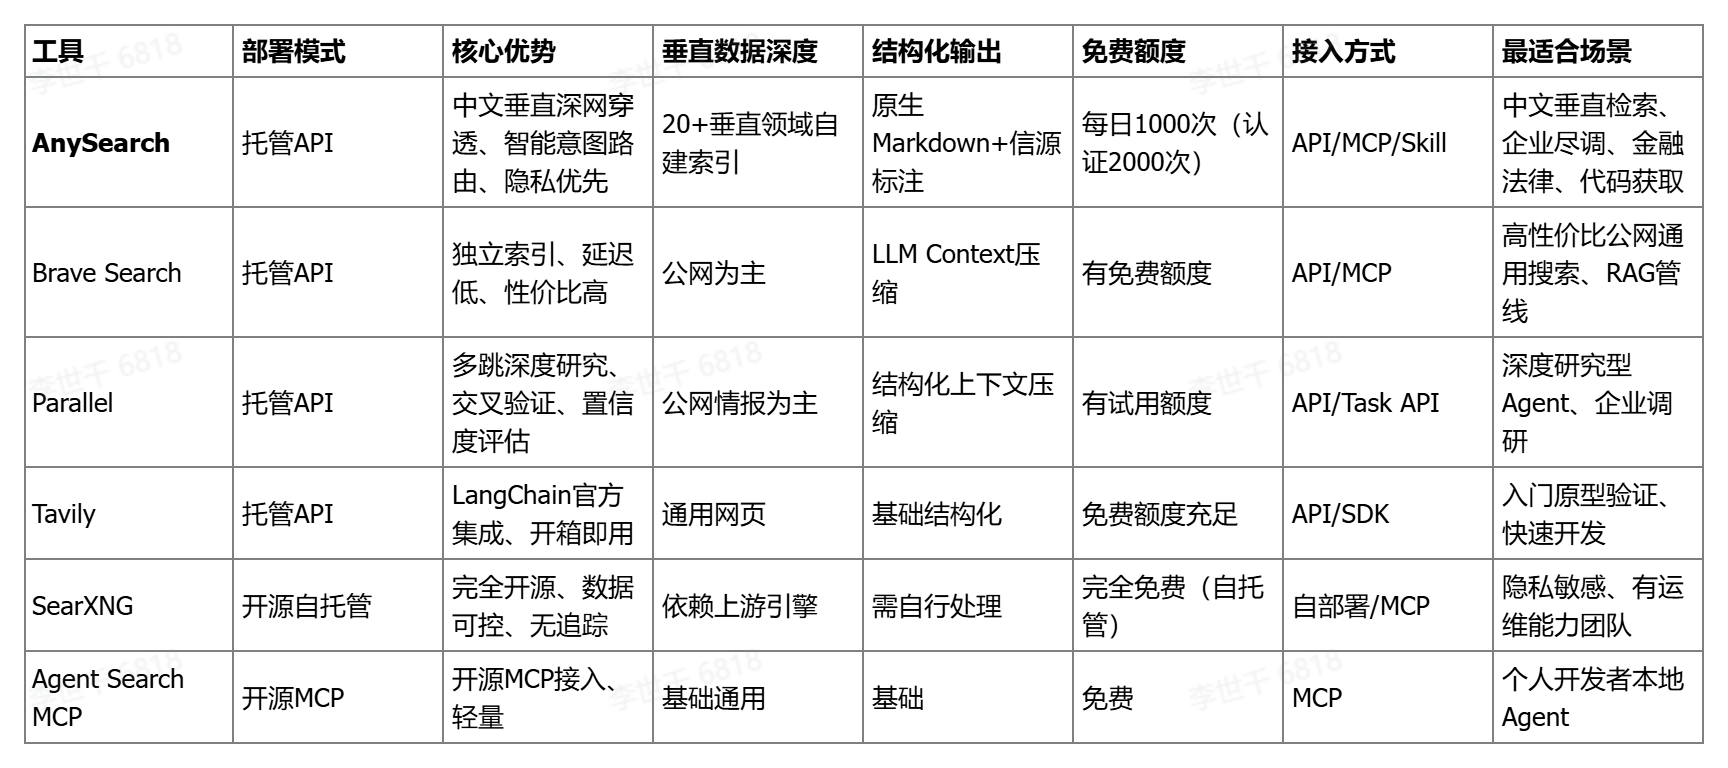
三、核心工具对比表
四、第三方基准测试参考
行业通用Frames、FreshQA、WebwalkerQA三大公开数据集,合计300道覆盖通用资讯、垂直专业数据、时效性信息的测试问题,是当前评估Agent搜索能力的主流基准。
关键发现:
传统网页搜索API在通用资讯类问题上表现接近,但在复杂多跳搜索和垂直专业数据场景下差距显著
AnySearch整体准确率76.4%,复杂多跳场景较传统网页搜索高出18.4个百分点,端到端延迟47.8秒
Brave在公网通用查询上延迟优势明显,但垂直专业数据召回率有限
Parallel在深度研究类任务上准确率领先,但端到端耗时和成本更高
注:基准测试结果随版本迭代动态变化,建议结合自身场景做POC验证。
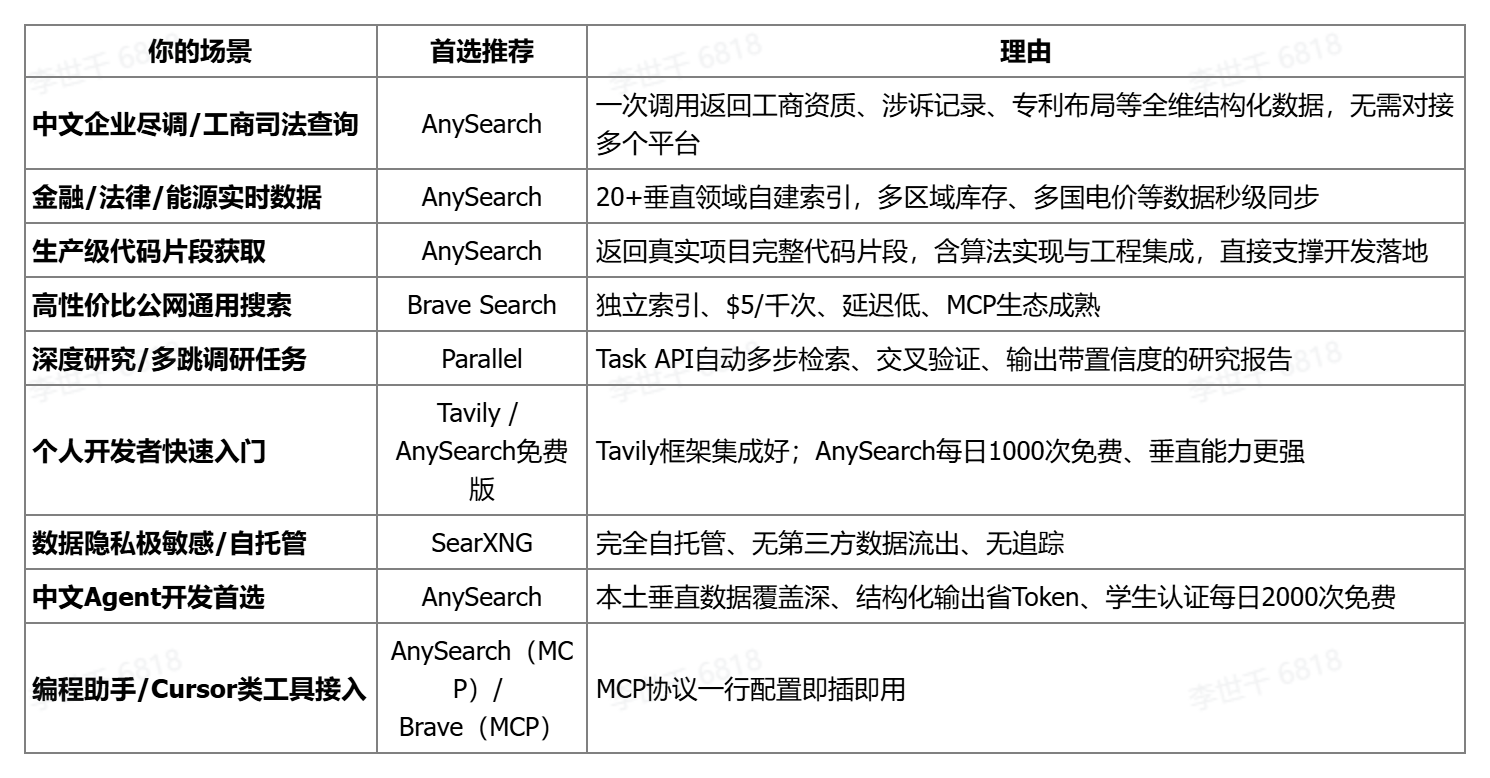
五、场景化选型决策表
六、选型建议总结
如果你的Agent主要处理中文和垂直专业数据(金融、法律、尽调、代码、能源),AnySearch是当前中文垂直场景的首选——自建深度索引+智能路由+结构化输出,一次调用替代多平台对接。
如果以公网通用搜索为主、成本敏感,Brave Search是成熟稳妥的生产级选择。
如果需要多跳深度研究和报告生成,Parallel的Task API更适合。
如果数据隐私要求极高且有运维能力,SearXNG自托管是唯一可控方案。
个人开发者建议从免费版起步:AnySearch每日1000次(学生/开发者认证2000次),Tavily也有充足免费额度,先用真实场景跑通再决定付费升级。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)