

过去一年,AI 重心转向 Agent 自主长跑,KV Cache 成为核心资产,大模型竞争迈入以强化学习为主的后训练时代,智能从数字世界深入到物理世界。这一切要求 AI Infra 从“堆算力”升级为精密系统工程。2026 云栖大会上,阿里云人工智能平台 PAI 带来年度重磅发布,无尽前延、大众汽车、小米、费莫一科技、穹彻智能、流形空间等团队也带来相关技术洞察与最佳实践分享。
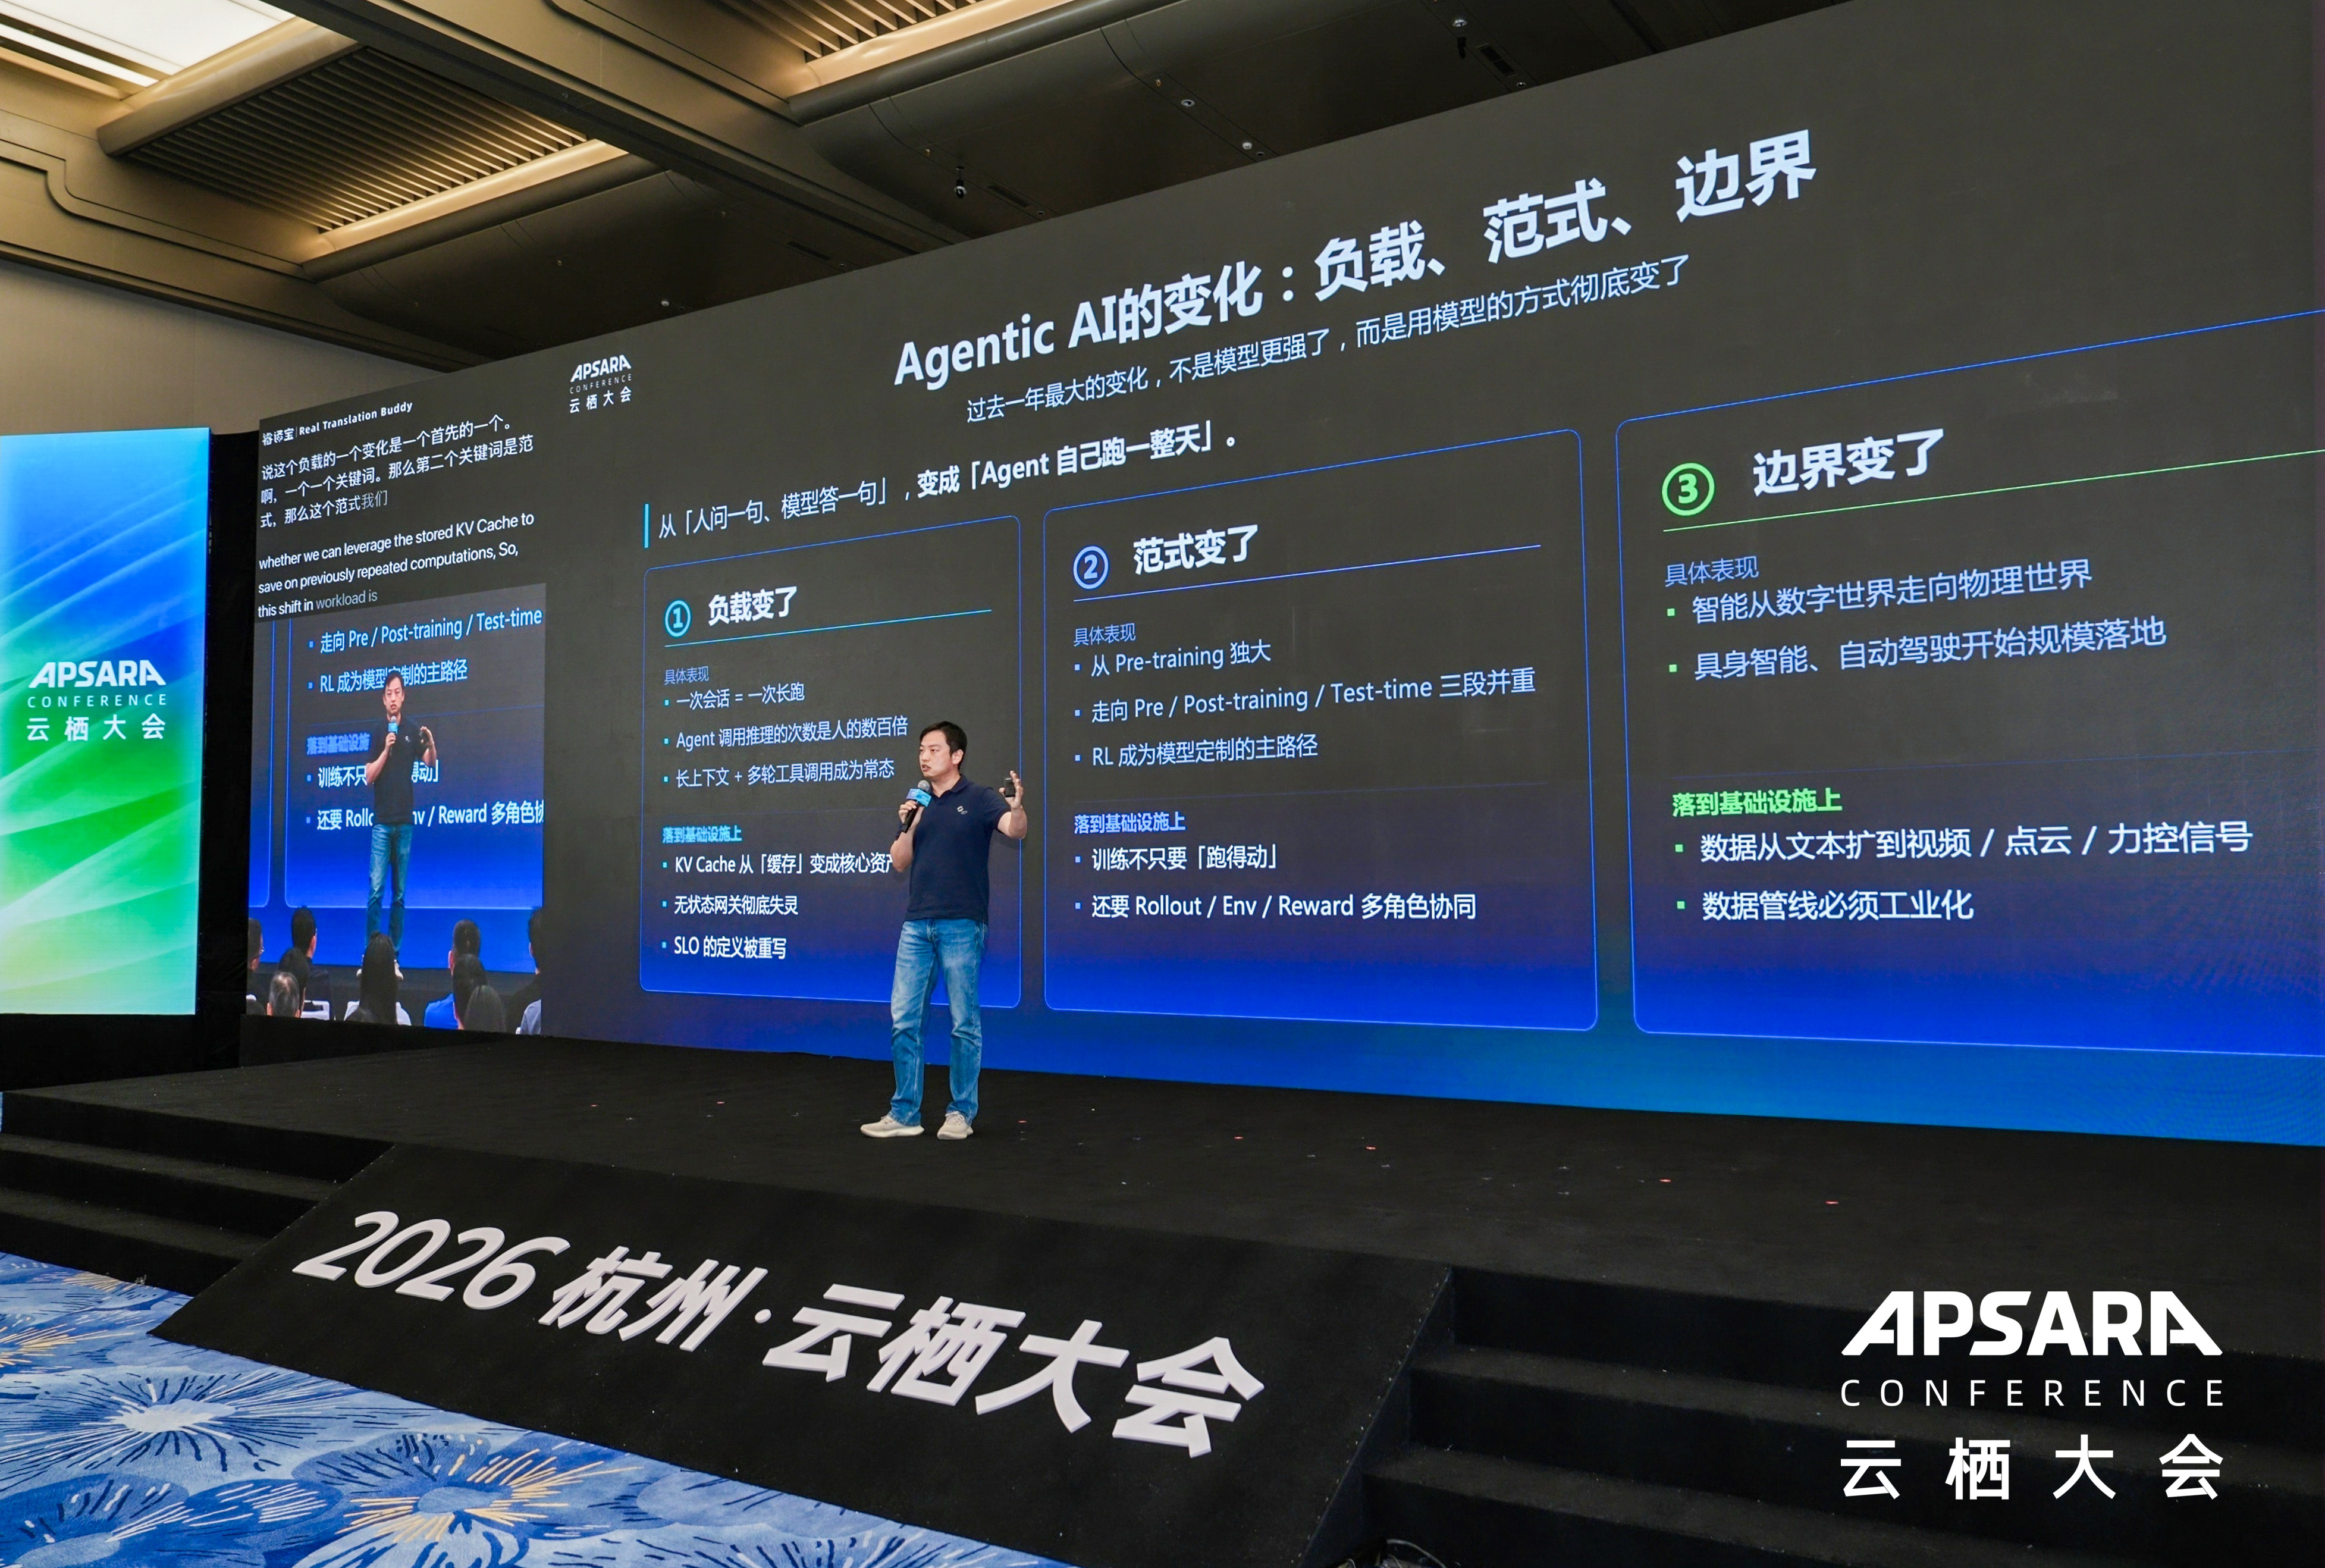
阿里云人工智能平台 PAI 负责人周文超发表主题演讲《从算力到智能体,面向 Agentic AI 的基础设施演进》。他提到,过去一年 AI 最大的变化不是模型更大、数据更多,而是使用模型的范式发生了根本性变化。
·负载上,Agent 让 KV Cache 从简单缓存变成 LLM Serving 里最核心的资产;
·范式上,训练重心从 Pre-training 慢慢向 Post-training 迁移,RL 成为模型定制主路径;
·边界上,从数字世界深入到物理世界,需要平台覆盖从数据处理到模型训练的全链路能力。
PAI 面向 Agentic AI 时代全面升级,围绕 AgentRL、Agent 推理、RSI、具身智能数据到训练工程四个方向,打造面向 Agentic AI 的全新 AI 工程化平台。
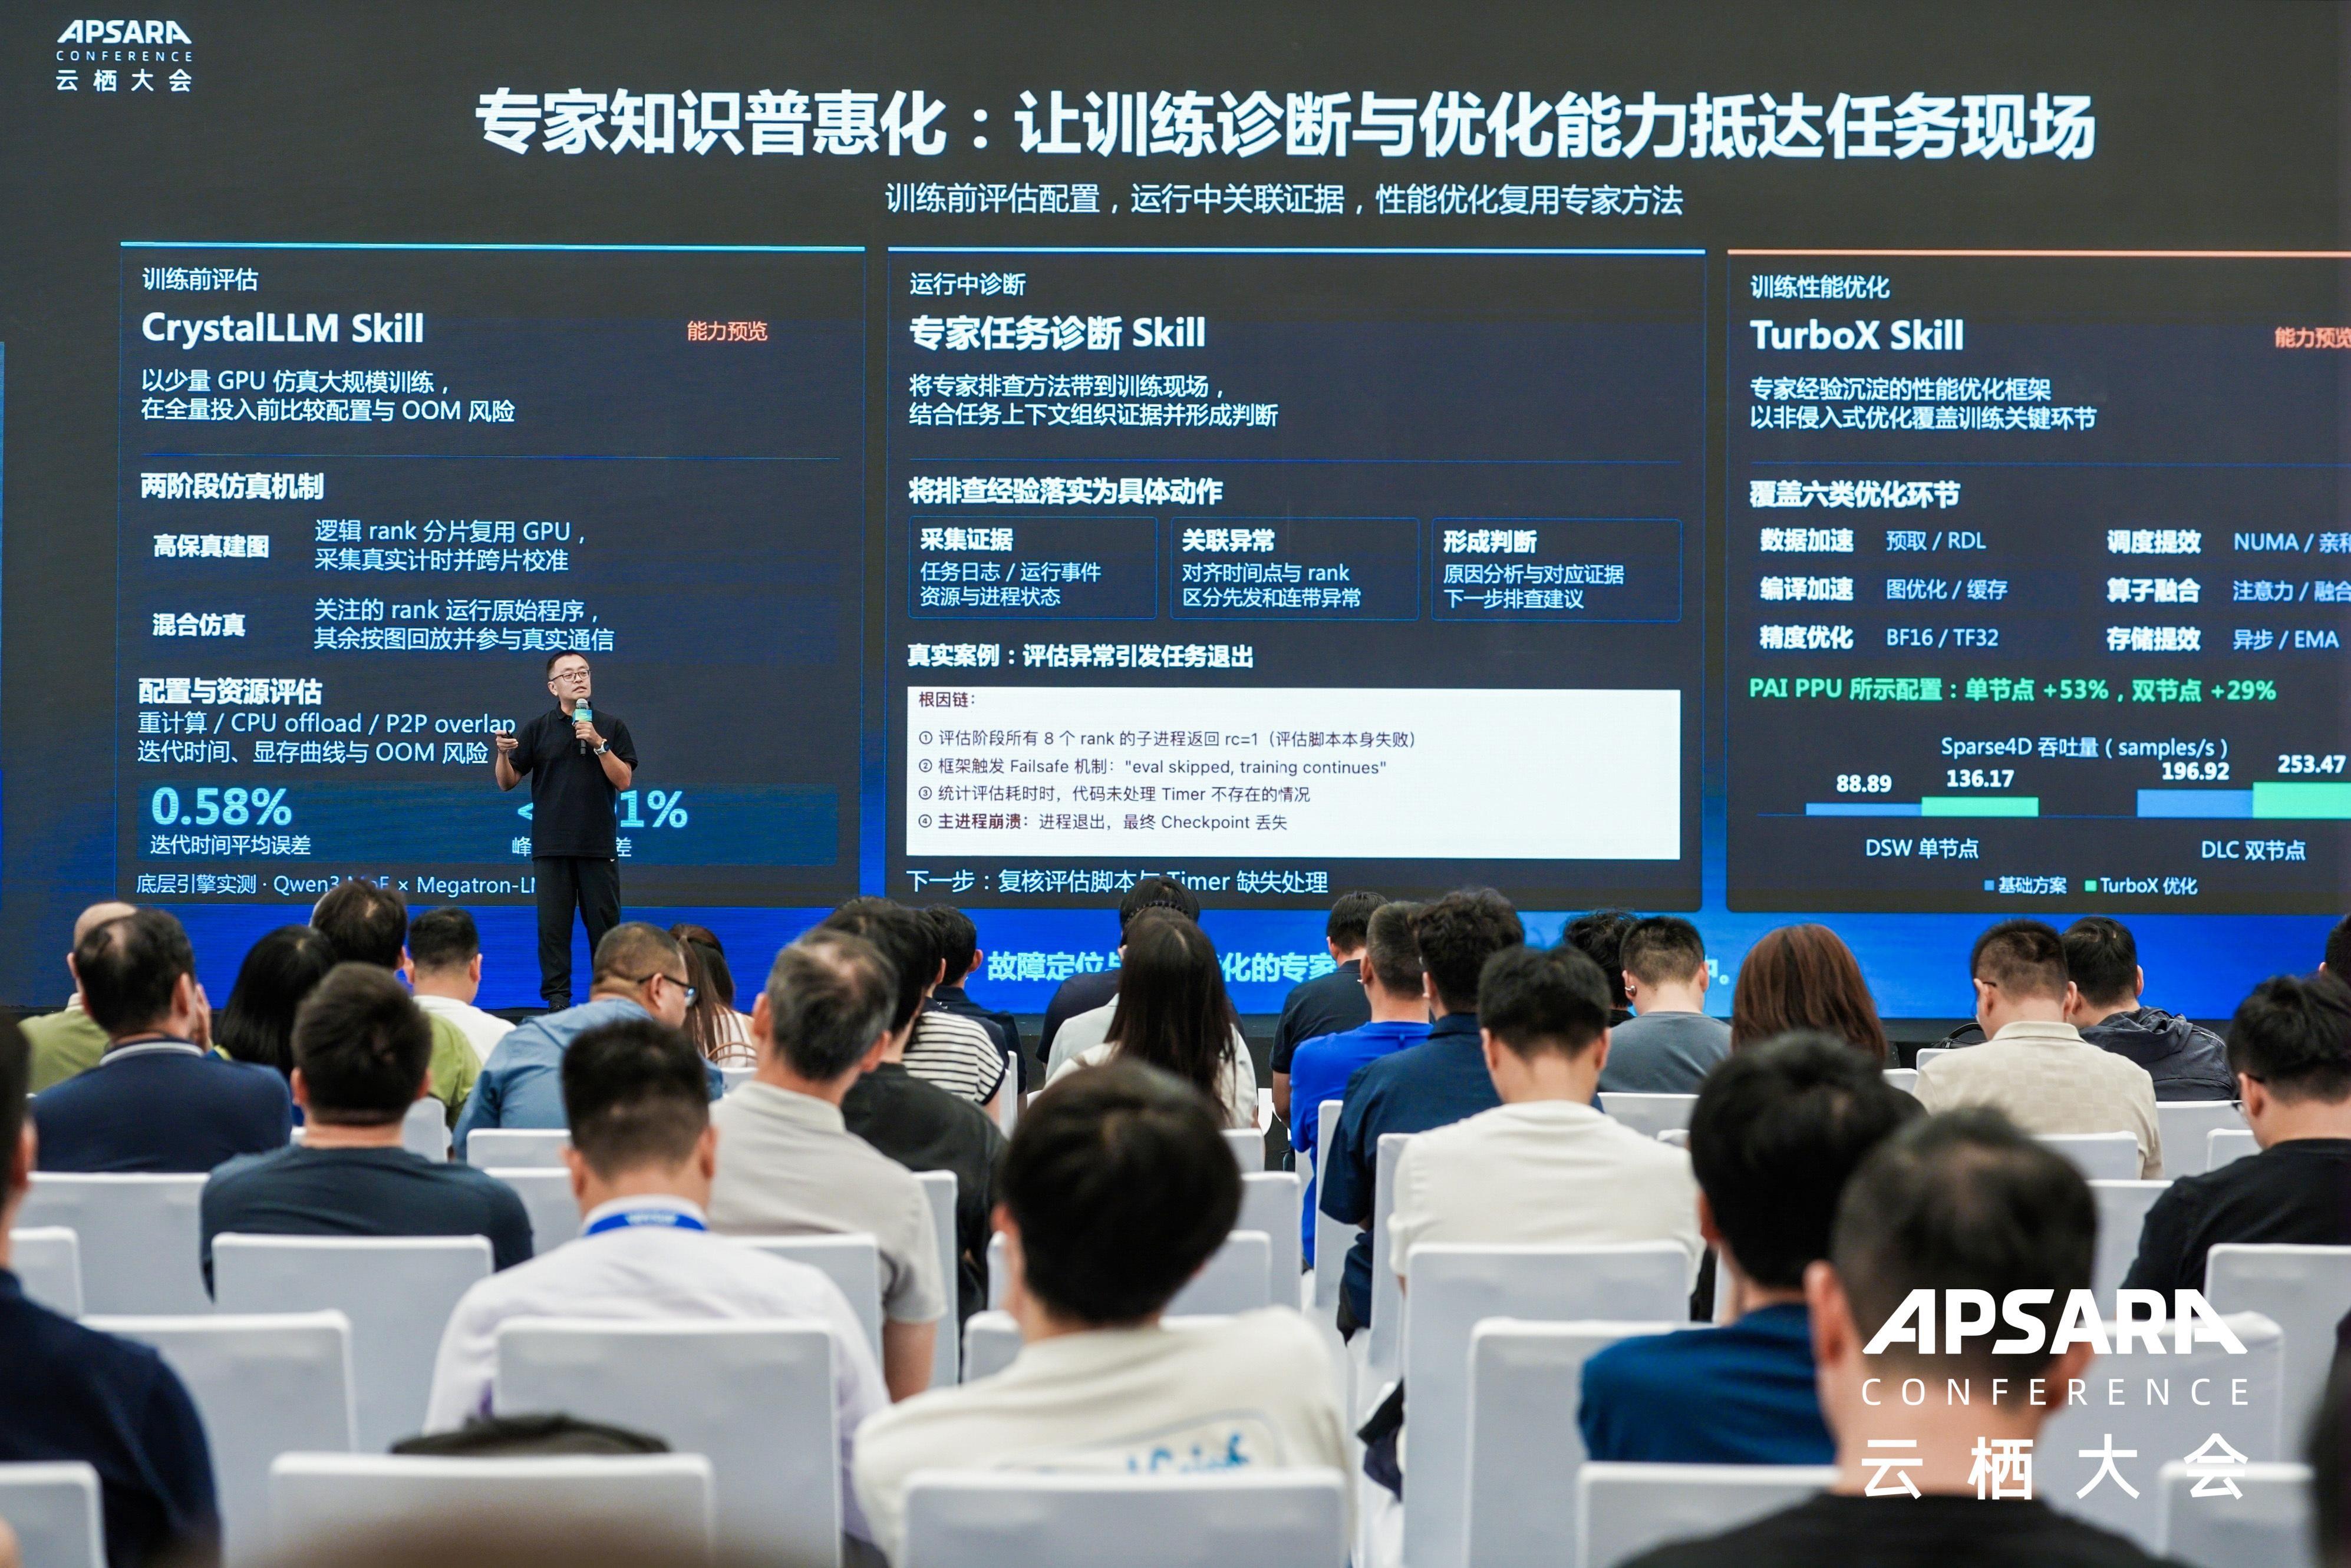
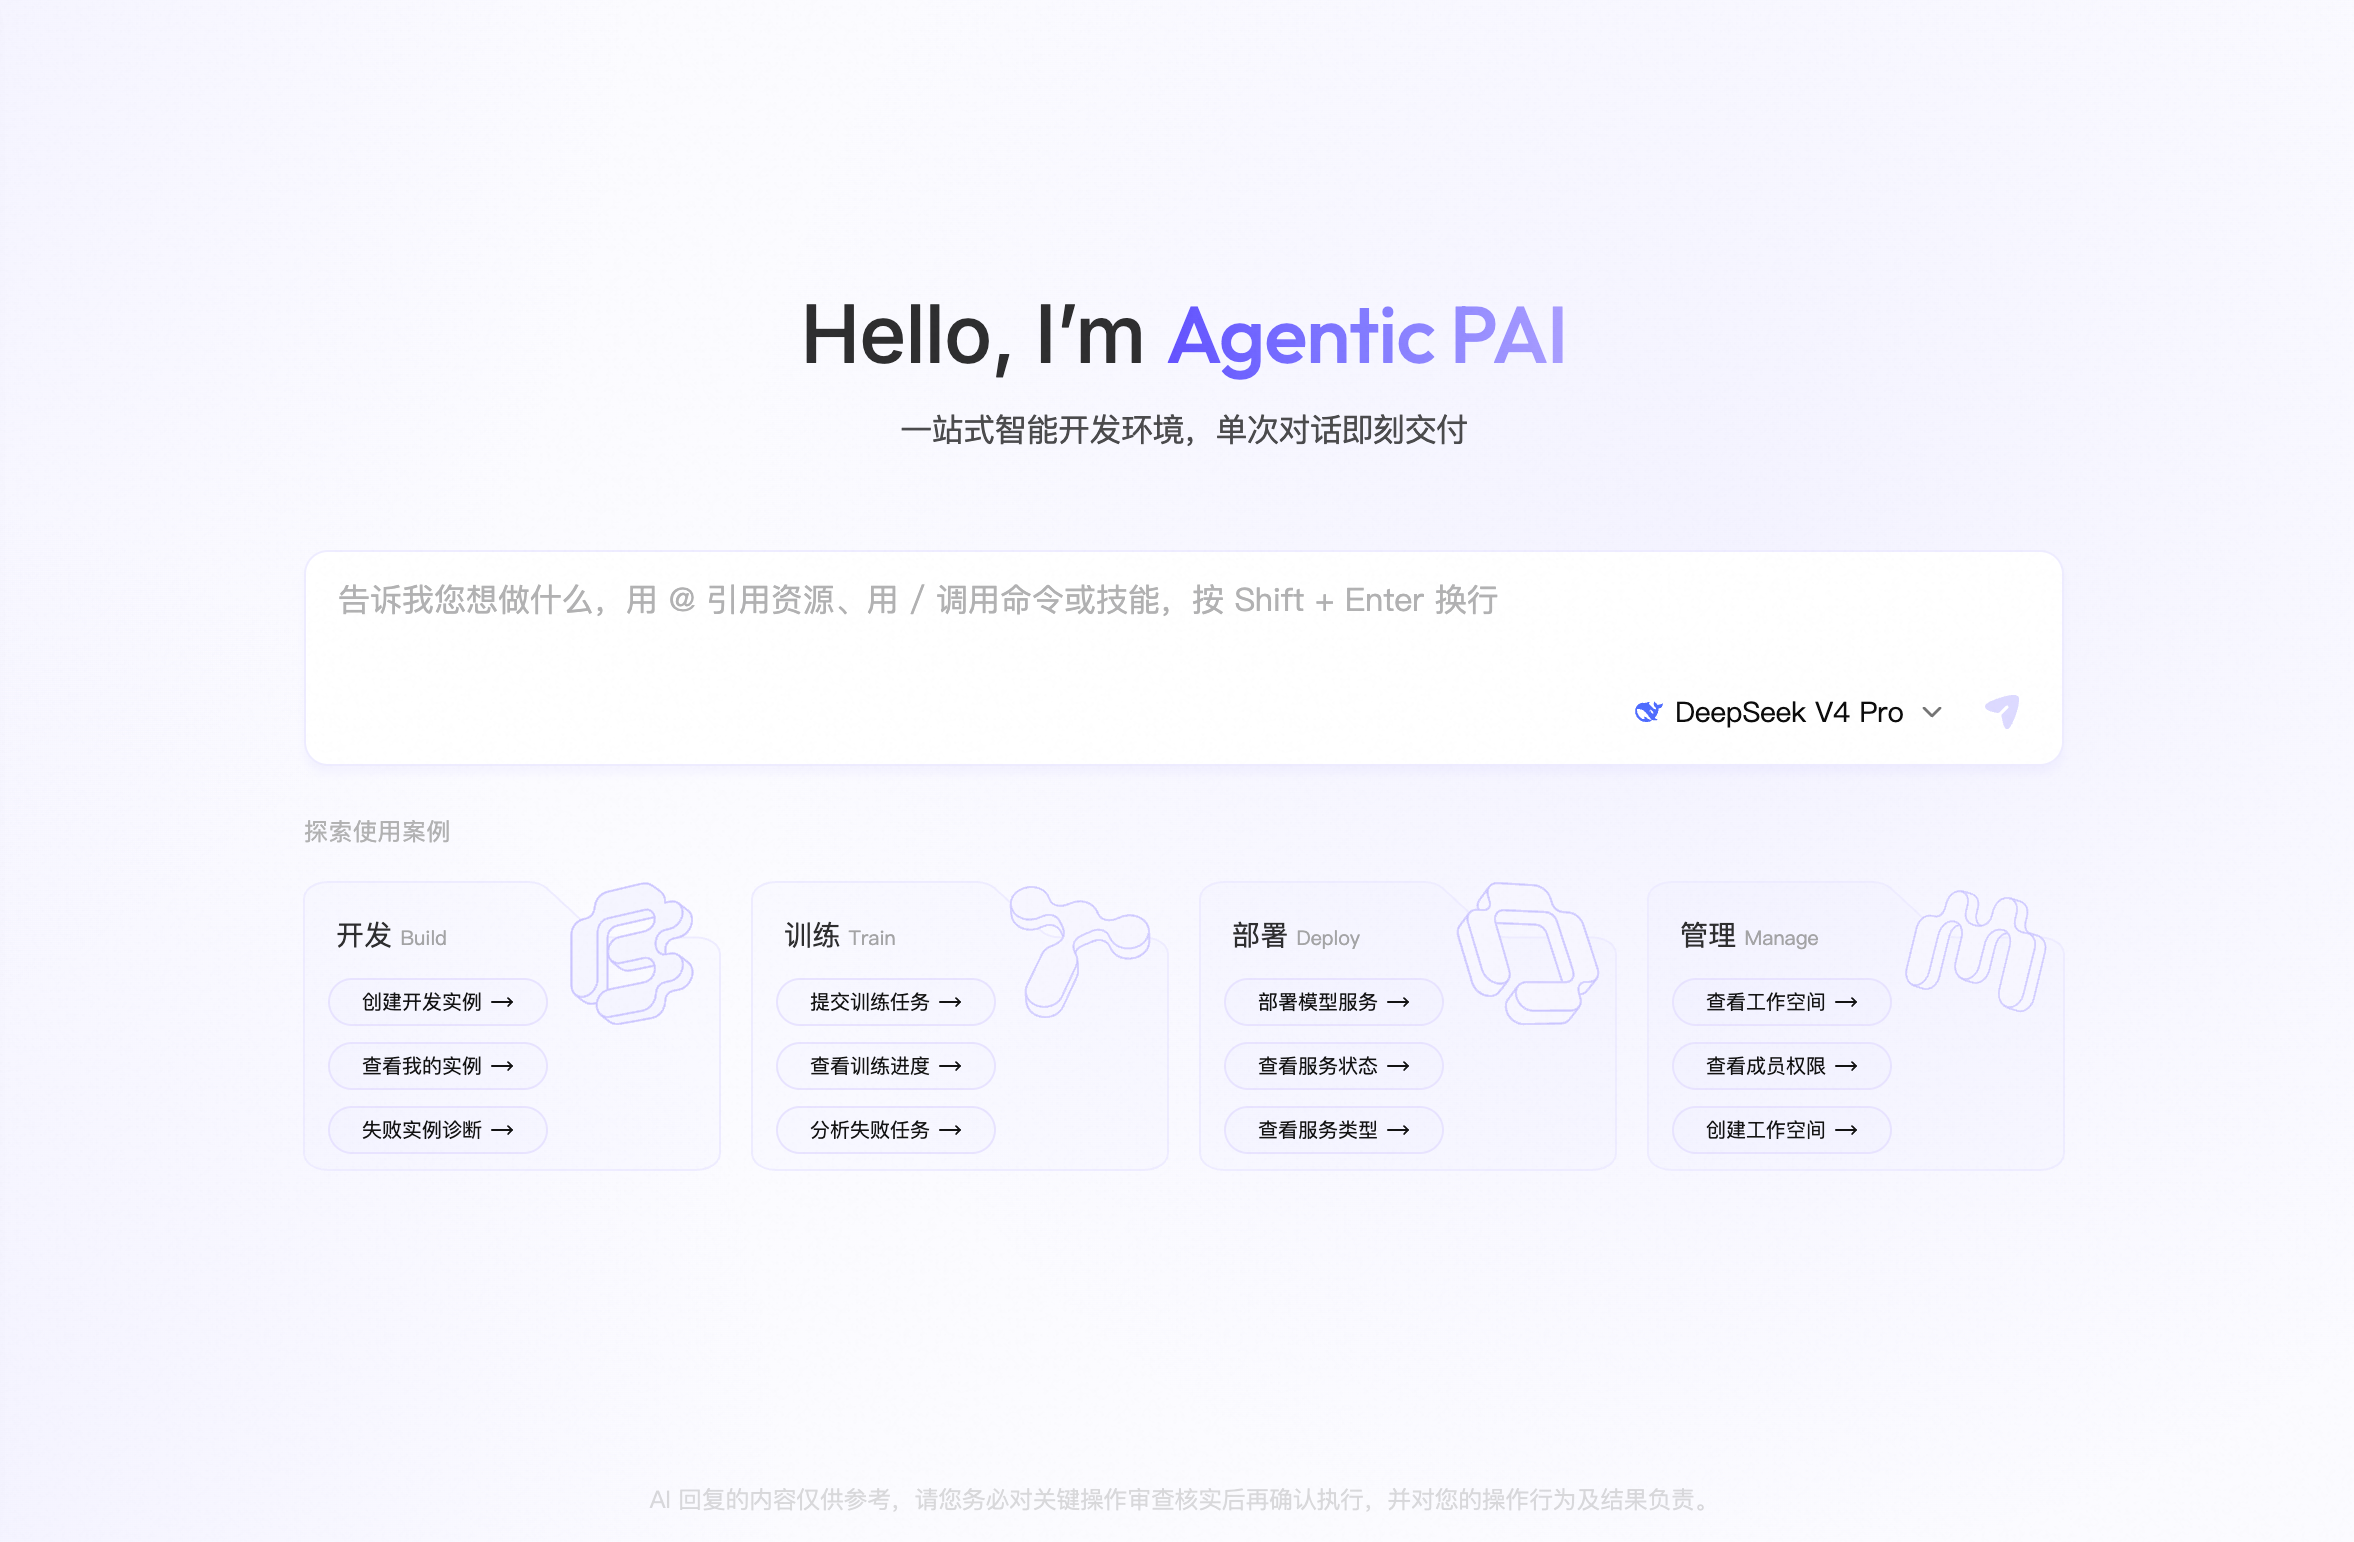
阿里云人工智能平台 PAI 产品负责人黄博远带来了 Agentic PAI 产品发布。顺应 Agent 自主执行的时代趋势,Agentic PAI 支持自然语言驱动模型开发、训练、部署全流程,让平台本身成为能自主规划执行的智能体,实现重复劳动自动化、专家知识普惠化、智慧成果资产化;同时,PAI 可以作为基础设施接入用户的 Agent 中,为其提供训练推理平台能力、领域方法与模型优化支持。
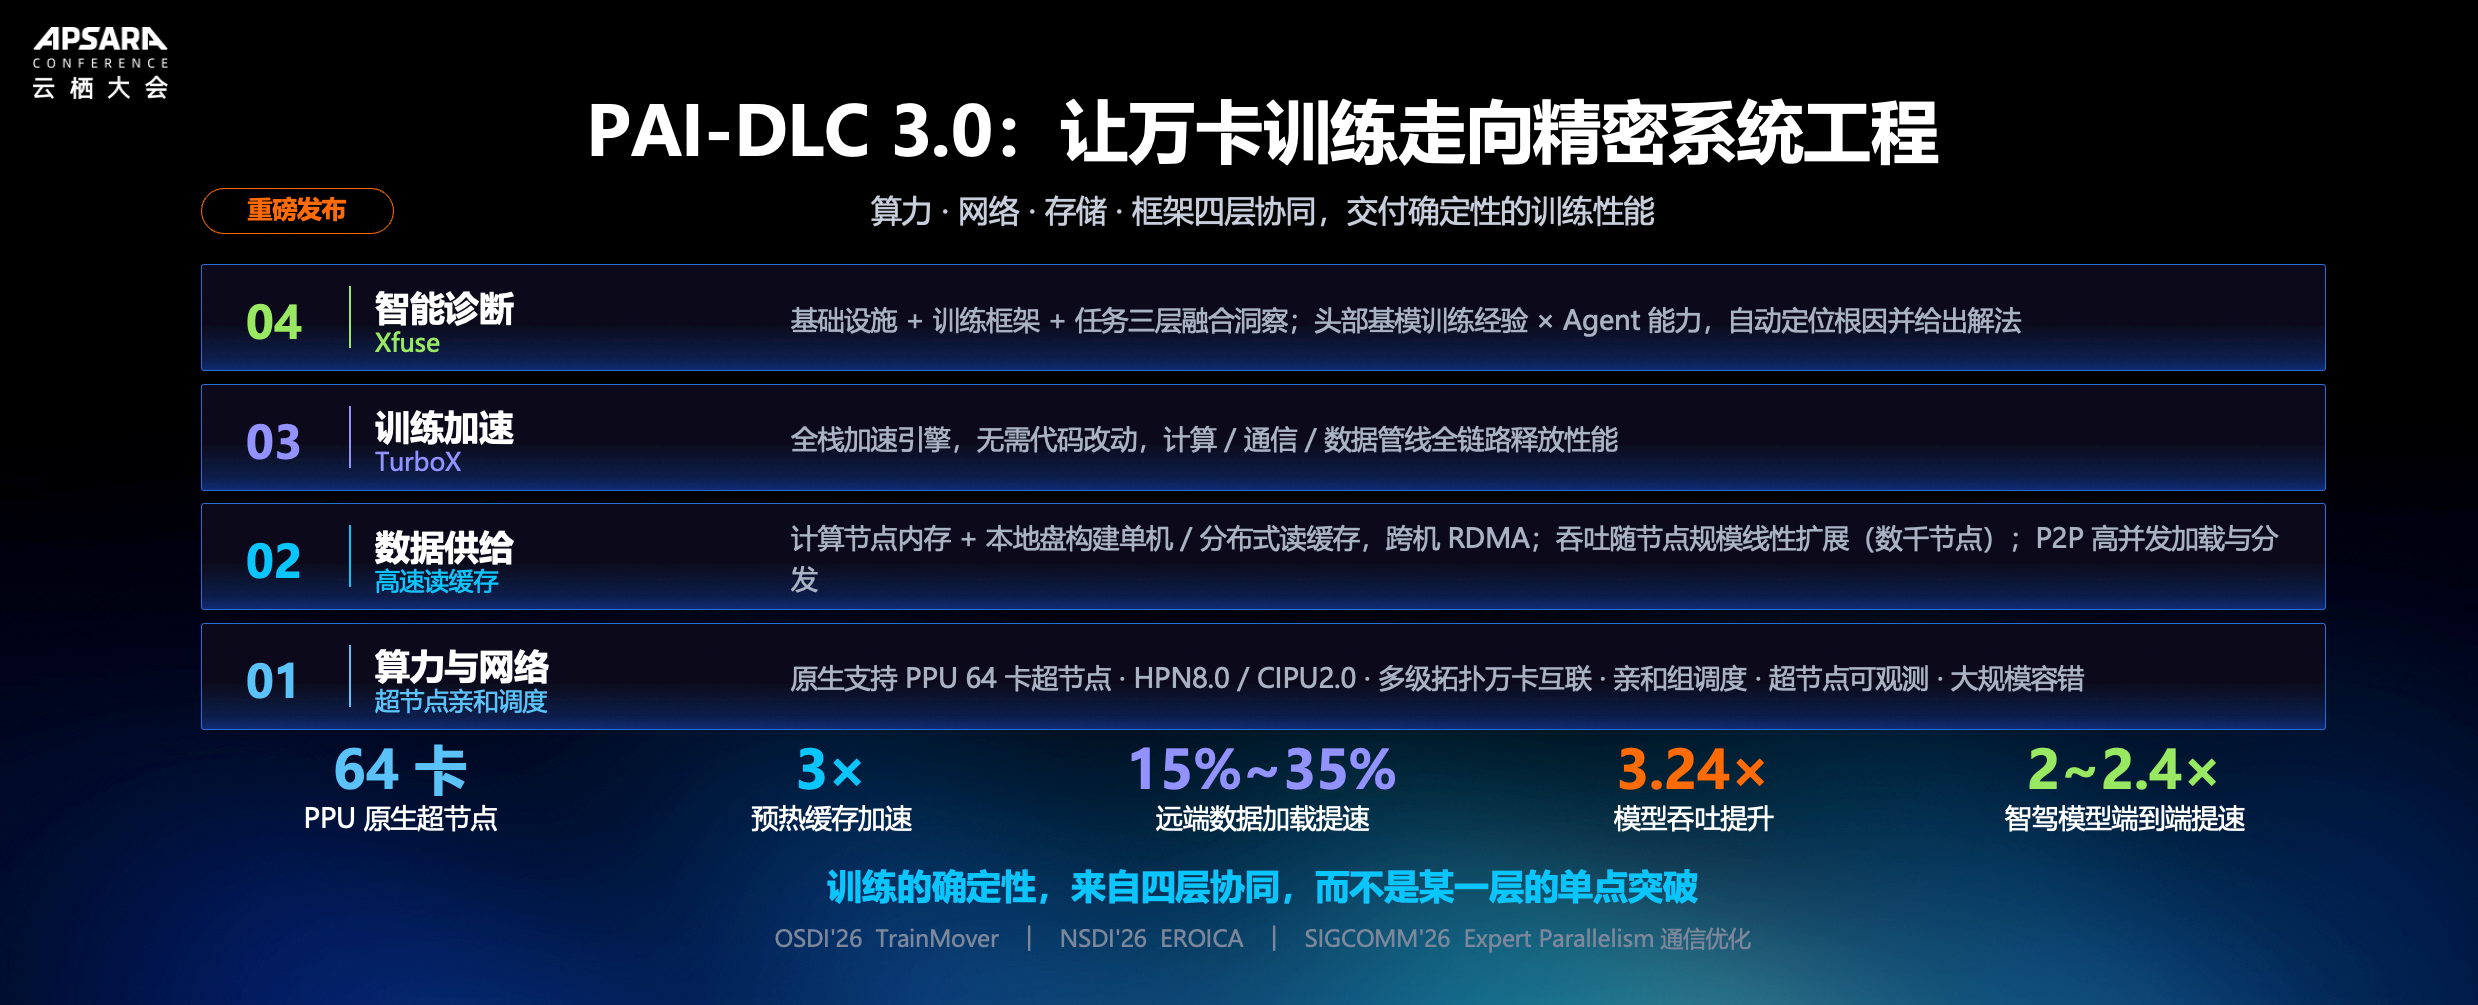
PAI-DLC 3.0:让万卡训练走向精密系统工程
训练的确定性,来源于算力、网络、存储与框架的多层协同,而非单点突破。人工智能平台 PAI 训练服务 PAI-DLC 3.0 通过全栈深度优化实现训练性能的跨越式提升:预热缓存加速达 3 倍,远端数据加载提速最高 35%,模型吞吐量跃升 3.24 倍,智驾模型端到端迭代提速最多 2.4 倍。
·基础设施层:原生支持 64 卡超节点算力资源,并依托 HPN8.0/CIPU2.0 实现多级拓扑万卡互联,通过亲和组调度与超节点全链路可观测保障大规模异构算力集群高效容错;
·数据供给层:基于计算节点内存与本地盘构建单机及分布式读缓存并依托跨机 RDMA 网络,实现数千节点吞吐线性扩展并通过 P2P 高并发加载分发保障高效数据供给;
·训练加速层:PAI-TurboX 全栈加速引擎实现零代码侵入,全链路释放计算、通信与数据管线性能;
·智能诊断层:Xfuse 智能诊断引擎打通基础设施 + 训练框架 + 任务三层融合洞察,融合基模经验与 Agent 能力自动定位根因并给出解法。
支撑 PAI-DLC 3.0 的核心研究成果 TrainMover、EROICA 及专家并行通信优化,均已被 OSDI'26 、NSDI'26 和 SIGCOMM'26 等顶级会议正式收录。
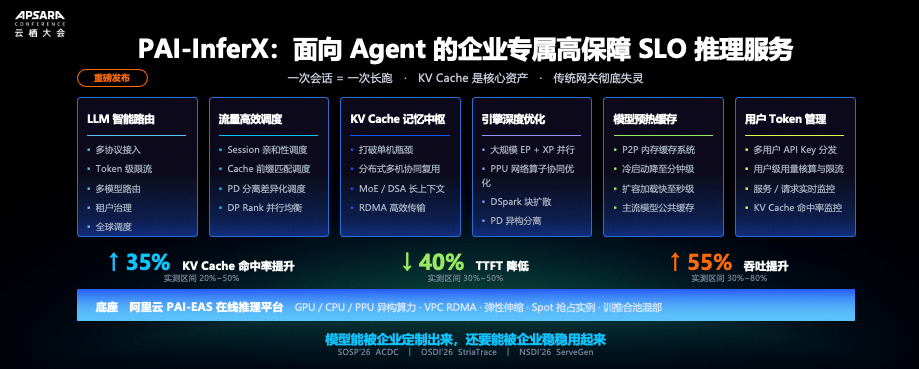
PAI-InferX:面向 Agent 的企业专属高保障 SLO 推理服务
在 Agentic AI 时代,一次会话即是一次长链路执行,KV Cache 已成为决定推理效能的核心资产。 PAI-InferX 通过全栈深度优化,实现推理性能与稳定性的显著提升:KV Cache 命中率提升 35%,TTFT 降低 40%,整体推理吞吐跃升 55%。
·流量侧:依托 LLM 智能路由与流量高效调度,通过 Session 亲和性调度、Cache 前缀匹配调度、PD 分离差异化调度及 DP Rank 并行均衡消除算力碎片;
·状态侧:构建分布式 KV Cache 记忆中枢,依托 RDMA 高效传输实现 MoE / DSA 长上下文秒级加载;
·引擎侧:零代码侵入实现大规模 EP + XP 并行、PPU 网络算子协同优化、DSpark 块扩散与 PD 异构分离。
同时,依托 P2P 内存缓存系统将冷启动降至分钟级,底层无缝对接 PAI-EAS ,实现 GPU / CPU 等异构算力的 VPC RDMA 互联、弹性伸缩、Spot 抢占实例与训推合池混部;并内置用户 Token 管理,覆盖多用户 API Key 分发、用户级用量核算与限流、服务/请求实时监控、KV Cache 命中率监控等功能。
支撑 PAI-InferX 的核心研究成果 ACDC、SinaTrace 及 ServeGen,均已被 SOSP'26、OSDI'26 和 NSDI'26 等顶级会议正式收录。
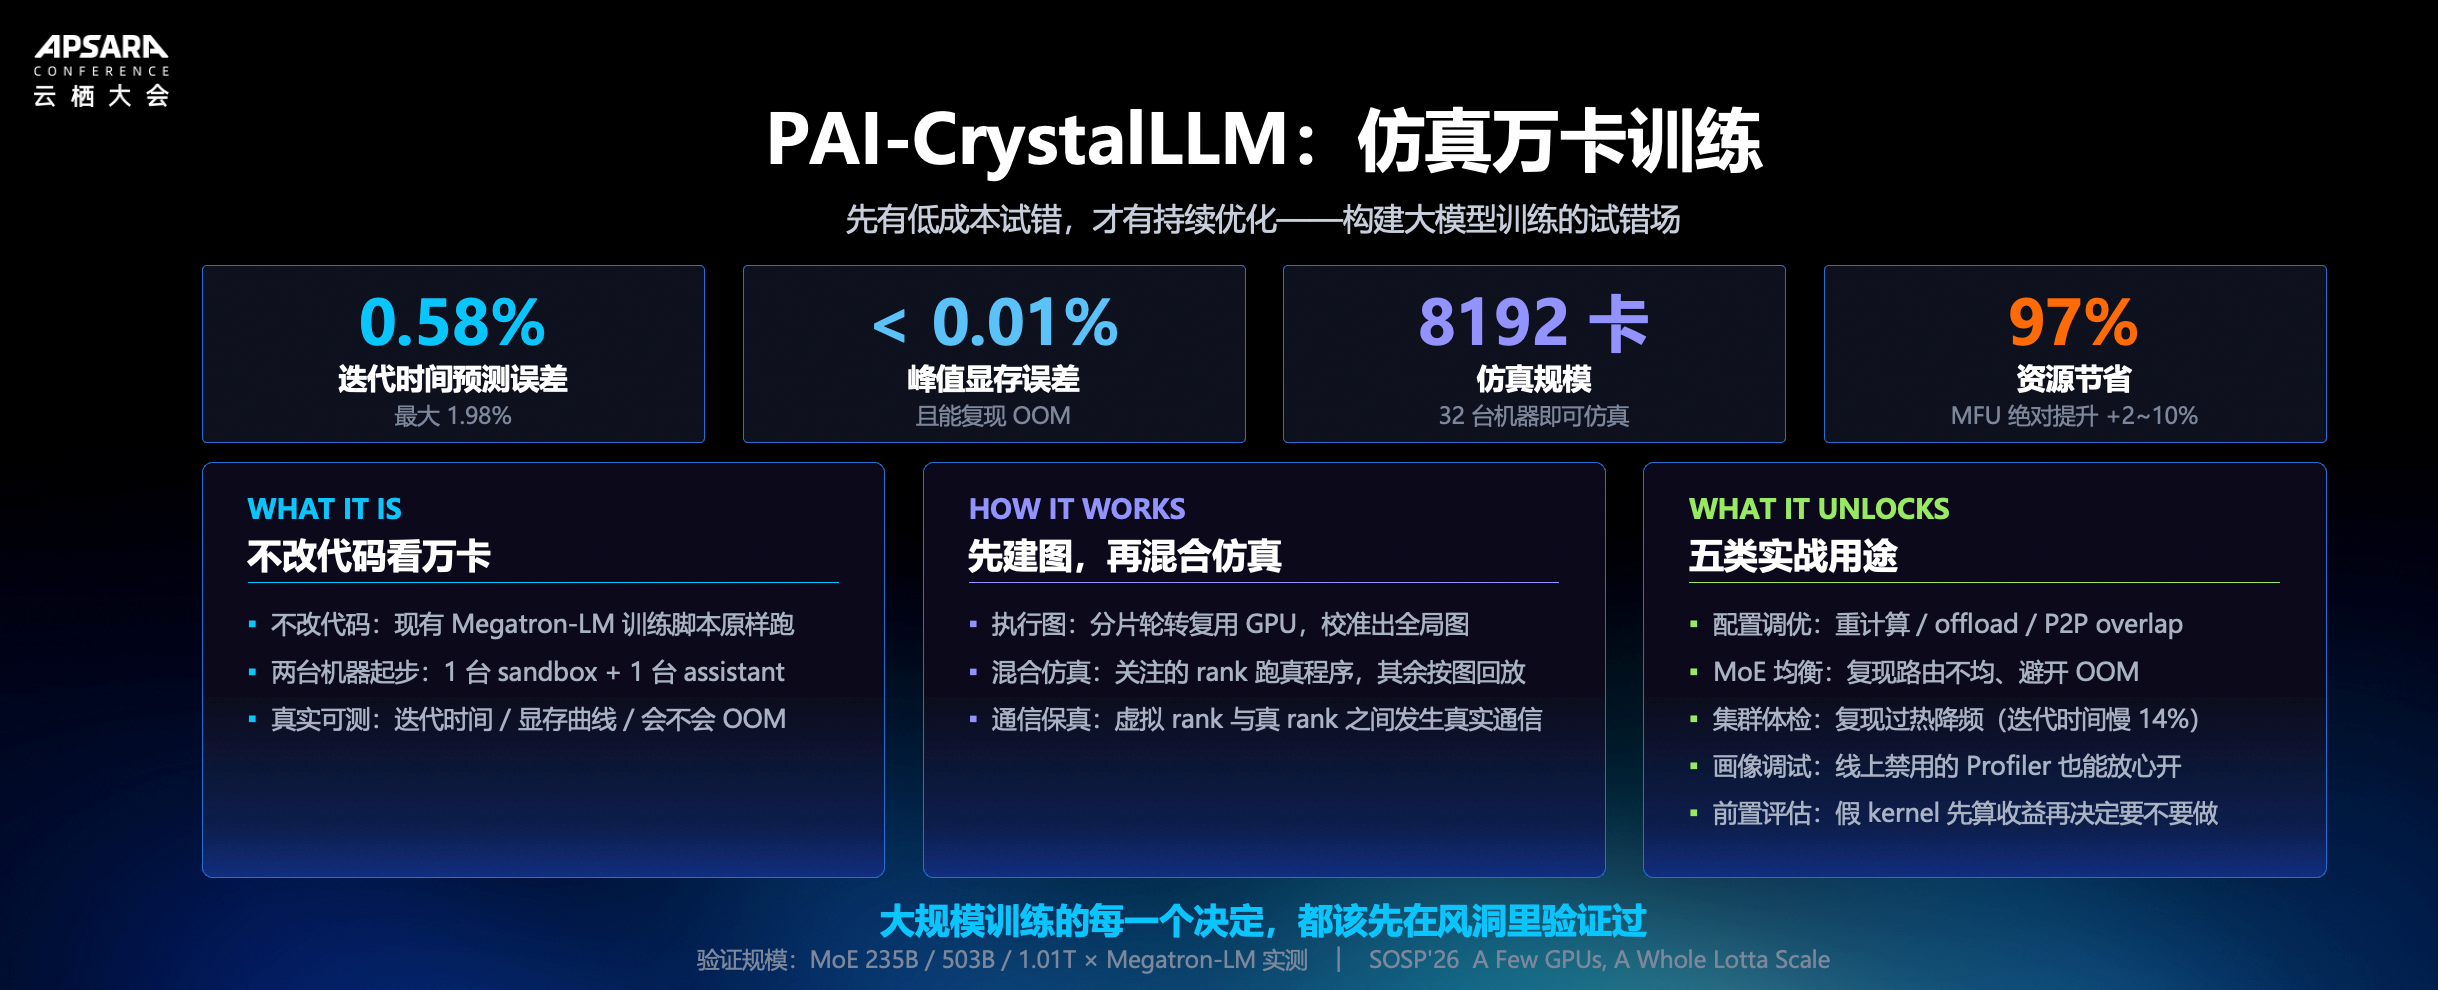
PAI-CrystalLLM + PAI-RLS:从仿真试错到规模化强化学习
随着 Agentic AI 全面迈入 Post-training 与 Test-time 并重的深水区,RL 已成为企业定制 Agent 的主路径,却也是门槛最高、算力消耗最大的一段。面对万卡训练试错成本极高、RL 多角色协同调度极其复杂的系统级挑战,PAI 通过“先低成本试错、后规模化强化”的闭环,让 RL 从可运行真正走向高吞吐、低空转、可规模化。
·PAI-CrystalLLM 高保真模型仿真训练引擎:
面向大模型精细化训练的成本困境,通过在物理机边缘捕捉并重放集合通信,1:1 高保真还原大规模集群,统一兼容主流训练框架与监控工具,仅需 32 卡 GPU 即可虚拟出万卡规模,节省 99% 计算资源;全面覆盖配置调优(调试重计算 / offload / P2P overlap)、MoE 均衡(复现路由不均是否导致 OOM)、集群体检(复现过热降频是否影响迭代速度)、画像调试(开启线上禁用的 Profiler)及前置评估(Kernel 收益预估)五大实战场景。
PAI-CrystalLLM 实测迭代时间预测误差仅 0.58%,峰值显存误差控制在 97% 置信区间,助力 MFU 提升 2%~10%,实现 32 卡虚拟万卡的试错效率。
·PAI-RLS 自研引擎构建高性能RL训练服务:
面向 Agentic RL,PAI-RLS 以自研 Engine 为核心,统一编排 Rollout / Train / Eval / Env 多角色执行,贯通资源调度与全链路观测、智能诊断,实时追踪 Reward / KL / Policy 等核心指标,精准定位 Reward Hacking、KL 漂移/崩溃、GPU 空等、慢样本等 80% 以上常见问题。
PAI-RLS 实测支持 20 万组 Agentic 轨迹并发,环境侧成功率保障达 99.97%,400B 模型 RL 吞吐高达 4.5 万 Tokens/S,实现 5 天强化学习产出一个 SOTA 模型的极佳效率。
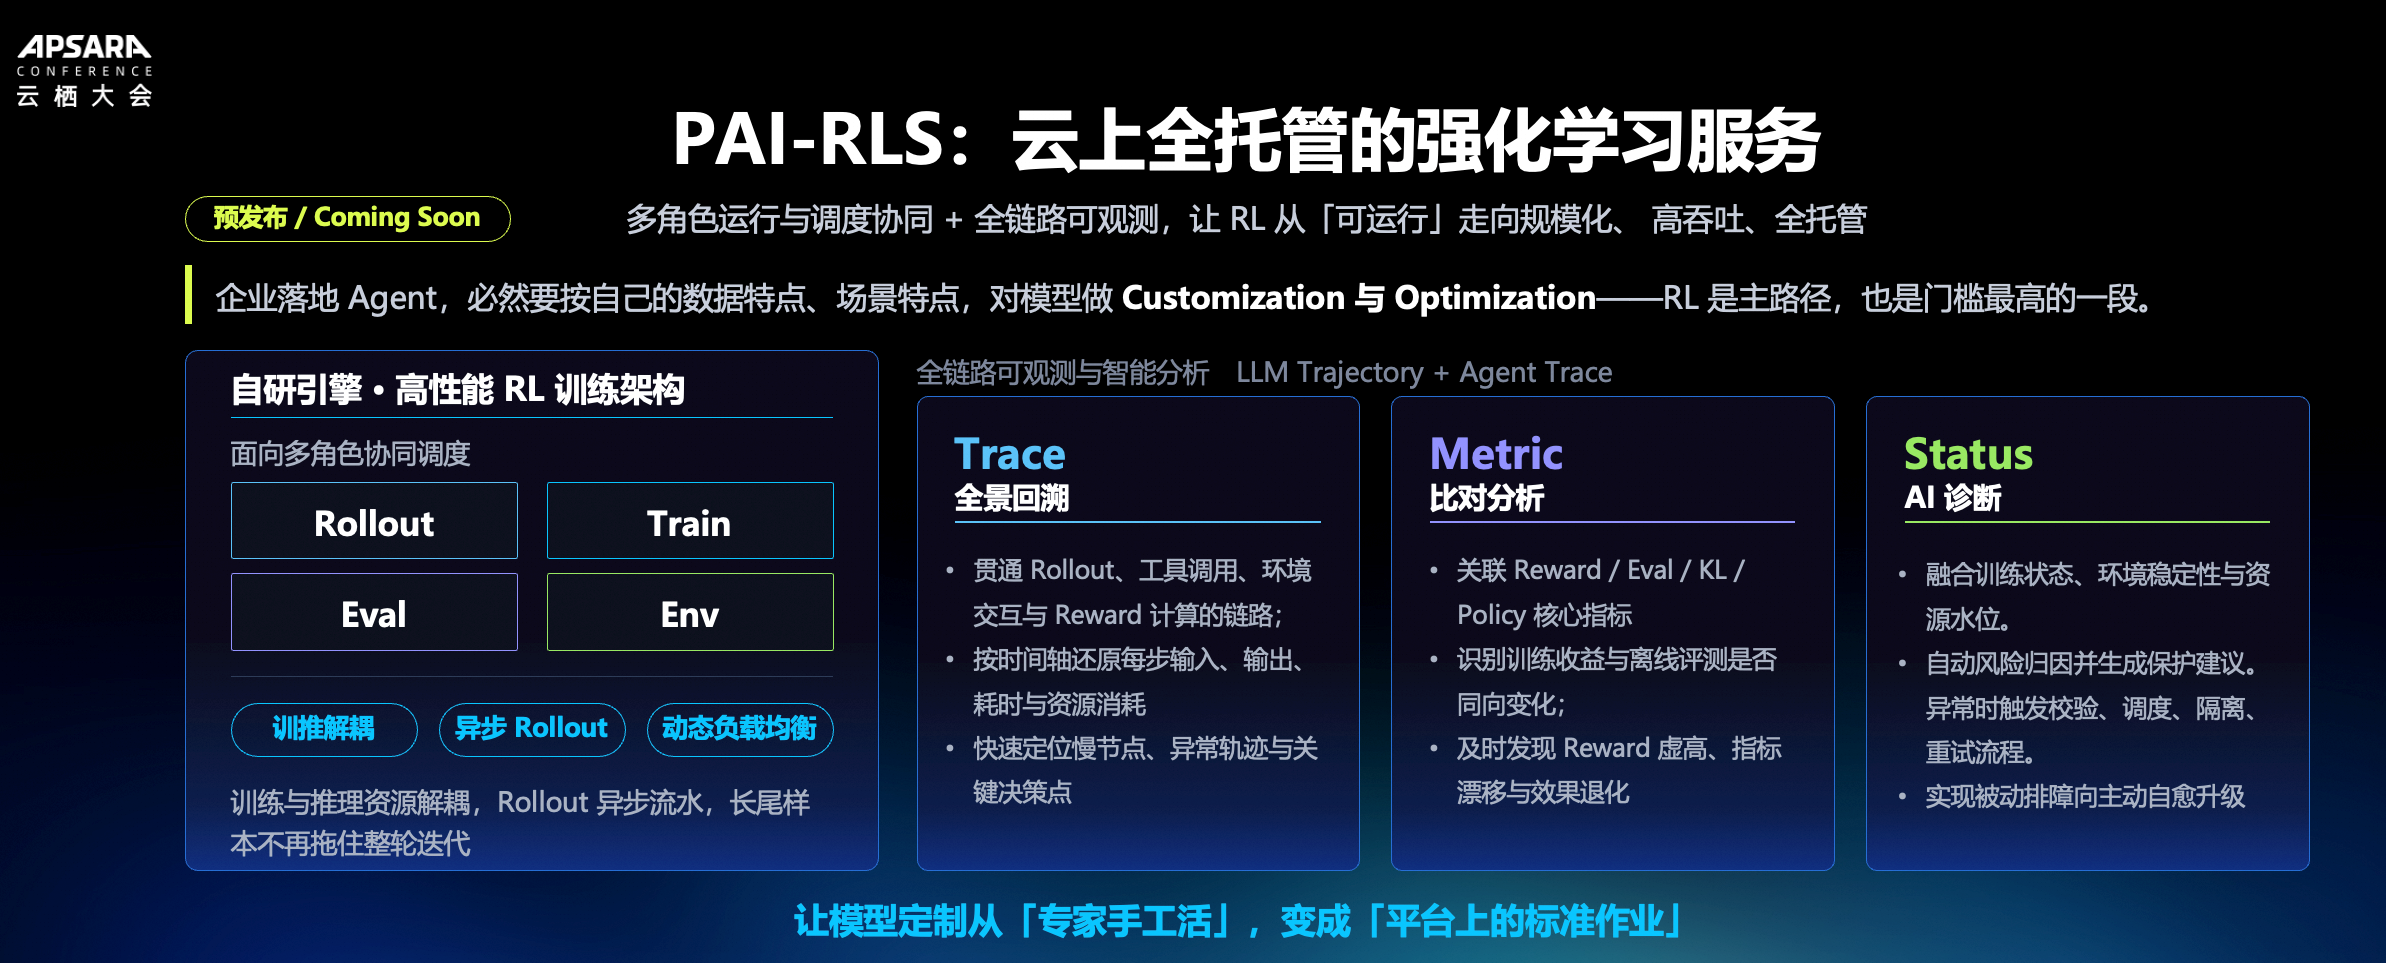
(注:PAI-CrystalLLM、PAI-RLS 功能待发布)
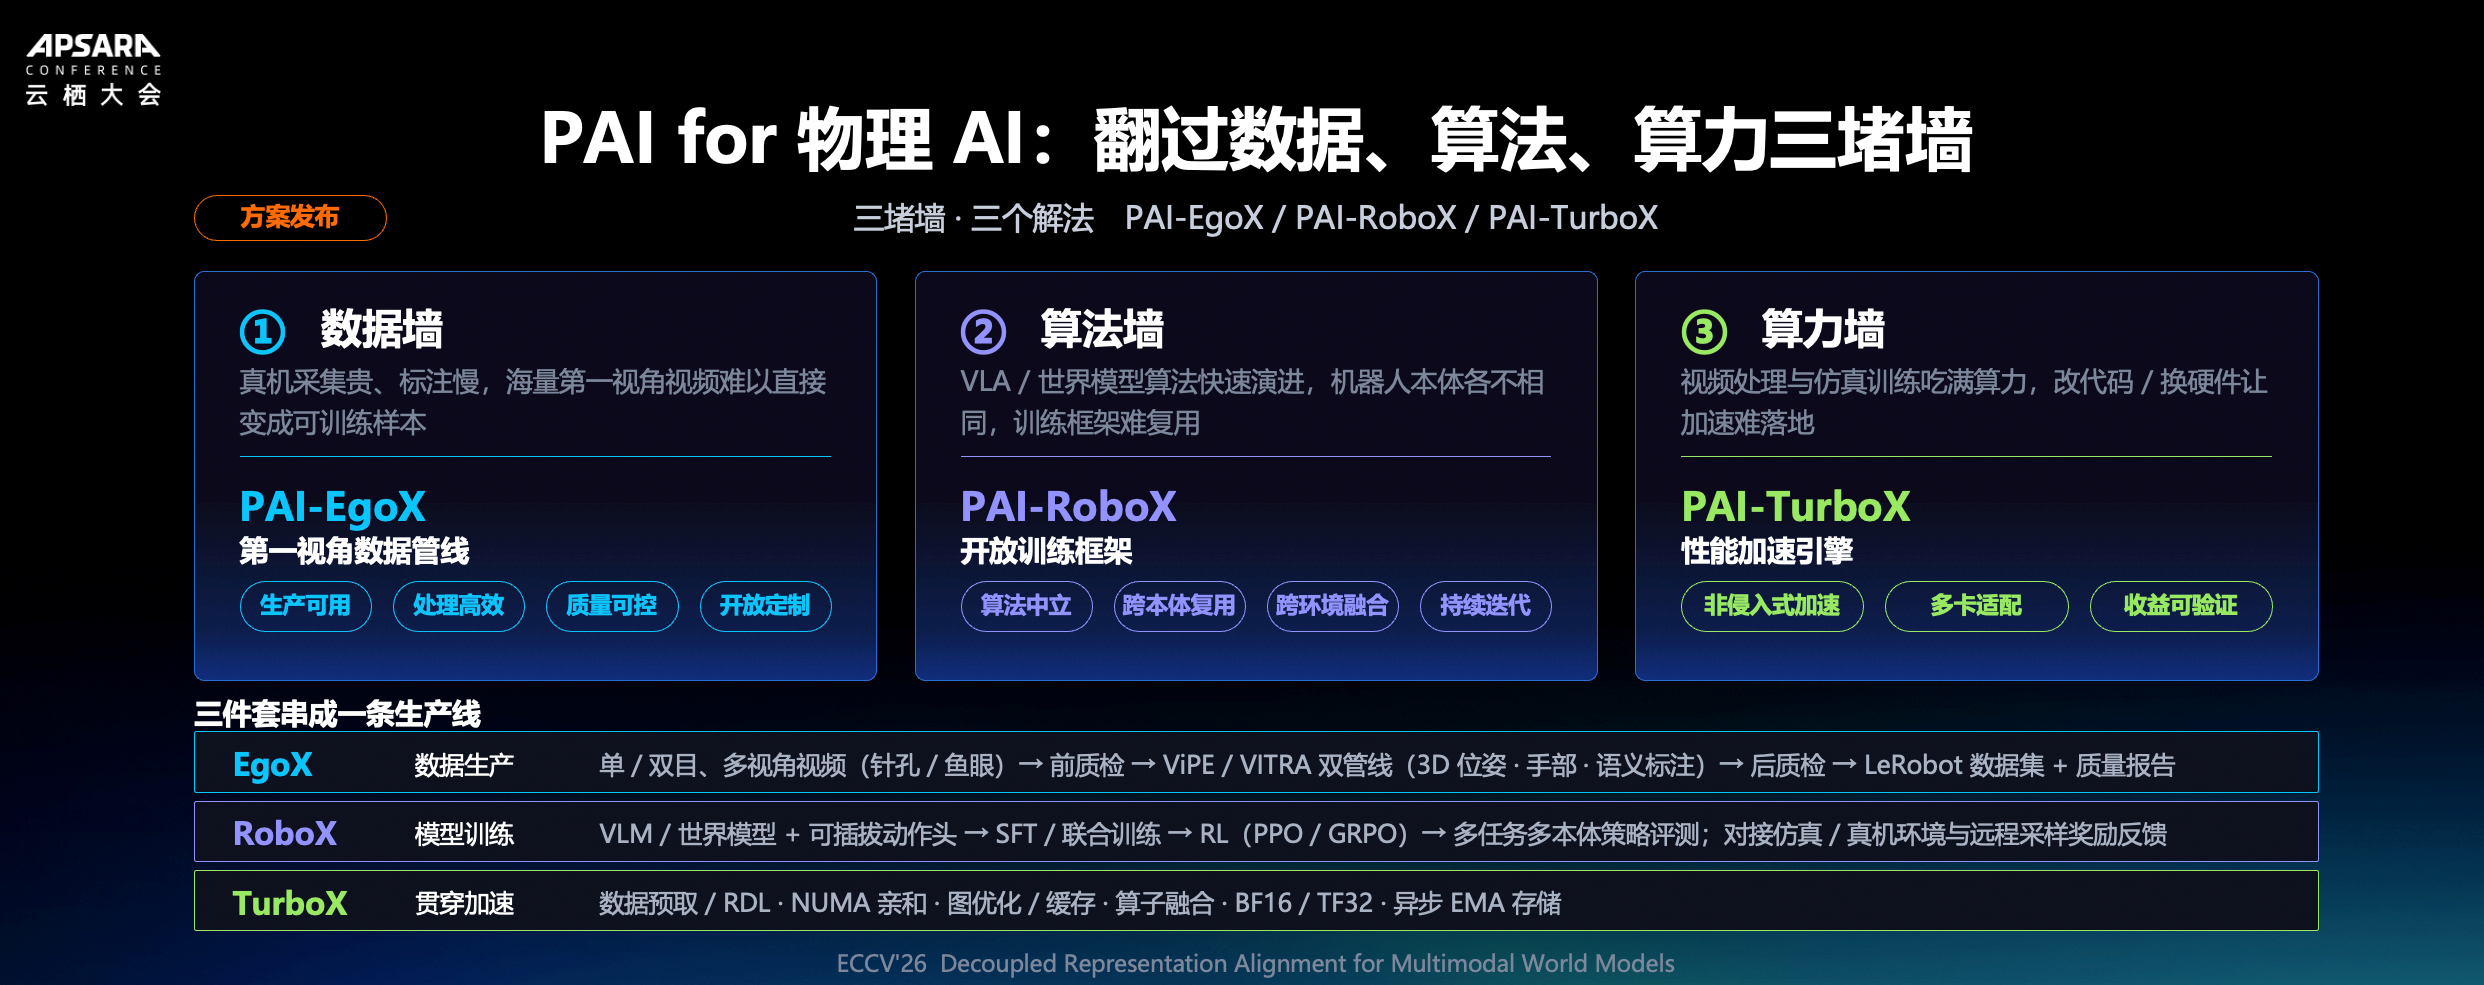
PAI Physical AI 套件:翻过数据、算法、算力三堵墙
随着物理 AI 迈入真实世界大规模部署阶段,具身智能与智驾模型的落地正面临严峻的数据、算法和算力的系统级挑战:真机采集贵、标注慢导致的海量第一视角视频难以直接变成可训练样本;VLA 与世界模型算法快速演进,但机器人本体各不相同导致训练框架难以复用;视频处理与仿真训练吃满算力,改代码换硬件让加速难落地。
PAI 正式发布 Physical AI 全栈解决方案,通过 PAI-EgoX、PAI-RoboX、PAI-TurboX 三大核心引擎,彻底翻越这三座大山。
·PAI-EgoX 数据生产:打通第一视角数据管线,支持单/双目、针孔/鱼眼、多视角视频数据处理,支持 ViPE / VITRA 双管线,结合前后质检,输出高质量数据集;
·PAI-RoboX 模型训练:提供 VLA 模型和世界模型训练框架,支持监督微调、强化学习和评测,支持真机、仿真和第一视角数据联合训练,让不同来源数据共同服务模型学习;
·PAI-TurboX 算力优化:PAI-TurboX 通过数据加载、调度、编译、算子、精度、存储六大维度的优化,为大规模训练任务加速,充分释放算力。
使用 PAI Physical AI 全链路套件后,一轮 VLA 模型完整迭代的开发周期可从自建的约 2~3 个月缩短至约 2~3 周,预计缩短约 75%。PAI Physical AI 研究成果被 ECCV'26 会议收录。
Agentic PAI:让每个用户都拥有一个 AI Infra 专家
Agentic PAI 用自然语言对话承接模型开发、训练、部署全流程,让 AI 基础设施更易用,将繁琐的平台操作转化为自然语言驱动的自动化执行。
·实验编排与执行:支持自然语言驱动的目标拆解与批量参数展开(如自动克隆基线并生成 3 种学习率 × 2 种 Batch 的 6 组独立实验),每 30 分钟动态检查资源并空闲补位;
·异常诊断:可一句话拉取全 worker 日志或近 1 小时指标,自动区分先发与连带异常并给出排查建议;
·成果复用:将运行轨迹与证据经评估验收后,沉淀为可复用的 Skill、任务模板与 A2UI 可视化看板;
·安全与治理:提供变更操作二次确认、高风险动作审批、定时任务主动推送(钉钉/飞书)及全域资源巡检与成本洞察能力。
Agentic PAI 深度串联了 AI 工程全链路的核心角色,让算法工程师专注模型调优、推理工程师告别跨页运维、资源管理员实现自动化巡检、团队管理者实时掌握成本趋势。使用 Agentic PAI ,所有用户均可成为专业的 AI 工程师。
同时,除 Agentic PAI 外,同样支持把 PAI 接入你的 Agent,为 Agent 提供平台能力、领域方法与模型优化支持。当效果瓶颈来自模型时,以评测定位问题,再按需微调或蒸馏,为 Agent 提供全方位模型侧优化能力。
丰富的行业实践
PAI 作为 Agentic AI 时代的 AI 工程化平台,和行业头部客户一起,已经沉淀出一批产业实践。
无尽前延使用人工智能平台 PAI,开展科研大模型(AI for Science)的预训练与后训练。依托 PAI 的分布式训练和开发调试的全链路能力,MoE 科研基模、Coder 代码模型、VL 多模态模型等各类模型均可快速完成训练适配与迁移,实现了对其自研蒸馏算法体系下三条模型线并行研发的高效支撑,大幅提升了科研大模型的开发、训练与迭代效率。
大众 CARIAD 团队依托人工智能平台 PAI 成熟高效的模型在线服务,构建包含 harness 层和业务应用层的 AI 系统。综合 LLM 支持泛化和本体支持严谨的符号推理的能力,利用 LLM 建立知识骨架,加速积累企业知识资产,结合版本管理,使知识骨架成为工程化 AI 系统的核心组件。不断拓展车企内部的业务领域,持续突破技术难题,支持业务稳定运行及提效。以整车故障归因为例,深入介绍大众内部搭建的AI能效系统平台,带来针对车企领域企业工程化的 AI 提效落地。
小米使用人工智能平台 PAI 将广告推荐系统重构升级。当算法遇到基础设施天花板,小米和 PAI 团队一起,完成广告业务训推底座迭代,把推荐底座升级为可规模、可序列、可实时。模型迭代周期大幅缩短,业务指标同步得到改善,并迈向以生成式推荐为核心的 LLM4Rec。
费莫一科技与人工智能平台 PAI,共同探索具身智能的研发,打造面向开放动态真实世界的 Physical Agent,将跨场景移动与操作连接起来,并根据现场变化持续行动,推动复杂目标达成。
穹彻智能基于 PAI 和 MaxCompute、Hologres、DataWorks 等阿里云产品,搭建云上 Umi Data + AI Pipeline,实现数据处理全流程自动化,整体吞吐提升超过 10 倍,模型训练效率提升约 50%。
流形空间通过人工智能平台 PAI,加速数据处理、模型训练与推理部署等环节。借助 PAI 平台的大规模分布式训练能力、算子级性能优化与稳定的资源调度体系,一同推进世界模型创新。
从训练、推理到强化学习与物理 AI,PAI 在这一年把 AI 基础设施整体推进到下一代,交付的不再是算力,而是能力:客户拿到的是一条可复用的生产线,专家的经验被沉淀为平台的标准作业,基础设施的边界也从数字世界深入到物理世界。
面向 Agentic AI,人工智能平台 PAI 不断迭代,为模型与智能体的创新提供坚实基础。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)