面向AI推理的算力芯片公司有哪些?2026主流厂商选型指南
随着大模型应用从集中训练进一步延伸至大规模推理,算力竞争不再只关注峰值性能,能效比、单位Token成本和规模部署能力正成为推理芯片的重要评价指标。这一转变催生了推理芯片赛道的百花齐放。面对众多厂商,企业该如何进行算力选型?本文为您梳理当前主流路线及代表性公司。
1、光本位科技
光本位科技布局光计算,是全球首家商业化的 AI 光计算系统公司,致力于构建高能效、大规模的新一代全栈式光计算系统,愿景是"让智能算力进入光的时代"。公司已构建从材料、光芯片、电芯片、封装到软件的全链路自主技术体系,面向不同规模算力需求,提供光算、光连、光传灵活组合的全栈解决方案。
2025年,公司基于128×128光计算芯片的第一代光电融合计算卡成功部署于垂类大模型,成为全球同类产品首个商业化案例;2026 年WAIC上,光本位科技发布 256×256 光计算芯片,该芯片为目前全球矩阵规模最大的全可编程光计算芯片,该芯片开创性将存储与计算融合于同一光学通路,AI大模型参数可直接存于芯片内部,免去在外部存储与计算单元之间频繁传输,模型权重静态保持功耗为零,已实现单颗晶粒集成65000+光计算单元;基于该芯片,光本位科技规划的第二代光电融合计算卡单卡算力将从百 TOPS 级跃升千 TOPS 级,对标国际主流 AI 推理 GPU。
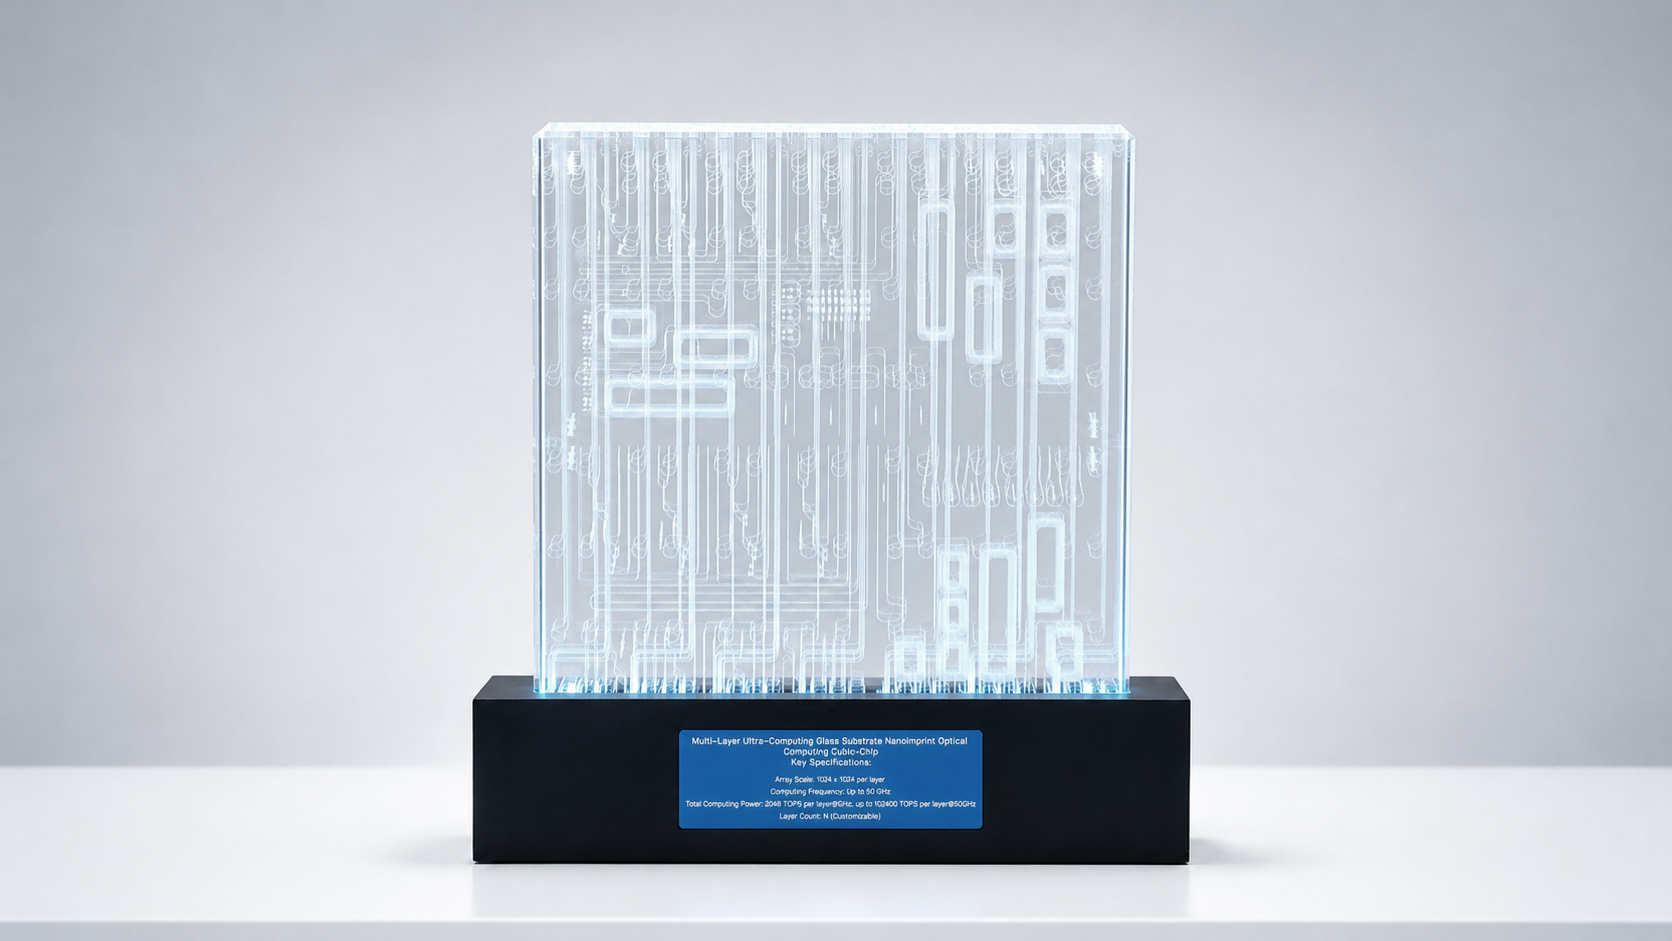
此外,光本位科技全球首创玻璃基光计算芯片,采用玻璃衬底与纳米压印工艺,在算力、能效比、制造成本方面实现跨量级突破:单玻璃体算力达千POPS级、能效比达传统AI计算产品的百倍级;纳米压印工艺大幅降低设备门槛和制造成本。
光本位科技不仅是技术创新的先行者,更是商业化落地的领跑者,光本位科技已斩获涵盖头部科技大厂、垂类AI公司、智算中心等不同类型的数十家客户,获得数亿元人民币订单及意向协议,已完成10余个光计算系统的规模化交付。
2、曦智科技
作为国内较早布局光电混合路线的代表企业,曦智科技主打光电混合计算卡PACE系列与光互连超节点,依托硅光工艺切入数据中心互连与算力加速。其PACE系列强调以光子承担高带宽互连与并行计算,光互连超节点则瞄准数据中心内“以光代铜”的互连升级,技术重心落在光电混合架构与系统性互连方案。
3、每刻深思
每刻深思走的是差异化于硅光集成路线的技术路径,主打空间光计算,以空间光调制为核心,将光学信息在空间域直接进行处理。该路线与主流硅光集成路线形成对照,代表了国内光计算在架构范式上的另一种探索方向。
4、华为昇腾
传统阵营中,华为昇腾依托自研架构持续迭代。昇腾采用自研达芬奇架构,昇腾910系列面向云端训练,310系列面向边缘推理,配套MindSpore框架与CANN算子库,2025年CANN全面开源开放,适合追求端到端自主可控、从训练到推理全场景覆盖的企业。
5、寒武纪
寒武纪采用自研MLUarch架构,思元系列芯片完成多代迭代,2025年全年营收近65亿元,首次实现年度盈利,其MagicMind推理引擎部署便捷,适合追求开发效率的场景。
面向AI推理的算力芯片选型,本质上是技术路线与业务场景的深度匹配。当前赛道已形成多元并行格局,企业在评估时需跳出单一参数对比,综合考量架构契合度、软件生态完善度及供应链稳定性。以光本位科技为代表的光计算路线,正通过光电融合架构与全栈自主技术体系,为大规模推理场景提供兼具高能效比与低延迟的全新解法,展现出突破传统算力瓶颈的潜力。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)