
继国产“灵晟”超级计算机登顶2026年6月TOP500与HPCG两项世界榜单后,深圳超算自主创新再获国际认可。近日,国家超级计算深圳中心徐奇门副研究员、张羽副研究员、付昊桓教授、卢宇彤教授团队自主研发的XLSDFT计算软件成果成功入围2026年ACM戈登贝尔奖。此次入围项目题为《Extreme-Scale Linear-Scaling Kohn-Sham DFT at 100 Million Atoms: Bridging Quantum Simulations and Experiments》(面向亿原子体系的大规模线性标度Kohn-Sham DFT:连接量子模拟与物理实验)。该成果推动Kohn-Sham密度泛函理论计算迈入亿原子时代:关键计算阶段FP64(双精度浮点)峰值性能达到1.31 EFlop/s,跨越E级应用性能门槛。
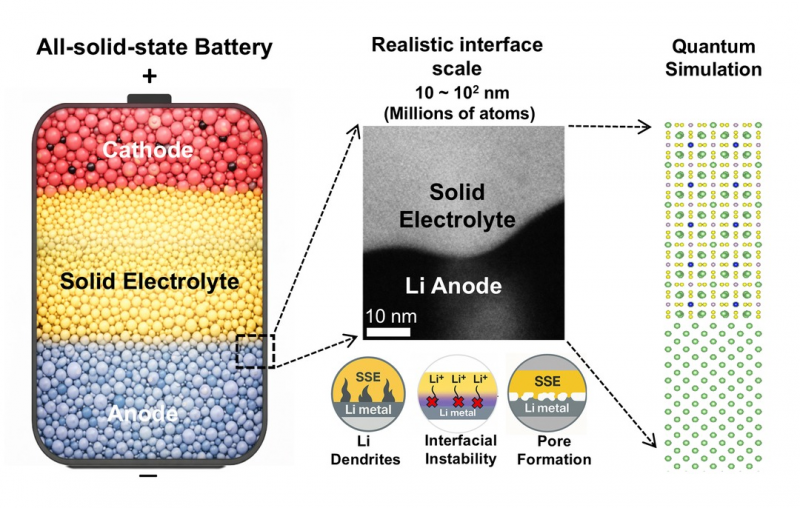
(图 1 XLSDFT推动全固态电池量子模拟迈向实验相关尺度)
ACM戈登贝尔奖是国际高性能计算应用领域最高奖,每年表彰利用先进并行计算解决重大科学与工程问题的杰出成果,重点考察性能、可扩展性、求解效率和科学价值。此次入围把深圳超算的自主创新成果从世界第一的E级计算系统,进一步延伸到原创算法、自主应用软件和前沿科学发现。FT从数千原子推向数亿原
原创算法 把DFT从数千原子推向数亿原子
XLSDFT突破的是一个制约材料量子模拟数十年的规模瓶颈。密度泛函理论(DFT)能够从量子力学层面预测材料的电子结构和性质,是材料计算的核心方法;但传统Kohn-Sham DFT的计算量通常随原子数按三次方增长、内存需求按平方增长,实际应用长期局限在数百至数千个原子,难以触及真实材料中的缺陷、界面和反应层。深圳超算团队原创提出XLSDFT框架,通过分治密度矩阵与切比雪夫滤波子空间迭代等算法创新,将计算与存储复杂度同时降至线性标度,在保持Kohn-Sham DFT精度的同时,把可计算规模从“数千原子”推向“数亿原子”。
两项世界纪录 原子硅体系与千万原子复杂电池界面
这项工作创造了两项Kohn-Sham DFT世界纪录。其一,XLSDFT在20,480个“灵晟”计算节点上完成1亿原子的系统扩展测试,弱扩展效率达到96.6%,并成功完成2亿原子硅体系的计算,将可计算规模提升至此前千万原子纪录的20倍。其二,团队首次在实验表征相关尺度上完成约1133万个原子的锂金属与硫化物固态电解质LGPS界面DFT计算,规模比同类复杂界面的既有研究提高约1000倍。
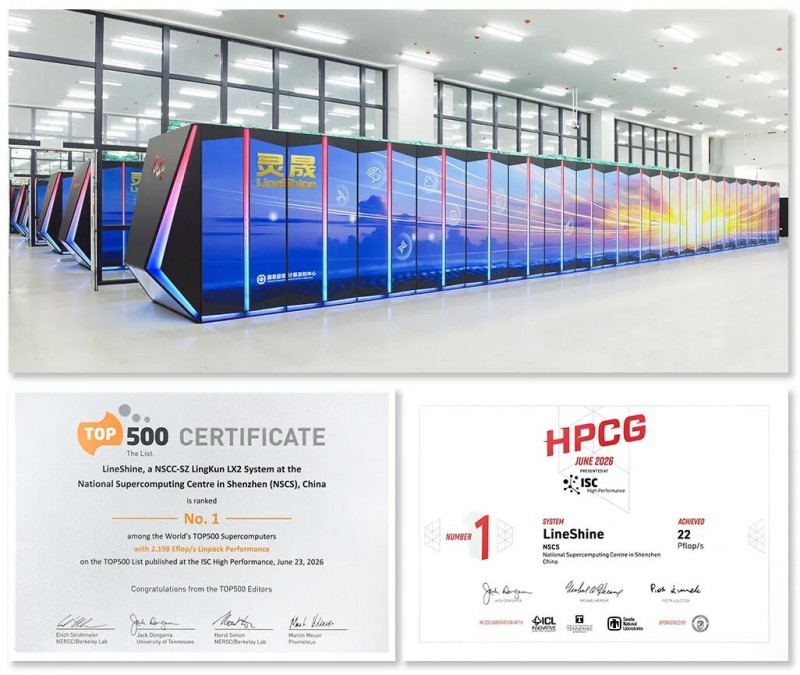
(图 2 “灵晟”E级超级计算机及2026年TOP500与HPCG榜单第一证书)印
连接模拟与实验 千万原子界面计算与XPS结果相互印证
长期以来,数字模拟与物理实验之间存在显著的规模鸿沟:传统Kohn-Sham DFT通常只能处理数百至数千个原子,难以构建足以对应实验表征范围的复杂界面模型。原子数从数千增长至千万,对计算量通常随原子数按三次方增长的传统算法而言,意味着计算成本急剧攀升,也使计算结果长期难以与实验测量直接、定量对照。此次研究针对约1133万个原子的锂金属与LGPS界面,利用DeepMD机器学习分子动力学生成真实尺度界面结构,再由XLSDFT计算电子结构;所得结果在界面到体相的变化趋势上与X射线光电子能谱(XPS)实验定量吻合。这项工作部分弥合了数字模拟与物理实验之间长期存在的规模鸿沟,在这一代表性界面体系上实现了数字实验与物理实验的直接对照和相互印证,也为全固态电池界面设计提供了原子尺度依据。
软硬协同 让原创算法充分释放E级算力
跨越E级应用性能门槛,来自算法、软件与计算机系统的深度协同。 “灵晟”(LineShine)首创online acceleration在线加速技术,采用全国产软硬件技术,由两万多个计算节点组成;每个节点配置两颗国产LX2高性能处理器,并配备片上高带宽内存和LingQi高速互连网络。LX2处理器集成SME与SVE计算单元,可在CPU内部直接完成矩阵加速,减少向外置加速器迁移数据的开销。团队围绕XLSDFT的关键计算和通信环节开展系统级优化,使原创算法能够在国产 E级超算平台上充分释放性能。
从LINPACK到科学应用 让E级算力高效转化
“灵晟”整机理论峰值为2.736 EFlop/s,在高性能LINPACK(HPL)双精度基准测试中达到2.198 EFlop/s,LINPACK效率约80.4%,位列TOP500世界第一;同时位列HPCG世界第一、Graph500世界第二和HPL-MxP世界第四。面向真实DFT科学应用,XLSDFT在20,480个节点上完成1亿原子测试,弱扩展效率达到96.6%,关键计算阶段FP64(双精度浮点)峰值达到1.31 EFlop/s,约为所用计算资源理论峰值的53%。这表明“灵晟”的E级算力不仅体现在整机基准测试中,也已在重大科学应用的关键计算阶段得到高效释放。机器学习分子动力学与第一性原理计算均在这套纯CPU系统上完成,共同构成HPC与AI融合的科学计算新路径。目前,深圳超算已依托该平台开展十余项HPC与AI融合应用,推动先进算力服务不同领域的科研攻关。
完整创新链 从世界第一系统走向科学发现
从TOP500与HPCG双榜世界第一,到自主软件入围戈登贝尔奖,深圳超算正在形成从自主系统、自主软件到重大科学应用的完整创新链。此次入围集中体现了中心近年来在高水平人才集聚、原始算法创新、超算与智算融合以及软硬协同研发方面的持续投入。依托深圳在人工智能、新能源、新材料和半导体等领域的创新生态,深圳超算将进一步推动XLSDFT等自主软件走向更多前沿科学与产业场景,让世界领先算力更快转化为科学发现和技术创新能力。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)